Blog · 11. 8. 2026
Simultánní tlumočení s AI: Když stroj poslouchá, překládá a mluví
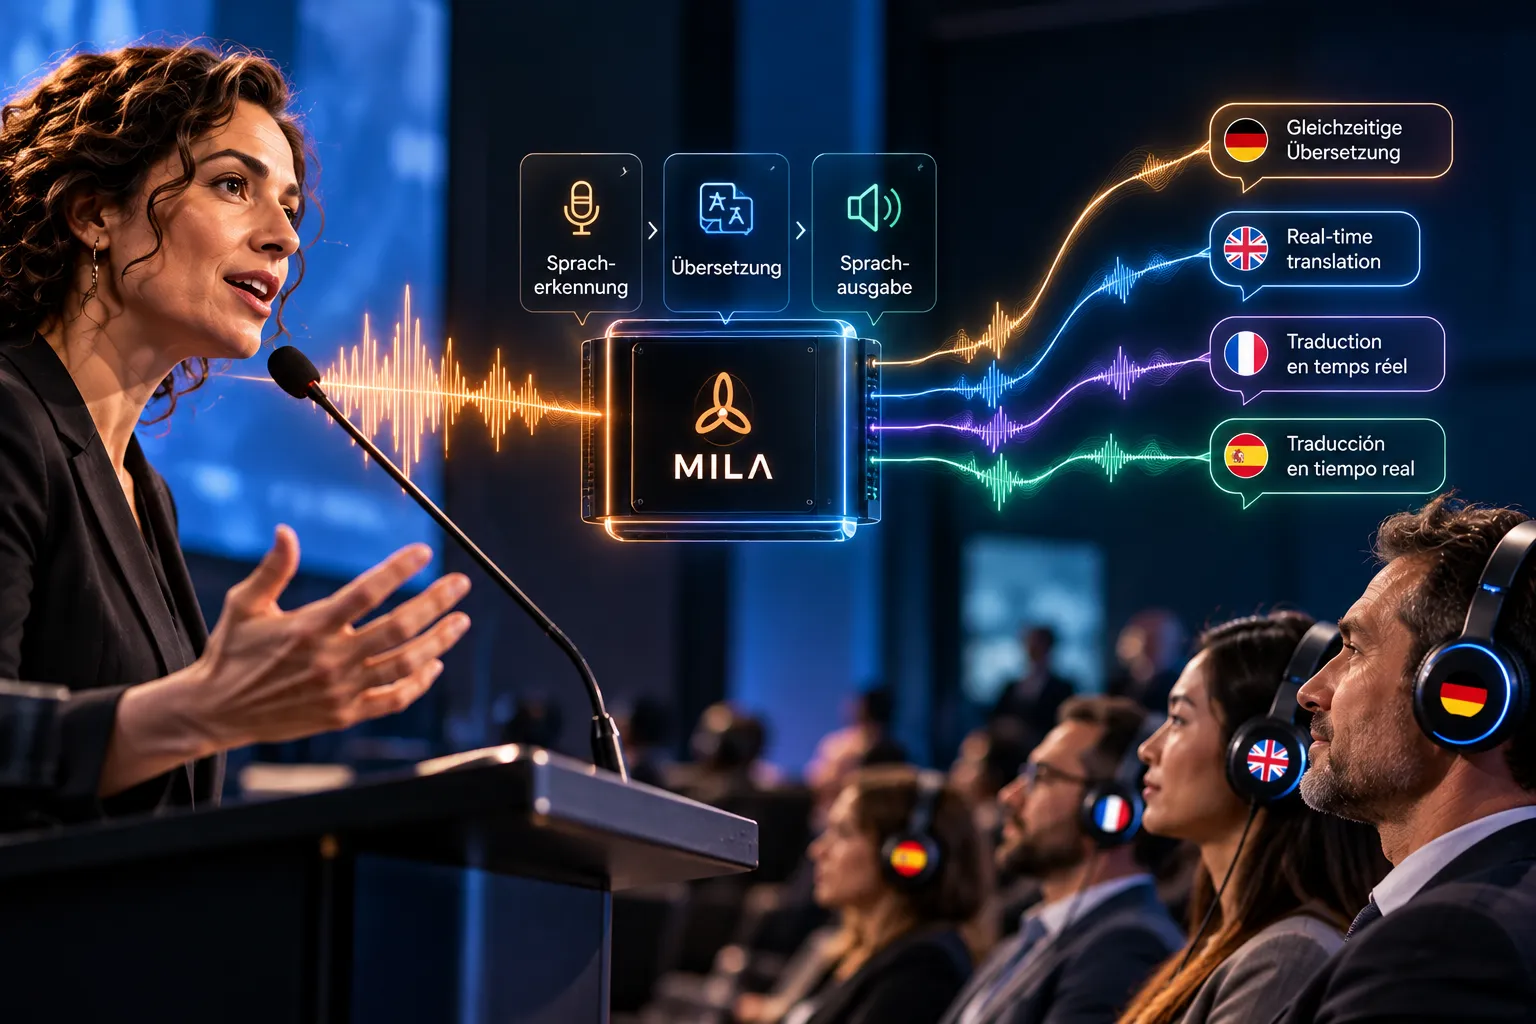
Řečnice na pódiu začne dlouhou německou větu a rozhodující sloveso stojí až na úplném konci. Lidský simultánní tlumočník poslouchá, zařazuje si řečené do souvislostí a začne mluvit dřív, než je věta dokončena. Tlumočník založený na AI stojí před úplně stejným úkolem: musí zároveň poslouchat, překládat a mluvit. Jak to vyřeší, do značné míry závisí na jeho architektuře. Dosud pracuje mnoho systémů pro simultánní tlumočení v několika po sobě jdoucích krocích. Nové výzkumné přístupy se snaží toto zpracování propojit těsněji. V tomto článku vysvětlujeme nejdůležitější přístupy, jejich výhody a nevýhody a proč je otázka architektury důležitá i pro Vás jako pořadatele.
Klasická pipeline: ASR, překlad, hlasový výstup
Osvědčená struktura systému pro AI tlumočení je řetězec tří stavebních bloků:
- Rozpoznávání řeči (ASR, Automatic Speech Recognition): Model převádí mluvené slovo na text.
- Překlad (Translation): Druhý model převádí tento text do cílového jazyka.
- Hlasový výstup (TTS, Text-to-Speech): Umělý hlas překlad vysloví.
Každý blok plní jasně vymezený úkol a předává svůj výsledek dalšímu. Proto se hovoří o modulární architektuře neboli pipeline.
Co hovoří pro modulární strukturu
Největší výhoda spočívá v transparentnosti. Mezi jednotlivými kroky vznikají výsledky, které lze prohlédnout a zkontrolovat, především přepis po rozpoznání řeči. Pokud je slovo přeloženo chybně, lze dohledat, zda bylo chybně rozpoznáno již na začátku, nebo se změnilo až při překladu.
Navíc lze jednotlivé bloky samostatně optimalizovat nebo vyměnit. Odborné termíny a vlastní jména lze cíleně zapracovat tam, kde jsou potřeba, například při rozpoznávání názvu produktu nebo při překladu odborného termínu. A když je pro některý dílčí krok k dispozici lepší model, není nutné celý systém budovat znovu.
Kde pipeline naráží na své meze
Řetězec má i slabiny. Chyby se přenášejí dál: co rozpoznávání řeči špatně pochopí, přeloží další stupeň tak, jak to bylo rozpoznáno, nikoli tak, jak to bylo myšleno. Kromě toho se sčítají doby zpracování jednotlivých kroků.
Třetí bod se týká způsobu mluvy. Při převodu na text se snadno ztrácejí informace jako důraz, tempo řeči nebo ironie. Co už v textu není, nemůže hlasový výstup nakonec ani reprodukovat. Tomuto tématu jsme věnovali samostatný článek: Dokáže AI překládat emoce?
End-to-End Speech-to-Speech Translation
Právě zde navazuje výzkumná oblast, která v posledních letech získala velkou pozornost: end-to-end speech-to-speech translation. Myšlenka: jediný model přijímá mluvenou řeč a přímo generuje mluvenou řeč v cílovém jazyce, aniž by nutně musel jít oklikou přes zapsaný text.
Z toho plynou možné výhody. Méně předávání mezi jednotlivými modely může zpracování urychlit. A protože model pracuje se samotným zvukem, existuje šance přenést i vlastnosti původního způsobu mluvy.
Proti tomu stojí určité výzvy. Integrovaný model je hůře průhledný: pokud neexistuje viditelný mezikrok, je obtížnější přiřadit chybu k její příčině. Ani cílené řízení, například zadání určitých odborných termínů, není u uzavřeného modelu bez dalšího možné tak jako v pipeline.
Audio-nativní modely AI: zvuk jako samostatný zdroj informací
Úzce příbuzné s tímto přístupem jsou takzvané audio-nativní modely AI. Zpracovávají zvukové signály přímo, místo aby pracovaly výhradně s textem. Díky tomu mohou v zásadě využívat informace, které jsou obsaženy pouze ve zvuku, například pauzy nebo důraz.
Hranice mezi přístupy se přitom stále více stírají. Ve výzkumu existují i hybridní formy, které kombinují prvky modulárního řetězce s integrovanými modely. Otázka proto stále méně často zní „pipeline, nebo end-to-end?“, ale spíše: Které části zpracování by měly být úzce propojené a kde má smysl viditelný, řiditelný mezikrok? Žádný z přístupů není paušálně lepší. Jaká architektura je vhodná, závisí na tom, co je v daném nasazení nejdůležitější.
Bez ohledu na architekturu platí: každý model může pracovat jen se signálem, který k němu dorazí. Proč stojí zvuk na začátku každého tlumočení, se dočtete v našem článku AI tlumočení a audiotechnika: Proč vše začíná u mikrofonu.
Streaming: simultánní tlumočení dřív, než věta skončí
Pro simultánní tlumočení na konferenci nebo kongresu nestačí dobře překládat. Systém to musí dělat i průběžně. Nemůže čekat, až řečnice dokončí svou přednášku, ale musí zpracovávat proud řeči po malých úsecích. Tento princip se nazývá streamingové zpracování.
Z toho vyplývá zásadní kompromis:
- Překládat brzy znamená krátké zpoždění, ale méně kontextu. Systém možná musí překládat dřív, než je jasné, kam věta směřuje.
- Poslouchat déle znamená více kontextu, a tím lepší základ, ale také větší odstup od originálu.
Příklad ze začátku ukazuje, proč je to tak náročné: v němčině stojí sloveso často na konci věty, v mnoha cílových jazycích přichází brzy. Streamingový systém se tedy musí rozhodnout, jak dlouho počká. K tomu se přidává ještě jedna věc: text lze na pozadí ještě opravit, slovo již vyslovené v cílovém jazyce už ne.
Které trendy jsou pro systémy v reálném čase obzvlášť důležité
Pro živé nasazení na akcích jsou podle nás důležité především čtyři trendy:
- Modely schopné streamingu, které si poradí s neúplnými větami a dobře vyváží zpoždění a kontext.
- Řiditelnost, aby odborné termíny, názvy produktů a vlastní jména z programu spolehlivě zazněly tak, jak jsou myšleny.
- Monitorovatelnost, aby bylo během akce kdykoli vidět, co systém právě rozpoznává a co vydává.
- Efektivita, aby výkonné modely mohly běžet i na technice na místě, místo aby byly odkázány na vzdálená datová centra.
Co architektura znamená pro Vaši akci
Nepotřebujete odborné znalosti o jazykových modelech. Architektura tlumočnického systému však určuje, jak flexibilně jej lze optimalizovat, monitorovat a dále vyvíjet. A právě to poznáte při nasazení: když je jméno Vašeho hlavního sponzora přeneseno správně, když odborný termín z Vašeho oboru sedí, nebo když při problému může někdo rychle zasáhnout.
V MILA proto nechápeme simultánní tlumočení jako rozhraní, které se jednoduše připojí, ale jako celý řetězec zpracování od mikrofonu až po sluchátka. Konkrétně to znamená:
- Odborné termíny a vlastní jména z Vašeho programu nastavíme předem.
- Simultánní tlumočení s AI běží lokálně na naší vlastní technice v místě konání, bez cloudu. Mluvené slovo neopustí Vaši akci.
- Systémový technik je vždy na místě. Vše s Vámi naplánuje, techniku nainstaluje, během akce zajišťuje tlumočení a poté techniku opět demontuje.
- Každý jazyk vede samostatným kanálem do Vaší stávající tlumočnické techniky nebo konferenční techniky; na přání zajistíme pro hosty přijímače a sluchátka.
Výzkum systémů speech-to-speech se rychle vyvíjí a pozorně jej sledujeme. Pokud chcete vědět, jak může vypadat simultánní tlumočení pro Váš kongres, Vaši konferenci nebo Vaši firemní akci, podrobnosti o technice a průběhu najdete na naší stránce Služby. Odpovědi na časté dotazy jsme shromáždili v našich FAQ.
