Blog · 19. 8. 2026
Speech-to-Speech Translation: Jak funguje moderní překlad řeči pomocí AI
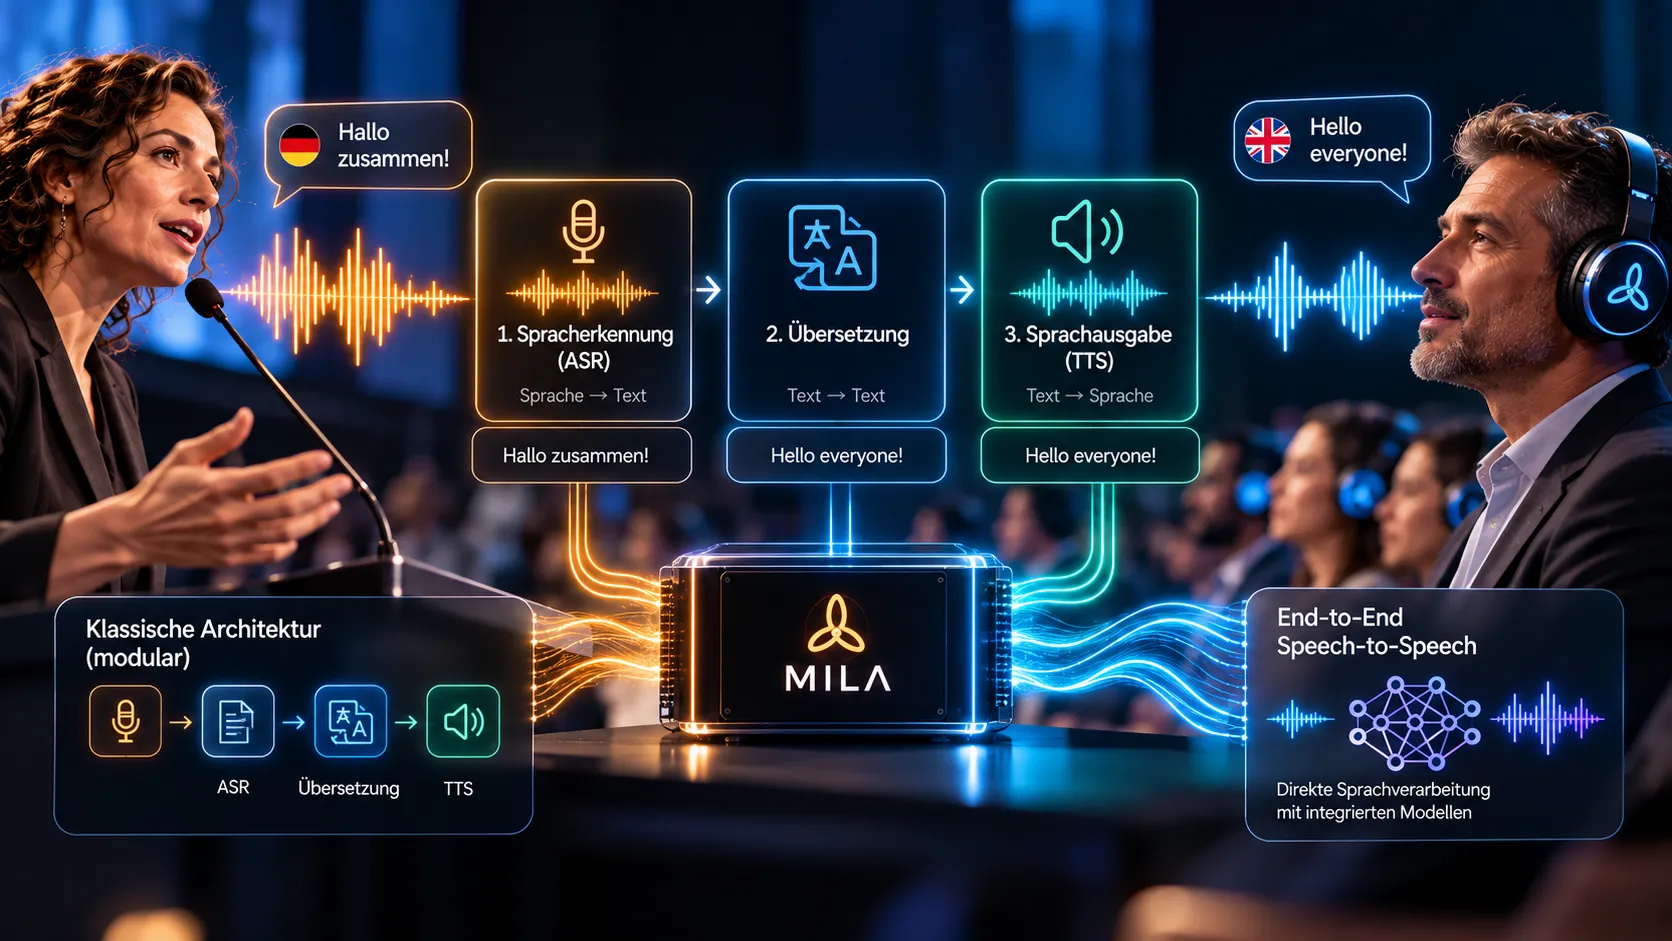
Řečnice mluví německy a hosté v sále sledují přednášku ve sluchátkách – v angličtině, francouzštině nebo polštině. To, co publikum vnímá jako jediný proces, se z technického hlediska skládá z několika úloh, které musí úzce navazovat jedna na druhou. Právě o tom je Speech-to-Speech Translation, tedy převod mluvené řeči do mluvené řeči v jiném jazyce. V tomto příspěvku vysvětlujeme, jak je uspořádán klasický řetězec zpracování, kde jsou jeho hranice, jaké nové architektury AI zkoumá výzkum – a proč jsou tyto otázky důležité i pro Vás jako pořadatele.
Tři úlohy, jeden cíl
Profesionální systém AI tlumočení musí propojit několik komplexních úloh. Musí:
- rozpoznat mluvenou řeč,
- přeložit obsah do cílového jazyka,
- a z toho vytvořit srozumitelný řečový výstup.
Lidský simultánní tlumočník zvládá vše v jedné hlavě: poslouchá, rozumí, převádí, mluví. U strojového simultánního překladu se tyto úlohy tradičně rozdělují mezi různé modely, z nichž každý se specializuje na svou část. Čím se AI tlumočení a lidští konferenční tlumočníci zásadně liší, rozebíráme v příspěvku AI tlumočník, nebo člověk: Stane se simultánní tlumočník zbytečným?
Rozdělení mezi více modelů má své výhody, ale i technické hranice – obojí si zaslouží bližší pohled.
Klasický řetězec zpracování u Speech-to-Speech Translation
V klasické podobě probíhá Speech-to-Speech Translation ve třech po sobě jdoucích krocích. Výsledek každého kroku je vstupem pro krok následující.
Krok 1: Automatické rozpoznávání řeči (ASR)
Na začátku stojí automatické rozpoznávání řeči, zkráceně ASR (Automatic Speech Recognition). Převádí zvukový signál – například z mikrofonu u řečnického pultu – na text. Z mluveného slova vznikají slova a věty.
Krok 2: Strojový překlad
Poté model strojového překladu přeloží rozpoznaný obsah do cílového jazyka. Pracuje s textem, který dodalo rozpoznávání řeči – nikoli s původním zvukem.
Krok 3: Syntéza řeči (Text-to-Speech)
Ve třetím kroku vytvoří systém Text-to-Speech, zkráceně TTS, z přeloženého textu mluvený výstup. Tento hlas pak hosté slyší ve sluchátkách nebo prostřednictvím konferenční techniky.
Výhoda: Každou komponentu lze zlepšovat samostatně
Tato modulární architektura má jasnou výhodu: Jednotlivé komponenty lze optimalizovat nezávisle na sobě. Pokud je pro některý z kroků k dispozici lepší model, lze jej nasadit, aniž by bylo nutné znovu vyvíjet ostatní části. Každou část řetězce lze cíleně testovat, upravovat a vyměňovat.
Kde leží výzvy
Ať je řetězec sebepřehlednější – přináší zásadní výzvy.
Každý krok zpracování potřebuje čas
Rozpoznávání řeči, překlad a syntéza řeči probíhají postupně a každý z těchto kroků potřebuje čas. U simultánního překladu, kdy mají hosté sledovat program s co nejmenším zpožděním, je to klíčový faktor.
Chyby putují řetězcem
Další výzva je méně zjevná: Chyby se mohou přenášet z jedné komponenty do další. Pokud rozpoznávání řeči nesprávně interpretuje určitý pojem, dostává model překladu už chybné informace. Ten pak možná přeloží čistě – ale právě to nesprávné. Syntéza řeči tuto chybu nakonec slyšitelně zopakuje.
Obzvlášť ožehavé je to u odborných termínů a vlastních jmen, které se na kongresech a odborných konferencích objevují neustále. Jediný chybně rozpoznaný pojem může větě dát jiný význam. Proto je první krok tak důležitý – a s ním i kvalita vstupního signálu. Proč o mnohém rozhoduje zvuk, popisujeme v příspěvku AI tlumočení a audiotechnika: Proč vše začíná u mikrofonu.
End-to-End Speech-to-Speech Translation: přímější cesta
Alternativní oblast výzkumu se zabývá modely, které zpracovávají řečové informace přímočařeji. Hovoří se o End-to-End Speech-to-Speech Translation. Takové systémy mohou určité mezikroky omezit nebo je interně těsněji propojit – místo striktně oddělených stanic vzniká integrovanější cesta zpracování.
Co mohou integrované modely zachovat
Přitažlivost tohoto přístupu spočívá v tom, co se v klasickém řetězci může ztratit. Jakmile se mluvená řeč převede na text, zůstanou především slova. Vlastnosti hlasu, prozodie – tedy přízvuk, rytmus a melodie řeči – a také části jazykového kontextu v textu nejsou.
Integrované přístupy otevírají nové možnosti, jak takové informace přenést. Jak daleko je výzkum například v přenosu emocí a kde jsou jeho hranice, jsme shrnuli v příspěvku Dokáže AI přeložit emoce?
Žádná automatická zkratka
Integrované systémy však nejsou automaticky rychlejší nebo spolehlivější jen proto, že mají méně oddělených mezikroků. Zohlednit je třeba také jejich ovladatelnost a přizpůsobitelnost.
Pro nasazení na akcích to není vedlejší věc: Kdo chce odborné termíny a vlastní jména nastavit předem a překlad během akce průběžně kontrolovat, potřebuje systém, do kterého lze cíleně zasahovat.
Modulární, nebo integrovaná architektura?
Oba přístupy mají své výhody: Modulární systémy lze vyměňovat a optimalizovat část po části. Integrované modely mohou zachovat informace jako prozodii a vlastnosti hlasu, které se při textovém mezizpracování ztrácejí. Která architektura je vhodnější, závisí na požadavcích – paušální odpověď neexistuje.
Co to znamená pro Vaši akci
Jako pořadatel, agentura, firma nebo svaz nemusíte posuzovat architektury modelů. Pro Vás je důležité, aby Vaši hosté mohli sledovat program ve svém jazyce – ať už na kongresu, valné hromadě nebo veřejném zasedání. Přesto znalost řetězce zpracování pomáhá, když plánujete simultánní tlumočení pro svou akci. Některé faktory totiž lze ovlivnit předem:
- Zvuk: Protože vše začíná rozpoznáváním řeči, čistý signál z mikrofonu spoluurčuje, co se dostane do dalších kroků.
- Program: Odborné termíny a vlastní jména, která jsou známa předem, lze připravit. V MILA je nastavujeme ještě před akcí.
- Dohled: Simultánní tlumočení s podporou AI by nemělo běžet bez dohledu. U nás překlad během akce na místě zajišťuje systémový technik.
Pohled MILA
Pro MILA je architektura řečového systému zásadním technickým rozhodnutím. Zabýváme se otázkou, jak propojit kvalitu překladu, schopnost práce v reálném čase a lokální zpracování.
Lokální zpracování je přitom pevnou součástí naší nabídky: Naše AI simultánní tlumočení běží lokálně na naší vlastní technice v místě konání, bez cloudu. Mluvené slovo neopouští akci.
Zvažujeme přitom jak specializované jednotlivé modely, tak nové integrované přístupy. Kvalita systému AI tlumočení totiž nevzniká díky jedinému modelu. Vzniká souhrou celého řetězce zpracování – od vstupního signálu přes přípravu jazyků až po dohled na místě.
Na konci řetězce přichází každý jazyk na samostatném kanálu do stávajícího tlumočnického zařízení nebo konferenční techniky; na přání zajistíme pro hosty přijímače a sluchátka. Jak technika, průběh a doplňkové služby vypadají v jednotlivostech, najdete na naší stránce Služby. Pokud plánujete vícejazyčnou akci, rádi s Vámi probereme, co Váš program potřebuje.
