Blog · 10-8-2026
Kan AI stemmen onderscheiden? Sprekerherkenning en voice cloning uitgelegd
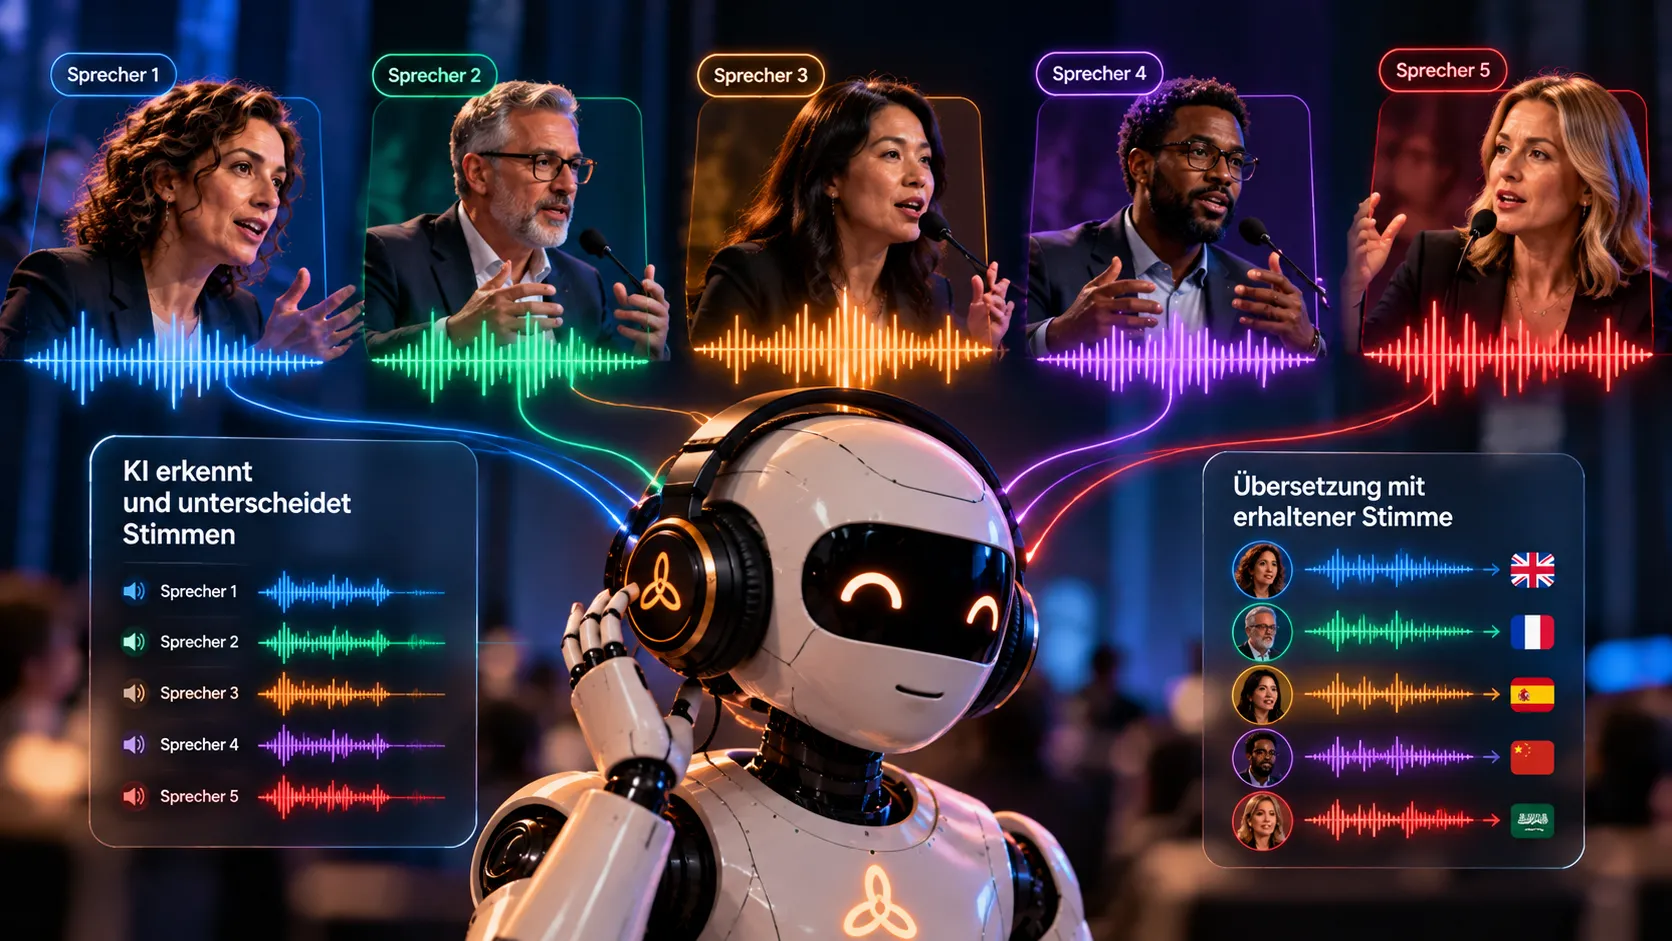
Wie spreekt er op dit moment? Bij een klassieke lezing speelt die vraag nauwelijks: één persoon spreekt, het publiek luistert. Op het podium ligt dat anders. Meerdere personen wisselen elkaar af, onderbreken elkaar of spreken tegelijk. Voor AI-gestuurd simultaantolken ontstaat daardoor een extra taak: het systeem moet niet alleen begrijpen wat er wordt gezegd, maar ook zo goed mogelijk herkennen wie er op dat moment spreekt. Precies daar draait het om bij sprekerherkenning. In dit artikel leggen we uit hoe speaker diarization werkt, waarom overlappende spraak zo veeleisend is, wat voice cloning voor het tolken zou kunnen betekenen – en welke verantwoordelijkheid samenhangt met het nabootsen van menselijke stemmen.
Van lezing naar podium: waarom de vraag „Wie spreekt er?” belangrijk wordt
Of het nu om een mens of om AI gaat: voor elke vertolking maakt het format een groot verschil. Bij een keynote op een congres of een presentatie op een bedrijfsevenement is er een duidelijke bron: de microfoon op het spreekgestoelte of de headset van de persoon op het podium. Wie er spreekt, is eenduidig.
Bij een paneldiscussie verschuift dat. De moderator stelt een vraag, een gast antwoordt, een tweede spreekt hem tegen, een derde vult midden in de zin aan. Zulke wisselingen zijn gewenst, ze maken een discussie levendig. Voor een AI-systeem betekenen ze echter dat er twee taken tegelijk moeten worden opgelost:
- Wat wordt er gezegd? Dat is de basis van elke vertolking.
- Wie zegt het? Deze informatie helpt om bijdragen van elkaar te onderscheiden en verbanden begrijpelijk te maken.
Wie een discussie via de vertolking volgt, is erop aangewezen dat wisselingen tussen sprekers herkenbaar blijven. Anders vervloeien rede en tegenrede al snel tot één enkele stroom.
Sprekerherkenning met AI: wat speaker diarization doet
De vakterm voor het in de tijd toewijzen van spraakfragmenten aan verschillende sprekers is speaker diarization. Een dergelijk systeem analyseert akoestische eigenschappen van het signaal en probeert verschillende stemmen van elkaar te onderscheiden.
Het resultaat is een structuur in de tijd. Vereenvoudigd kan die er zo uitzien:
- spreker A spreekt in het eerste fragment,
- spreker B neemt het over,
- spreker C neemt het woord,
- daarna spreekt weer spreker A.
Belangrijk is daarbij een punt dat vaak over het hoofd wordt gezien: speaker diarization is niet hetzelfde als het identificeren van personen. Het systeem hoeft niet per se te weten welke echte mensen achter de stemmen zitten. Het volstaat dat het stem A en stem B als verschillende stemmen herkent. Of A de moderator en B de bestuursvoorzitter is, blijft voor deze taak in eerste instantie open.
Voor simultaantolken is juist dit vermogen relevant. Alleen al de informatie dat er nu een andere persoon spreekt dan daarvoor, kan helpen om een discussie begrijpelijker weer te geven.
Als iedereen tegelijk praat: sprekerscheiding bij overlappende spraak
Bijzonder lastig wordt het wanneer meerdere mensen tegelijk spreken. In een levendige paneldiscussie gebeurt dat regelmatig – een korte opmerking tussendoor, een instemmend woord, twee antwoorden die elkaar overlappen.
Hier komen methoden voor audio source separation in beeld. Die moeten verschillende spraaksignalen die over elkaar heen liggen van elkaar scheiden. In het beste geval ontstaan uit een mix weer afzonderlijke, verstaanbare stemmen.
De kwaliteit van zulke methoden hangt echter sterk af van het bronmateriaal en van de akoestische omstandigheden. Hoe duidelijker de afzonderlijke stemmen in het signaal aanwezig zijn, hoe beter ze van elkaar te onderscheiden zijn. Wat in het geluid al verloren is gegaan, kan ook een geavanceerde scheiding niet betrouwbaar terughalen.
Wat dit betekent voor uw planning
Voor organisatoren betekent dit: de vraag hoe goed AI sprekers kan onderscheiden, is altijd ook een vraag van geluidstechniek. Hoe de microfoonopstelling bij panels de basis legt voor elke vertolking, hebben we uitgebreid beschreven in het artikel AI-tolken en audiotechniek: waarom alles bij de microfoon begint. Plant u simultaantolken bij een paneldiscussie, dan loont het om het geluid vroegtijdig samen af te stemmen.
Voice cloning: kan een vertolking de stem behouden?
Een tweede onderzoeksveld gaat nog een stap verder. Het houdt zich bezig met het synthetisch nabootsen van menselijke stemmen, vaak aangeduid als voice cloning.
Moderne spraaksynthese kan bepaalde eigenschappen van een stem overnemen en gebruiken voor nieuwe talige inhoud. Voor het tolken ontstaan daardoor nieuwe mogelijkheden: een spreker zou in een andere taal kunnen worden weergegeven, terwijl kenmerkende eigenschappen van zijn stem gedeeltelijk behouden blijven.
Het woord „gedeeltelijk” is daarbij bewust gekozen. Het gaat er niet om een persoon volledig te kopiëren, maar erom dat de vertolking niet langer klinkt als een vreemde stem, maar kenmerken van het origineel meedraagt.
In combinatie met sprekerherkenning wordt het potentieel zichtbaar: als een systeem herkent dat nu spreker B aan het woord is en diens stemeigenschappen in de doeltaal behoudt, zou een vertolkte paneldiscussie aanzienlijk makkelijker te volgen kunnen zijn. Vergelijkbare vragen spelen bij het overbrengen van klemtoon en expressie – meer daarover leest u in ons artikel Kan AI emoties vertalen?
Technische mogelijkheden en ethische vragen
Hoe boeiend de techniek ook is: het nabootsen van menselijke stemmen brengt aanzienlijke verantwoordelijkheid met zich mee. Een stem is iets zeer persoonlijks. Wie die synthetisch genereert, begeeft zich op gevoelig terrein.
Drie voorwaarden zijn in onze ogen essentieel:
- Toestemming: de persoon wiens stem wordt nagebootst, moet daarmee instemmen.
- Transparantie: juist in een professionele omgeving moet duidelijk zijn wanneer een synthetische stem wordt gebruikt. Het publiek moet weten dat het naar een vertolking luistert en niet naar de persoon zelf.
- Bescherming tegen misbruik: nagebootste stemmen mogen niet buiten het afgesproken doel worden gebruikt.
Voor bedrijven, brancheorganisaties en publieke instellingen zijn deze vragen niet abstract. Op een aandeelhoudersvergadering, een vakconferentie of een openbare vergadering moet te allen tijde navolgbaar zijn wie wat heeft gezegd – en in welke vorm dat wordt weergegeven.
Het MILA-perspectief op sprekerherkenning en stembehoud
Voor toekomstige AI-tolksystemen zijn sprekerherkenning en stembehoud belangrijke ontwikkelterreinen. Vooral bij paneldiscussies zou een betrouwbare toewijzing van de bijdragen aan de afzonderlijke sprekers de verstaanbaarheid kunnen verbeteren. Daarom volgen we deze technologieën met aandacht.
Onze maatstaf blijft daarbij dezelfde: technische innovatie moet een daadwerkelijke meerwaarde voor de communicatie opleveren. Een nieuwe functie is voor ons pas zinvol als die uw gasten helpt een evenement beter te volgen.
Bij uw evenement zetten we vandaag in op wat betrouwbaar te plannen is. Het AI-simultaantolken draait lokaal op onze eigen apparatuur op de evenementlocatie, zonder cloud – wat er gezegd wordt, verlaat het evenement niet. Vaktermen en eigennamen uit het programma stellen we vooraf in. Elke taal komt via een eigen kanaal in de aanwezige tolkinstallatie of congrestechniek, op verzoek met ontvangers en hoofdtelefoons voor de gasten. En er is altijd een systeemtechnicus ter plaatse: hij plant met u, bouwt op, begeleidt het tolken tijdens het evenement en bouwt weer af.
Plant u een congres, een conferentie of een bedrijfsevenement met paneldiscussie en wilt u weten hoe het tolken daarvoor kan worden gerealiseerd? Alle details over techniek en verloop vindt u op onze pagina over onze diensten. Welke formats we begeleiden, ziet u bij onze toepassingsgebieden – neem gerust contact met ons op.
