Blog · 11-8-2026
Simultaan tolken met AI: wanneer de machine luistert, vertaalt en spreekt
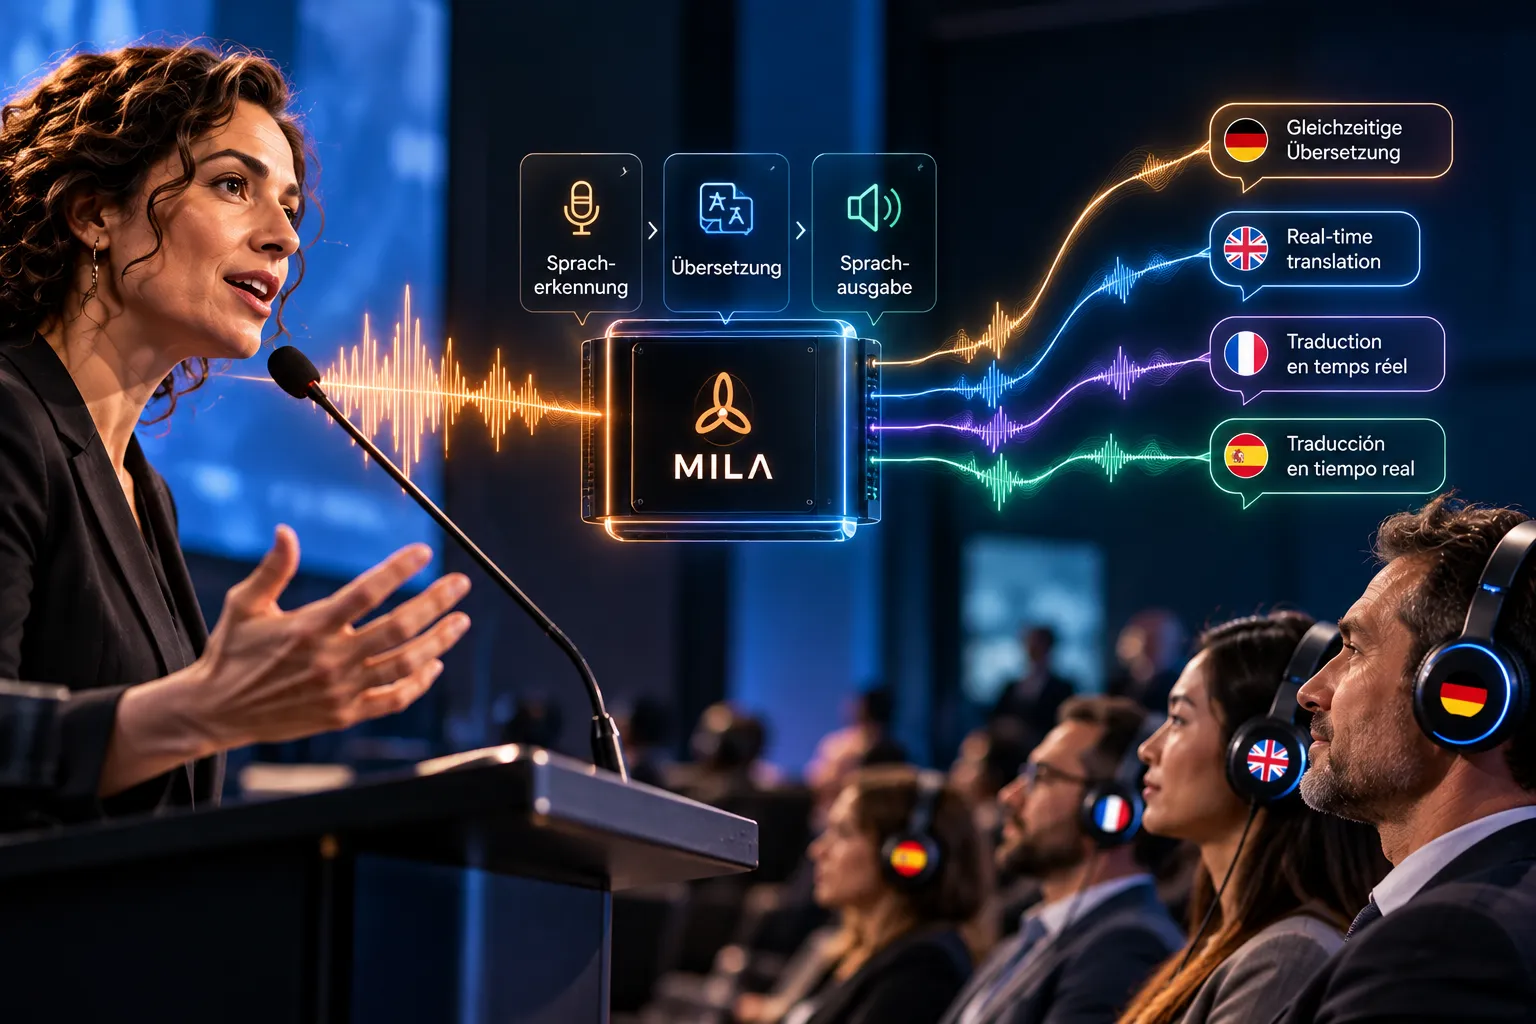
Een spreekster begint op het podium aan een lange Duitse zin, en het beslissende werkwoord staat helemaal aan het eind. Een menselijke simultaantolk luistert, plaatst wat hij hoort in context en begint te spreken voordat de zin af is. Een AI-tolk staat voor precies dezelfde taak: hij moet tegelijkertijd luisteren, vertalen en spreken. Hoe hij dat oplost, hangt sterk af van zijn architectuur. Tot nu toe werken veel systemen voor simultaan tolken in meerdere opeenvolgende stappen. Nieuwe onderzoeksbenaderingen proberen deze verwerking nauwer met elkaar te verbinden. In dit artikel leggen we de belangrijkste benaderingen uit, met hun voor- en nadelen, en waarom de vraag naar de architectuur ook voor u als organisator relevant is.
De klassieke pipeline: ASR, vertaling, spraakuitvoer
De beproefde opbouw van een AI-tolksysteem is een keten van drie bouwstenen:
- Spraakherkenning (ASR, Automatic Speech Recognition): Een model zet het gesproken woord om in tekst.
- Vertaling (Translation): Een tweede model zet deze tekst om in de doeltaal.
- Spraakuitvoer (TTS, Text-to-Speech): Een kunstmatige stem spreekt de vertaling uit.
Elke bouwsteen voert een duidelijk afgebakende taak uit en geeft zijn resultaat door aan de volgende. Men spreekt daarom van een modulaire architectuur of een pipeline.
Wat pleit voor de modulaire opbouw
Het grootste voordeel is de transparantie. Tussen de stappen ontstaan resultaten die u kunt bekijken en controleren, vooral het transcript na de spraakherkenning. Wordt een woord verkeerd vertaald, dan is te achterhalen of het al verkeerd werd herkend of pas bij de vertaling werd veranderd.
Bovendien kunnen de bouwstenen afzonderlijk worden geoptimaliseerd of vervangen. Vaktermen en eigennamen kunnen gericht worden ingebracht waar ze nodig zijn, bijvoorbeeld bij de herkenning van een productnaam of bij de vertaling van een vakterm. En wanneer er een beter model voor een deelstap beschikbaar komt, hoeft niet het hele systeem opnieuw te worden opgebouwd.
Waar de pipeline tegen grenzen aanloopt
De keten heeft ook zwakke punten. Fouten werken door: wat de spraakherkenning verkeerd verstaat, vertaalt de volgende stap zoals het werd herkend, niet zoals het bedoeld was. Daarnaast tellen de verwerkingstijden van de afzonderlijke stappen bij elkaar op.
Een derde punt betreft de manier van spreken. Bij de omzetting naar tekst gaat informatie zoals klemtoon, spreektempo of ironie gemakkelijk verloren. Wat niet meer in de tekst staat, kan de spraakuitvoer aan het eind ook niet weergeven. Aan dit onderwerp hebben we een apart artikel gewijd: Kan AI emoties vertalen?
End-to-End Speech-to-Speech Translation
Hier komt een onderzoeksveld om de hoek kijken dat de afgelopen jaren sterk aan aandacht heeft gewonnen: End-to-End Speech-to-Speech Translation. Het idee: één enkel model neemt gesproken taal op en genereert direct gesproken taal in de doeltaal, zonder noodzakelijkerwijs de omweg via een uitgeschreven tekst te maken.
Daaruit ontstaan mogelijke voordelen. Minder overdrachten tussen afzonderlijke modellen kunnen de verwerking versnellen. En omdat het model met de klank zelf werkt, bestaat de kans dat eigenschappen van de oorspronkelijke manier van spreken worden meegenomen.
Daar staan uitdagingen tegenover. Een geïntegreerd model is moeilijker te doorgronden: als er geen zichtbare tussenstap is, is een fout moeilijker aan een oorzaak toe te schrijven. Ook gerichte sturing, zoals het vooraf vastleggen van bepaalde vaktermen, is bij een gesloten model niet zonder meer zo mogelijk als in een pipeline.
Audio-native AI-modellen: klank als eigen informatiebron
Nauw verwant aan deze benadering zijn zogenoemde audio-native AI-modellen. Ze verwerken audiosignalen rechtstreeks, in plaats van uitsluitend met tekst te werken. Daardoor kunnen ze in principe informatie benutten die alleen in de klank zit, zoals pauzes of klemtonen.
De grenzen tussen de benaderingen vervagen daarbij steeds meer. In het onderzoek bestaan ook mengvormen die elementen van een modulaire keten combineren met geïntegreerde modellen. De vraag luidt daarom steeds minder vaak „pipeline of end-to-end?”, maar eerder: welke delen van de verwerking moeten nauw met elkaar verbonden zijn, en waar is een zichtbare, stuurbare tussenstap zinvol? Geen van de benaderingen is in het algemeen superieur. Welke architectuur zinvol is, hangt af van wat bij de betreffende inzet het zwaarst weegt.
Ongeacht de architectuur geldt: elk model kan alleen werken met het signaal dat bij hem binnenkomt. Waarom het geluid aan het begin van elke vertaling staat, leest u in ons artikel AI-tolken en audiotechniek: waarom alles bij de microfoon begint.
Streaming: simultaan tolken voordat de zin af is
Voor simultaan tolken op een conferentie of congres is het niet genoeg om goed te vertalen. Het systeem moet dat ook doorlopend doen. Het kan niet wachten tot een spreekster haar presentatie heeft beëindigd, maar moet de spreekstroom in kleine delen verwerken. Dit principe heet streamingverwerking.
Daaruit volgt een fundamentele afweging:
- Vroeg vertalen betekent een korte vertraging, maar minder context. Het systeem moet mogelijk vertalen voordat duidelijk is waar de zin naartoe gaat.
- Langer luisteren betekent meer context en daarmee een betere basis, maar ook meer afstand tot het origineel.
Het voorbeeld van het begin laat zien waarom dit zo veeleisend is: in het Duits staat het werkwoord vaak aan het eind van de zin, in veel doeltalen komt het vroeg. Een streamingsysteem moet dus beslissen hoe lang het wacht. Daar komt bij: tekst kan op de achtergrond nog worden gecorrigeerd, een al uitgesproken woord in de doeltaal niet meer.
Welke ontwikkelingen bijzonder relevant zijn voor realtime systemen
Voor de live-inzet bij evenementen zijn volgens ons vooral vier ontwikkelingen belangrijk:
- Streamingcapabele modellen, die met onvolledige zinnen kunnen omgaan en de balans tussen vertraging en context goed treffen.
- Stuurbaarheid, zodat vaktermen, productnamen en eigennamen uit het programma betrouwbaar overkomen zoals ze bedoeld zijn.
- Monitorbaarheid, zodat tijdens het evenement op elk moment zichtbaar is wat het systeem op dat moment herkent en uitvoert.
- Efficiëntie, zodat krachtige modellen ook op apparatuur ter plaatse kunnen draaien, in plaats van afhankelijk te zijn van externe datacenters.
Wat de architectuur betekent voor uw evenement
U hebt geen vakkennis over taalmodellen nodig. De architectuur van een tolksysteem bepaalt echter hoe flexibel het kan worden geoptimaliseerd, gemonitord en verder ontwikkeld. En juist dat merkt u in de praktijk: wanneer de naam van uw hoofdsponsor correct wordt overgebracht, wanneer een vakterm uit uw branche goed zit of wanneer bij een probleem snel iemand kan ingrijpen.
Bij MILA zien we simultaan tolken daarom niet als een interface die u simpelweg aansluit, maar als een volledige verwerkingsketen van de microfoon tot de hoofdtelefoon. Concreet betekent dat:
- Vaktermen en eigennamen uit uw programma stellen we vooraf in.
- De AI-simultaantolking draait lokaal op onze eigen apparatuur op de evenementlocatie, zonder cloud. Wat er gezegd wordt, verlaat uw evenement niet.
- Er is altijd een systeemtechnicus ter plaatse. Hij plant met u, bouwt op, begeleidt de tolking tijdens het evenement en bouwt weer af.
- Elke taal komt via een eigen kanaal in uw bestaande tolkinstallatie of congrestechniek; op verzoek stellen we ontvangers en hoofdtelefoons voor de gasten beschikbaar.
Het onderzoek naar speech-to-speech-systemen ontwikkelt zich snel, en wij volgen het nauwgezet. Wilt u weten hoe simultaan tolken voor uw congres, uw conferentie of uw bedrijfsevenement eruit kan zien? Details over techniek en verloop vindt u op onze pagina over onze diensten. Antwoorden op veelgestelde vragen hebben we verzameld in onze FAQ.
