Blog · 19-8-2026
Speech-to-Speech Translation: hoe moderne AI-spraakvertaling werkt
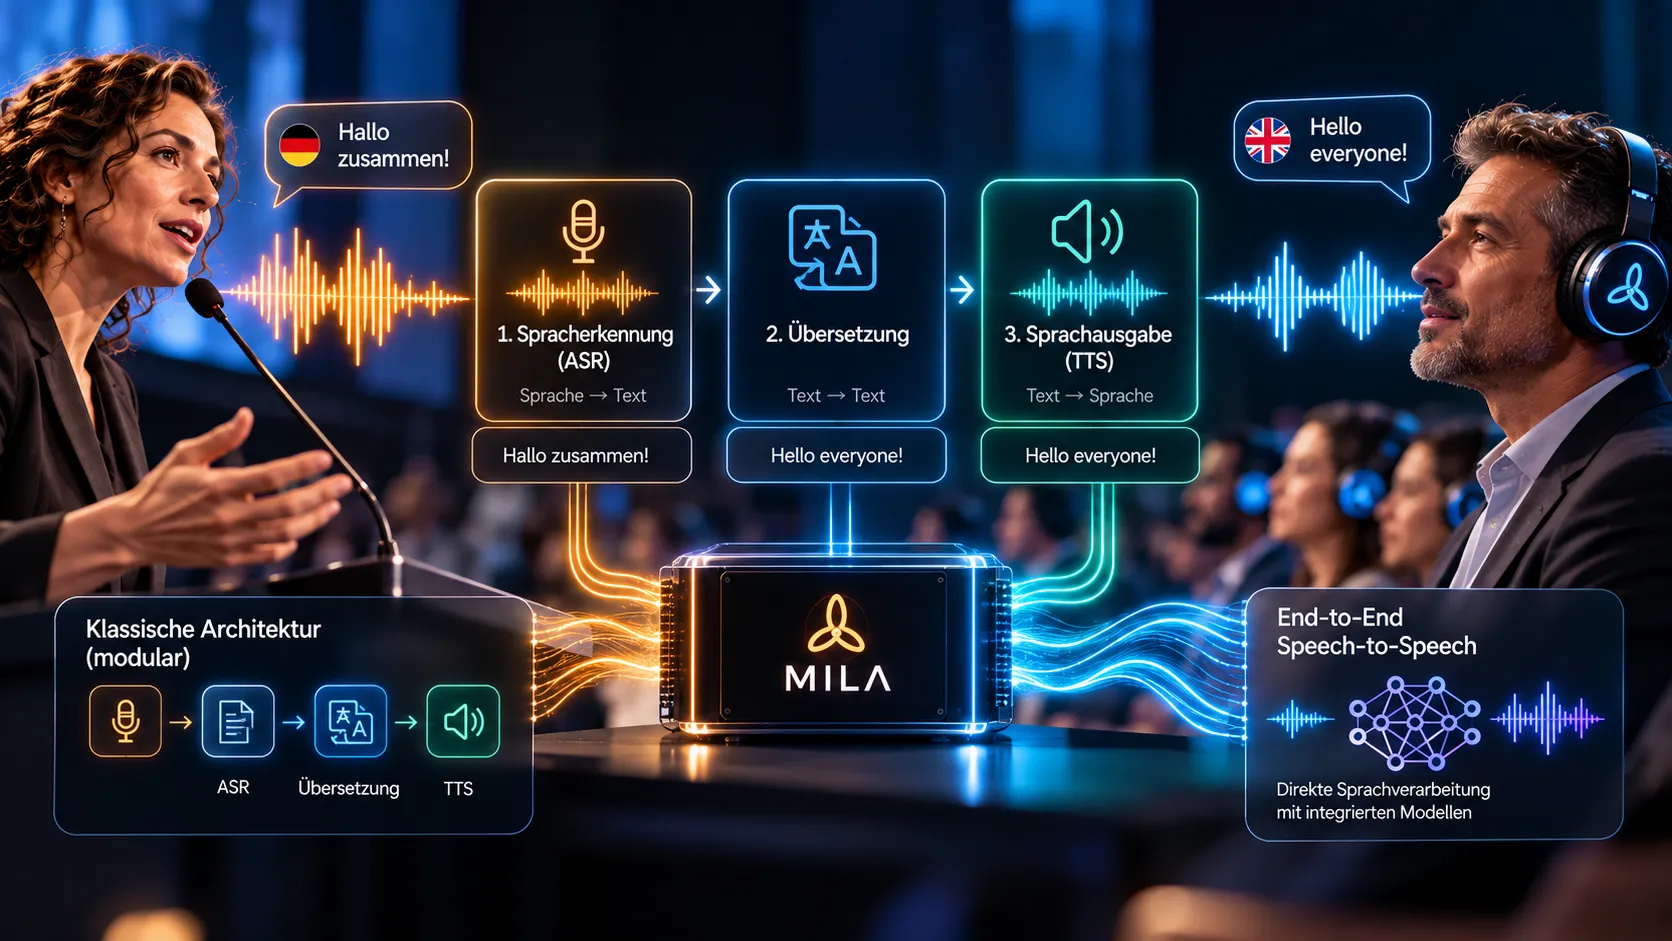
Een spreekster spreekt Duits, in de zaal volgen gasten de presentatie via koptelefoons – in het Engels, Frans of Pools. Wat voor het publiek als één enkel proces overkomt, bestaat technisch uit meerdere taken die nauw op elkaar moeten aansluiten. Precies daar draait het om bij Speech-to-Speech Translation, de vertaling van gesproken taal naar gesproken taal. In deze bijdrage leggen we uit hoe de klassieke verwerkingsketen is opgebouwd, waar de grenzen ervan liggen, welke nieuwe AI-architecturen in onderzoek worden getest – en waarom deze vragen ook voor u als organisator relevant zijn.
Drie taken, één doel
Een professioneel systeem voor AI-tolken moet meerdere complexe taken met elkaar combineren. Het moet:
- gesproken taal herkennen,
- de inhoud naar de doeltaal vertalen,
- en daaruit een begrijpelijke spraakuitvoer genereren.
Een menselijke simultaantolk doet dit allemaal in één hoofd: luisteren, begrijpen, overbrengen, spreken. Bij machinaal simultaan tolken worden deze taken traditioneel verdeeld over verschillende modellen, die elk gespecialiseerd zijn in hun eigen onderdeel. Hoe AI-tolken en menselijke conferentietolken principieel van elkaar verschillen, belichten we in de bijdrage AI-tolk of mens: wordt de simultaantolk overbodig?
De verdeling over meerdere modellen heeft voordelen, maar ook technische grenzen – beide zijn een nadere blik waard.
De klassieke verwerkingsketen van Speech-to-Speech Translation
In de klassieke vorm verloopt Speech-to-Speech Translation in drie opeenvolgende stappen. Het resultaat van elke stap vormt telkens de invoer voor de volgende.
Stap 1: Automatische spraakherkenning (ASR)
Aan het begin staat de automatische spraakherkenning, kortweg ASR (Automatic Speech Recognition). Deze zet het audiosignaal – bijvoorbeeld van de microfoon op het spreekgestoelte – om in tekst. Van het gesprokene worden woorden en zinnen gemaakt.
Stap 2: Machinevertaling
Vervolgens vertaalt een model voor machinevertaling de herkende inhoud naar de doeltaal. Het werkt met de tekst die de spraakherkenning heeft aangeleverd – niet met het oorspronkelijke geluid.
Stap 3: Spraaksynthese (Text-to-Speech)
In de derde stap genereert een Text-to-Speech-systeem, kortweg TTS, uit de vertaalde tekst de gesproken uitvoer. Deze stem horen de gasten uiteindelijk in de koptelefoon of via de conferentietechniek.
Het voordeel: elk onderdeel kan afzonderlijk worden verbeterd
Deze modulaire architectuur heeft een duidelijk voordeel: de afzonderlijke onderdelen kunnen onafhankelijk van elkaar worden geoptimaliseerd. Is er voor een van de stappen een beter model beschikbaar, dan kan dat worden ingezet zonder dat de andere bouwstenen opnieuw hoeven te worden ontwikkeld. Elk deel van de keten kan gericht worden getest, aangepast en vervangen.
Waar de uitdagingen liggen
Hoe overzichtelijk de keten ook is – ze brengt fundamentele uitdagingen met zich mee.
Elke verwerkingsstap kost tijd
Spraakherkenning, vertaling en spraaksynthese verlopen na elkaar, en elk van deze stappen kost tijd. Bij simultaan tolken, waarbij de gasten het programma zo direct mogelijk moeten kunnen volgen, is dat een centrale factor.
Fouten reizen mee door de keten
Een andere uitdaging is minder voor de hand liggend: fouten kunnen van het ene onderdeel aan het volgende worden doorgegeven. Als de spraakherkenning een term verkeerd interpreteert, krijgt het vertaalmodel al foutieve informatie. Het vertaalt dan misschien correct – maar wel het verkeerde. De spraaksynthese geeft deze fout aan het eind hoorbaar weer.
Bijzonder lastig is dat bij vaktermen en eigennamen, zoals die op congressen en vakconferenties voortdurend voorkomen. Eén verkeerd herkende term kan een zin een andere betekenis geven. Daarom is de eerste stap zo belangrijk – en daarmee de kwaliteit van het ingangssignaal. Waarom het geluid zoveel bepaalt, beschrijven we in de bijdrage AI-tolken en audiotechniek: waarom alles bij de microfoon begint.
End-to-End Speech-to-Speech Translation: de directere weg
Een alternatief onderzoeksveld houdt zich bezig met modellen die spraakinformatie directer verwerken. Men spreekt van End-to-End Speech-to-Speech Translation. Zulke systemen kunnen bepaalde tussenstappen beperken of intern nauwer met elkaar verbinden – in plaats van strikt gescheiden stations ontstaat een sterker geïntegreerd verwerkingstraject.
Wat geïntegreerde modellen kunnen behouden
De aantrekkingskracht van deze aanpak ligt in wat bij de klassieke keten verloren kan gaan. Zodra gesproken taal in tekst wordt omgezet, blijven vooral de woorden over. Stemkenmerken, prosodie – dus klemtoon, ritme en zinsmelodie – en delen van de taalkundige context staan niet in de tekst.
Geïntegreerde benaderingen openen nieuwe mogelijkheden om zulke informatie mee over te brengen. Hoe ver het onderzoek bijvoorbeeld is bij het overbrengen van emoties en waar de grenzen liggen, hebben we samengevat in de bijdrage Kan AI emoties vertalen?
Geen automatische kortere weg
Geïntegreerde systemen zijn echter niet automatisch sneller of betrouwbaarder, alleen omdat ze minder gescheiden tussenstappen hebben. Ook hun beheersbaarheid en aanpasbaarheid moeten in overweging worden genomen.
Voor de inzet bij evenementen is dat geen bijzaak: wie vaktermen en eigennamen vooraf wil instellen en de vertolking tijdens het evenement wil begeleiden, heeft een systeem nodig waarin gericht kan worden ingegrepen.
Modulaire of geïntegreerde architectuur?
Beide benaderingen hebben voordelen: modulaire systemen kunnen bouwsteen voor bouwsteen worden vervangen en geoptimaliseerd. Geïntegreerde modellen kunnen informatie zoals prosodie en stemkenmerken behouden, die bij een tekstgebaseerde tussenverwerking verloren gaat. Welke architectuur beter geschikt is, hangt af van de eisen – een pasklaar antwoord bestaat niet.
Wat dit betekent voor uw evenement
Als organisator, bureau, bedrijf of vereniging hoeft u geen modelarchitecturen te beoordelen. Voor u telt dat uw gasten het programma in hun eigen taal kunnen volgen – of het nu gaat om een congres, een algemene vergadering van aandeelhouders of een openbare zitting. Toch helpt kennis van de verwerkingsketen wanneer u simultaan tolken voor uw evenement plant. Want een aantal factoren kunt u vooraf beïnvloeden:
- Het geluid: omdat alles met de spraakherkenning begint, bepaalt een zuiver microfoonsignaal mede wat er in de volgende stappen aankomt.
- Het programma: vaktermen en eigennamen die vooraf bekend zijn, kunnen worden voorbereid. Bij MILA stellen we ze vóór het evenement in.
- De begeleiding: AI-ondersteund simultaan tolken zou niet onbewaakt moeten draaien. Bij ons begeleidt een systeemtechnicus de vertolking tijdens het evenement ter plaatse.
Het perspectief van MILA
Voor MILA is de architectuur van een spraaksysteem een centrale technische beslissing. We houden ons bezig met de vraag hoe vertaalkwaliteit, realtime prestaties en lokale verwerking met elkaar kunnen worden gecombineerd.
Lokale verwerking is daarbij een vast onderdeel van ons aanbod: onze AI-simultaantolkdienst draait lokaal op onze eigen techniek op de evenementlocatie, zonder cloud. Wat er gezegd wordt, verlaat het evenement niet.
Daarbij kijken we zowel naar gespecialiseerde afzonderlijke modellen als naar nieuwe geïntegreerde benaderingen. Want de kwaliteit van een systeem voor AI-tolken ontstaat niet door één enkel model. Ze ontstaat door de samenwerking van de gehele verwerkingsketen – van het ingangssignaal via de voorbereiding van de talen tot de begeleiding ter plaatse.
Aan het eind van de keten komt elke taal op een eigen kanaal in de aanwezige tolkinstallatie of conferentietechniek; op verzoek stellen we ontvangers en koptelefoons voor de gasten beschikbaar. Hoe techniek, verloop en aanvullende diensten er in detail uitzien, vindt u op onze pagina over onze diensten. Plant u een meertalig evenement, dan bespreken we graag met u wat uw programma nodig heeft.
