Blog · 10.08.2026
Czy AI potrafi rozróżniać głosy? Rozpoznawanie mówców i klonowanie głosu – wyjaśnienie
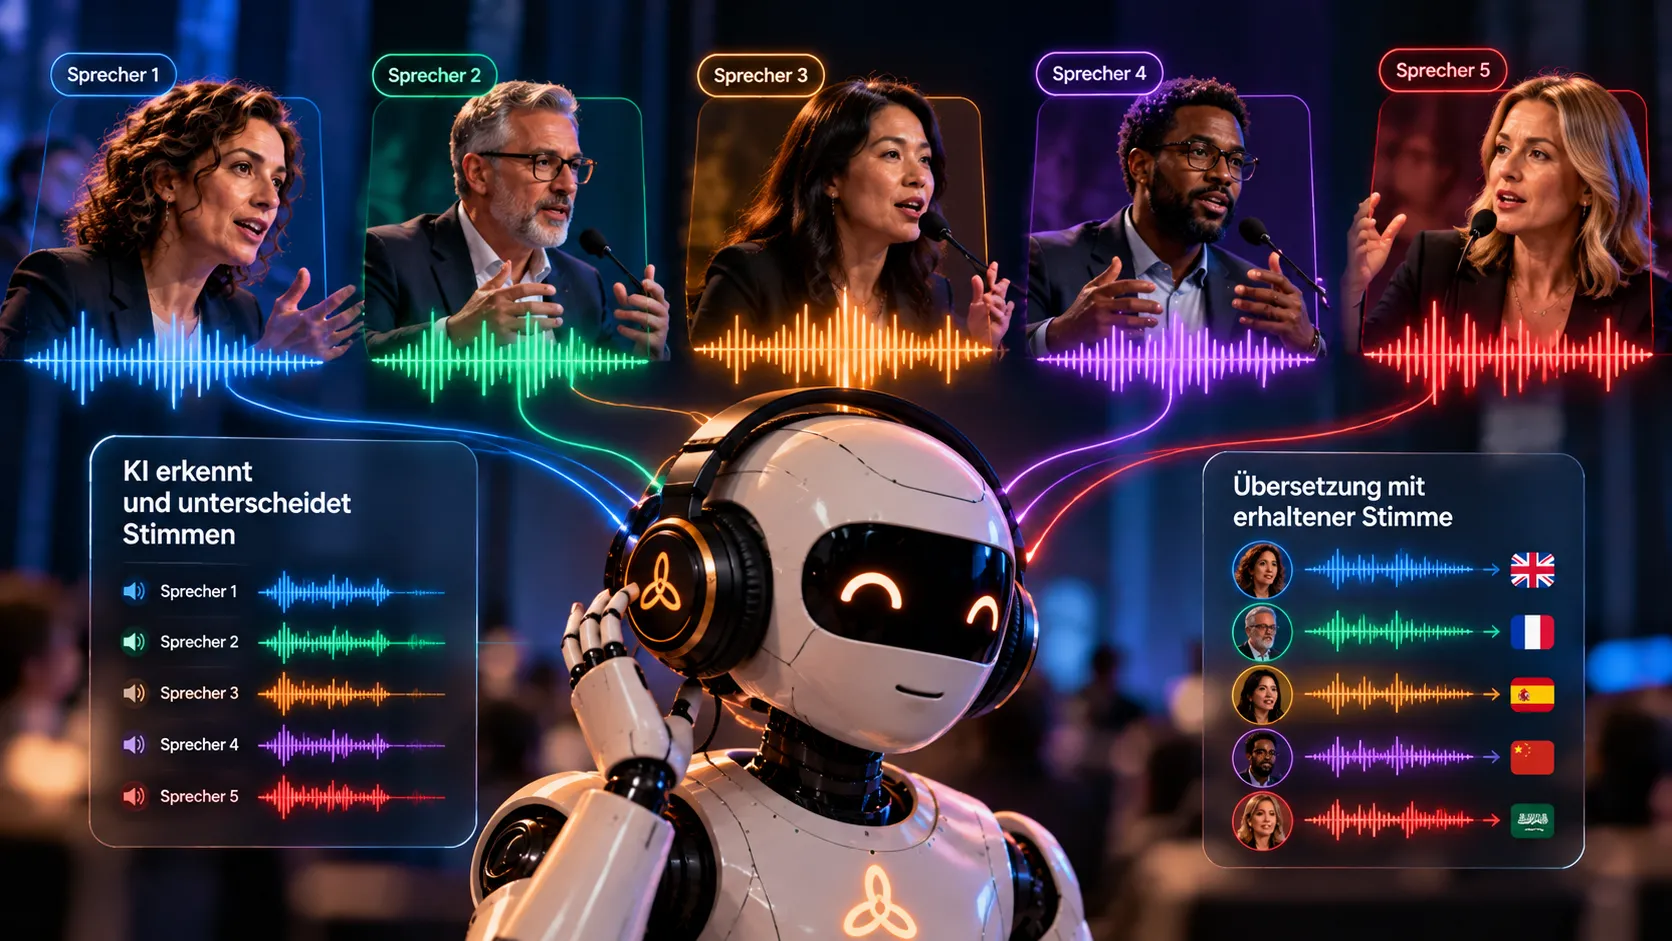
Kto teraz mówi? Podczas klasycznego wystąpienia to pytanie praktycznie się nie pojawia: mówi jedna osoba, a publiczność słucha. Na panelu dyskusyjnym wygląda to inaczej. Kilka osób zabiera głos na zmianę, wchodzi sobie w słowo lub mówi jednocześnie. Dla tłumaczenia symultanicznego wspieranego przez AI oznacza to dodatkowe zadanie: system musi nie tylko rozumieć, co jest mówione, ale w miarę możliwości także rozpoznawać, kto właśnie mówi. Właśnie tego dotyczy rozpoznawanie mówców. W tym artykule wyjaśniamy, jak działa speaker diarization, dlaczego nakładające się wypowiedzi stanowią tak duże wyzwanie, co voice cloning mógłby oznaczać dla tłumaczenia – i jaka odpowiedzialność wiąże się z odtwarzaniem ludzkiego głosu.
Od wystąpienia do panelu: dlaczego pytanie „Kto mówi?” nabiera znaczenia
Niezależnie od tego, czy tłumaczy człowiek, czy AI: format ma ogromne znaczenie dla każdego tłumaczenia. Podczas wystąpienia otwierającego na kongresie czy prezentacji na wydarzeniu firmowym istnieje jedno wyraźne źródło: mikrofon przy mównicy lub zestaw nagłowny osoby na scenie. Wiadomo, kto właśnie mówi.
Podczas panelu dyskusyjnego sytuacja się zmienia. Moderator zadaje pytanie, jeden gość odpowiada, drugi się z nim nie zgadza, trzeci dopowiada coś w połowie zdania. Takie zmiany są zamierzone – to one sprawiają, że dyskusja jest żywa. Dla systemu AI oznaczają jednak, że trzeba jednocześnie rozwiązać dwa zadania:
- Co jest mówione? To podstawa każdego tłumaczenia.
- Kto to mówi? Ta informacja pomaga rozróżniać poszczególne wypowiedzi i czytelnie oddawać zależności między nimi.
Kto śledzi dyskusję w tłumaczeniu, potrzebuje, aby zmiany mówców pozostawały rozpoznawalne. W przeciwnym razie wypowiedzi i repliki szybko zlewają się w jeden strumień.
Rozpoznawanie mówców przez AI: co daje speaker diarization
Fachowe określenie przyporządkowania w czasie fragmentów mowy do różnych mówców to speaker diarization. Taki system analizuje cechy akustyczne sygnału i próbuje odróżnić od siebie poszczególne głosy.
Wynikiem jest struktura czasowa. W uproszczeniu może ona wyglądać tak:
- mówca A mówi w pierwszym fragmencie,
- mówca B przejmuje głos,
- mówca C zabiera głos,
- następnie ponownie mówi mówca A.
Istotny jest przy tym punkt, który często bywa pomijany: speaker diarization to nie to samo co identyfikacja osób. System nie musi koniecznie wiedzieć, jakie rzeczywiste osoby stoją za danymi głosami. Wystarczy, że rozpozna głos A i głos B jako różne głosy. To, czy A to moderatorka, a B członek zarządu, pozostaje na potrzeby tego zadania na razie otwarte.
Właśnie ta umiejętność ma znaczenie dla tłumaczenia symultanicznego. Już sama informacja, że teraz mówi inna osoba niż wcześniej, może pomóc w bardziej zrozumiałym oddaniu dyskusji.
Gdy wszyscy mówią naraz: separacja mówców przy nakładających się wypowiedziach
Szczególnie trudno robi się wtedy, gdy kilka osób mówi jednocześnie. W ożywionej dyskusji panelowej zdarza się to regularnie – krótkie wtrącenie, słowo aprobaty, dwie odpowiedzi, które na siebie zachodzą.
Tu do gry wchodzą metody audio source separation. Mają one rozdzielać nakładające się na siebie sygnały mowy. W najlepszym przypadku z mieszaniny ponownie powstają pojedyncze, zrozumiałe głosy.
Jakość takich metod w dużym stopniu zależy jednak od materiału wyjściowego i warunków akustycznych. Im wyraźniej poszczególne głosy są obecne w sygnale, tym łatwiej je rozdzielić. Tego, co już zginęło w dźwięku, nawet zaawansowana separacja nie odzyska w niezawodny sposób.
Co to oznacza dla Państwa planowania
Dla organizatorów oznacza to, że pytanie, jak dobrze AI potrafi rozróżniać mówców, jest zawsze także pytaniem o technikę dźwiękową. To, jak mikrofonowanie paneli tworzy podstawę każdego tłumaczenia, szczegółowo opisaliśmy w artykule Tłumaczenie symultaniczne AI a technika audio: dlaczego wszystko zaczyna się od mikrofonu. Jeśli planują Państwo tłumaczenie symultaniczne podczas panelu dyskusyjnego, warto wcześnie wspólnie uzgodnić kwestie dźwięku.
Voice cloning: czy tłumaczenie może zachować głos?
Drugi obszar badań idzie o krok dalej. Zajmuje się syntetycznym odtwarzaniem ludzkiego głosu, często określanym jako voice cloning.
Nowoczesna synteza mowy potrafi przejmować określone cechy głosu i wykorzystywać je do nowych treści językowych. Otwiera to nowe możliwości dla tłumaczenia: prelegent mógłby zostać oddany w innym języku, przy częściowym zachowaniu charakterystycznych cech jego głosu.
Słowo „częściowym” zostało tu wybrane celowo. Nie chodzi o to, by w pełni skopiować daną osobę, lecz o to, by tłumaczenie nie brzmiało jak obcy głos, tylko niosło cechy oryginału.
W połączeniu z rozpoznawaniem mówców widać ten potencjał: jeśli system rozpozna, że teraz mówi mówca B, i zachowa cechy jego głosu w języku docelowym, przetłumaczoną dyskusję panelową mogłoby się śledzić znacznie łatwiej. Podobne pytania dotyczą przenoszenia akcentów i ekspresji – więcej na ten temat przeczytają Państwo w naszym artykule Czy AI potrafi tłumaczyć emocje?
Możliwości techniczne i pytania etyczne
Choć technologia jest fascynująca, odtwarzanie ludzkiego głosu wiąże się ze znaczną odpowiedzialnością. Głos jest czymś bardzo osobistym. Kto generuje go syntetycznie, porusza się w obszarze wrażliwym.
Z naszej perspektywy kluczowe są trzy warunki:
- Zgoda: osoba, której głos jest odtwarzany, musi wyrazić na to zgodę.
- Przejrzystość: zwłaszcza w środowisku profesjonalnym musi być jasne, kiedy używany jest głos syntetyczny. Publiczność powinna wiedzieć, że słucha tłumaczenia, a nie samej osoby.
- Ochrona przed nadużyciami: odtworzone głosy nie mogą być wykorzystywane poza uzgodnionym celem.
Dla firm, stowarzyszeń i instytucji publicznych te kwestie nie są abstrakcyjne. Na walnym zgromadzeniu, konferencji branżowej czy posiedzeniu publicznym musi być w każdej chwili jasne, kto co powiedział – i w jakiej formie zostało to oddane.
Perspektywa MILA na rozpoznawanie mówców i zachowanie głosu
Dla przyszłych systemów tłumaczenia symultanicznego AI rozpoznawanie mówców i zachowanie głosu to ważne obszary rozwoju. Zwłaszcza podczas dyskusji panelowych niezawodne przyporządkowanie wypowiedzi do poszczególnych mówców mogłoby poprawić zrozumiałość. Dlatego uważnie obserwujemy te technologie.
Nasze kryterium pozostaje przy tym niezmienne: innowacja techniczna musi wnosić rzeczywistą wartość dodaną do komunikacji. Nowa funkcja ma dla nas sens dopiero wtedy, gdy pomaga Państwa gościom lepiej śledzić wydarzenie.
Podczas Państwa wydarzenia stawiamy dziś na to, co da się niezawodnie zaplanować. Tłumaczenie symultaniczne AI działa lokalnie na naszym własnym sprzęcie w miejscu wydarzenia, bez chmury – wypowiedzi nie opuszczają wydarzenia. Terminy specjalistyczne i nazwy własne z programu konfigurujemy z wyprzedzeniem. Każdy język trafia na osobnym kanale do istniejącego systemu do tłumaczeń symultanicznych lub techniki konferencyjnej, a na życzenie z odbiornikami i słuchawkami dla gości. A technik systemowy jest zawsze na miejscu: planuje z Państwem, montuje sprzęt, obsługuje tłumaczenie w trakcie wydarzenia i demontuje sprzęt.
Planują Państwo kongres, konferencję lub wydarzenie firmowe z dyskusją panelową i chcieliby się dowiedzieć, jak można zrealizować dla niego tłumaczenie? Wszystkie szczegóły dotyczące techniki i przebiegu znajdą Państwo na naszej stronie Usługi. Jakie formaty obsługujemy, pokazują nasze Obszary zastosowań – zapraszamy do kontaktu.
