Blog · 19.08.2026
Speech-to-Speech Translation: jak działa nowoczesne tłumaczenie mowy oparte na AI
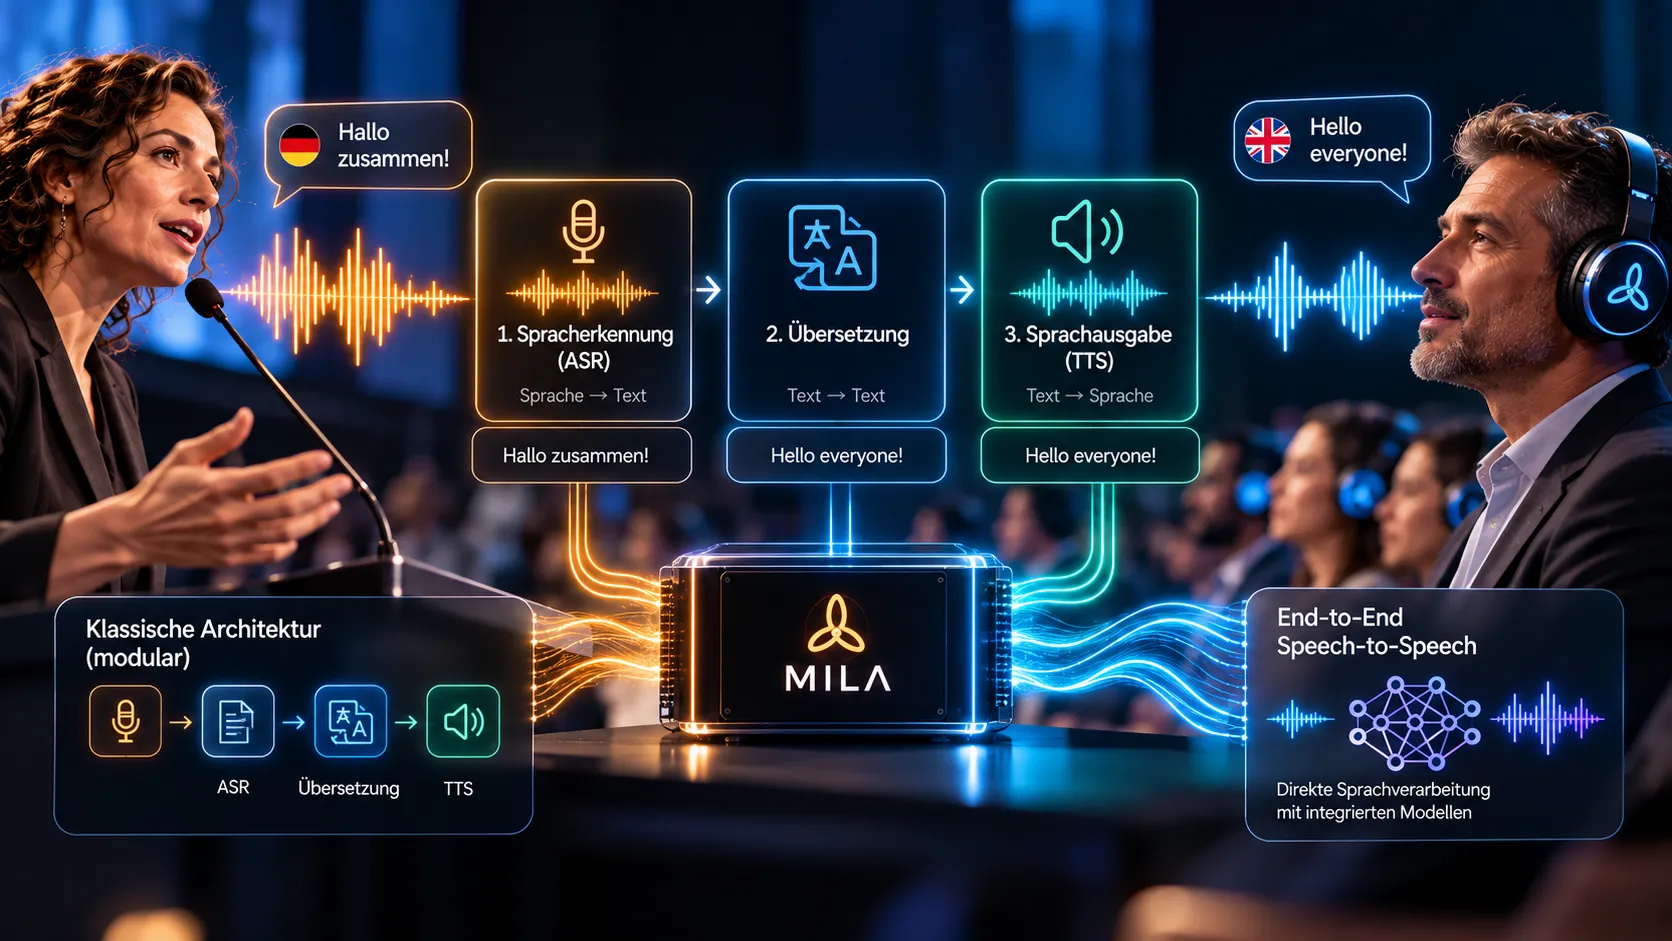
Prelegentka mówi po niemiecku, a goście na sali śledzą wystąpienie przez słuchawki – po angielsku, francusku lub polsku. To, co dla publiczności wygląda na jeden proces, od strony technicznej składa się z kilku zadań, które muszą ściśle ze sobą współgrać. Właśnie tego dotyczy Speech-to-Speech Translation, czyli tłumaczenie mowy na mowę. W tym artykule wyjaśniamy, jak zbudowany jest klasyczny łańcuch przetwarzania, gdzie leżą jego ograniczenia, jakie nowe architektury AI testują naukowcy – i dlaczego te kwestie są istotne także dla Państwa jako organizatorów.
Trzy zadania, jeden cel
Profesjonalny system tłumaczenia symultanicznego AI musi łączyć kilka złożonych zadań. Musi:
- rozpoznawać mowę,
- tłumaczyć treść na język docelowy,
- i generować z niej zrozumiałą wypowiedź głosową.
Tłumacz symultaniczny wykonuje to wszystko w jednej głowie: słucha, rozumie, przekłada, mówi. W maszynowym tłumaczeniu symultanicznym zadania te tradycyjnie rozdziela się między różne modele, z których każdy specjalizuje się w swojej części. Czym zasadniczo różni się tłumaczenie symultaniczne AI od pracy tłumaczy konferencyjnych, omawiamy w artykule Tłumacz AI czy człowiek: czy tłumacz symultaniczny stanie się zbędny?
Podział na kilka modeli ma zalety, ale też ograniczenia techniczne – jednym i drugim warto przyjrzeć się bliżej.
Klasyczny łańcuch przetwarzania w Speech-to-Speech Translation
W klasycznej formie Speech-to-Speech Translation przebiega w trzech następujących po sobie krokach. Wynik każdego kroku stanowi dane wejściowe dla kolejnego.
Krok 1: Automatyczne rozpoznawanie mowy (ASR)
Na początku jest automatyczne rozpoznawanie mowy, w skrócie ASR (Automatic Speech Recognition). Przekształca ono sygnał audio – np. z mikrofonu na mównicy – w tekst. Z wypowiedzi powstają słowa i zdania.
Krok 2: Tłumaczenie maszynowe
Następnie model tłumaczenia maszynowego przekłada rozpoznaną treść na język docelowy. Pracuje na tekście dostarczonym przez system rozpoznawania mowy – nie na oryginalnym dźwięku.
Krok 3: Synteza mowy (Text-to-Speech)
W trzecim kroku system Text-to-Speech, w skrócie TTS, generuje z przetłumaczonego tekstu wypowiedź głosową. Ten głos goście słyszą ostatecznie w słuchawkach lub przez system konferencyjny.
Zaleta: każdy komponent można ulepszać osobno
Ta modułowa architektura ma wyraźną zaletę: poszczególne komponenty można optymalizować niezależnie od siebie. Jeśli dostępny jest lepszy model dla jednego z kroków, można go zastosować bez konieczności opracowywania od nowa pozostałych elementów. Każdą część łańcucha można celowo sprawdzić, dostosować i wymienić.
Gdzie leżą wyzwania
Choć łańcuch jest przejrzysty, niesie ze sobą zasadnicze wyzwania.
Każdy etap przetwarzania wymaga czasu
Rozpoznawanie mowy, tłumaczenie i synteza mowy odbywają się po kolei, a każdy z tych kroków wymaga czasu. W tłumaczeniu symultanicznym, w którym goście mają śledzić program możliwie na bieżąco, jest to kluczowy czynnik.
Błędy przechodzą przez cały łańcuch
Kolejne wyzwanie jest mniej oczywiste: błędy mogą być przekazywane z jednego komponentu do następnego. Jeśli system rozpoznawania mowy błędnie zinterpretuje jakieś pojęcie, model tłumaczenia otrzymuje już nieprawidłowe informacje. Może wtedy przetłumaczyć poprawnie – ale właśnie to, co błędne. Synteza mowy na końcu odtwarza ten błąd w słyszalnej formie.
Szczególnie newralgiczne jest to w przypadku terminów specjalistycznych i nazw własnych, które stale pojawiają się na kongresach i konferencjach branżowych. Jeden błędnie rozpoznany termin może nadać zdaniu inne znaczenie. Dlatego pierwszy krok jest tak ważny – a wraz z nim jakość sygnału wejściowego. Dlaczego dźwięk decyduje o tak wielu rzeczach, opisujemy w artykule Tłumaczenie AI a technika audio: dlaczego wszystko zaczyna się od mikrofonu.
End-to-End Speech-to-Speech Translation: bardziej bezpośrednia droga
Alternatywny obszar badań zajmuje się modelami, które przetwarzają informacje językowe bardziej bezpośrednio. Mówi się wtedy o End-to-End Speech-to-Speech Translation. Takie systemy mogą ograniczać niektóre kroki pośrednie lub ściślej łączyć je wewnętrznie – zamiast ściśle rozdzielonych etapów powstaje bardziej zintegrowana ścieżka przetwarzania.
Co mogą zachować modele zintegrowane
Atrakcyjność tego podejścia wynika z tego, co może zostać utracone w klasycznym łańcuchu. Gdy tylko mowa zostaje przekształcona w tekst, pozostają przede wszystkim słowa. Cechy głosu, prozodia – czyli akcent, rytm i melodia mowy – oraz część kontekstu językowego nie znajdują odzwierciedlenia w tekście.
Podejścia zintegrowane otwierają nowe możliwości przenoszenia również takich informacji. Na jakim etapie są badania np. nad przenoszeniem emocji i gdzie leżą granice, podsumowaliśmy w artykule Czy AI potrafi tłumaczyć emocje?
Nie ma automatycznego skrótu
Systemy zintegrowane nie są jednak automatycznie szybsze ani bardziej niezawodne tylko dlatego, że mają mniej oddzielnych kroków pośrednich. Należy uwzględnić również ich sterowalność i możliwości dostosowania.
W przypadku zastosowania podczas wydarzeń nie jest to sprawa drugorzędna: kto chce wcześniej skonfigurować terminy specjalistyczne i nazwy własne oraz nadzorować tłumaczenie w trakcie wydarzenia, potrzebuje systemu, w którym można precyzyjnie wprowadzać zmiany.
Architektura modułowa czy zintegrowana?
Oba podejścia mają zalety: systemy modułowe można wymieniać i optymalizować element po elemencie. Modele zintegrowane mogą zachować informacje takie jak prozodia i cechy głosu, które giną przy pośrednim przetwarzaniu tekstowym. Która architektura jest lepsza, zależy od wymagań – uniwersalnej odpowiedzi nie ma.
Co to oznacza dla Państwa wydarzenia
Jako organizator, agencja, firma lub stowarzyszenie nie muszą Państwo oceniać architektur modeli. Liczy się to, by Państwa goście mogli śledzić program w swoim języku – czy to na kongresie, podczas walnego zgromadzenia, czy na posiedzeniu publicznym. Mimo to wiedza o łańcuchu przetwarzania pomaga przy planowaniu tłumaczenia symultanicznego na Państwa wydarzenie. Niektóre czynniki można bowiem kształtować z wyprzedzeniem:
- Dźwięk: Ponieważ wszystko zaczyna się od rozpoznawania mowy, czysty sygnał z mikrofonu współdecyduje o tym, co trafia do kolejnych kroków.
- Program: Terminy specjalistyczne i nazwy własne znane z wyprzedzeniem można przygotować. W MILA konfigurujemy je przed wydarzeniem.
- Nadzór: Tłumaczenie symultaniczne wspierane przez AI nie powinno działać bez nadzoru. U nas technik systemowy nadzoruje tłumaczenie na miejscu w trakcie wydarzenia.
Perspektywa MILA
Dla MILA architektura systemu językowego to kluczowa decyzja techniczna. Zajmujemy się pytaniem, jak połączyć jakość tłumaczenia, działanie w czasie rzeczywistym i lokalne przetwarzanie.
Lokalne przetwarzanie jest przy tym stałym elementem naszej oferty: nasze tłumaczenie symultaniczne AI działa lokalnie na naszym własnym sprzęcie w miejscu wydarzenia, bez chmury. Wypowiedzi nie opuszczają wydarzenia.
Analizujemy przy tym zarówno wyspecjalizowane pojedyncze modele, jak i nowe podejścia zintegrowane. Jakość systemu tłumaczenia symultanicznego AI nie wynika bowiem z jednego modelu. Powstaje dzięki współdziałaniu całego łańcucha przetwarzania – od sygnału wejściowego, przez przygotowanie języków, po nadzór na miejscu.
Na końcu łańcucha każdy język trafia osobnym kanałem do istniejącego systemu do tłumaczeń symultanicznych lub systemu konferencyjnego; na życzenie zapewniamy odbiorniki i słuchawki dla gości. Szczegóły dotyczące sprzętu, przebiegu i usług dodatkowych znajdą Państwo na naszej stronie Usługi. Jeśli planują Państwo wydarzenie wielojęzyczne, chętnie porozmawiamy o tym, czego potrzebuje Państwa program.
