Blog · 11.08.2026
Tłumaczenie symultaniczne z AI: gdy maszyna słucha, tłumaczy i mówi
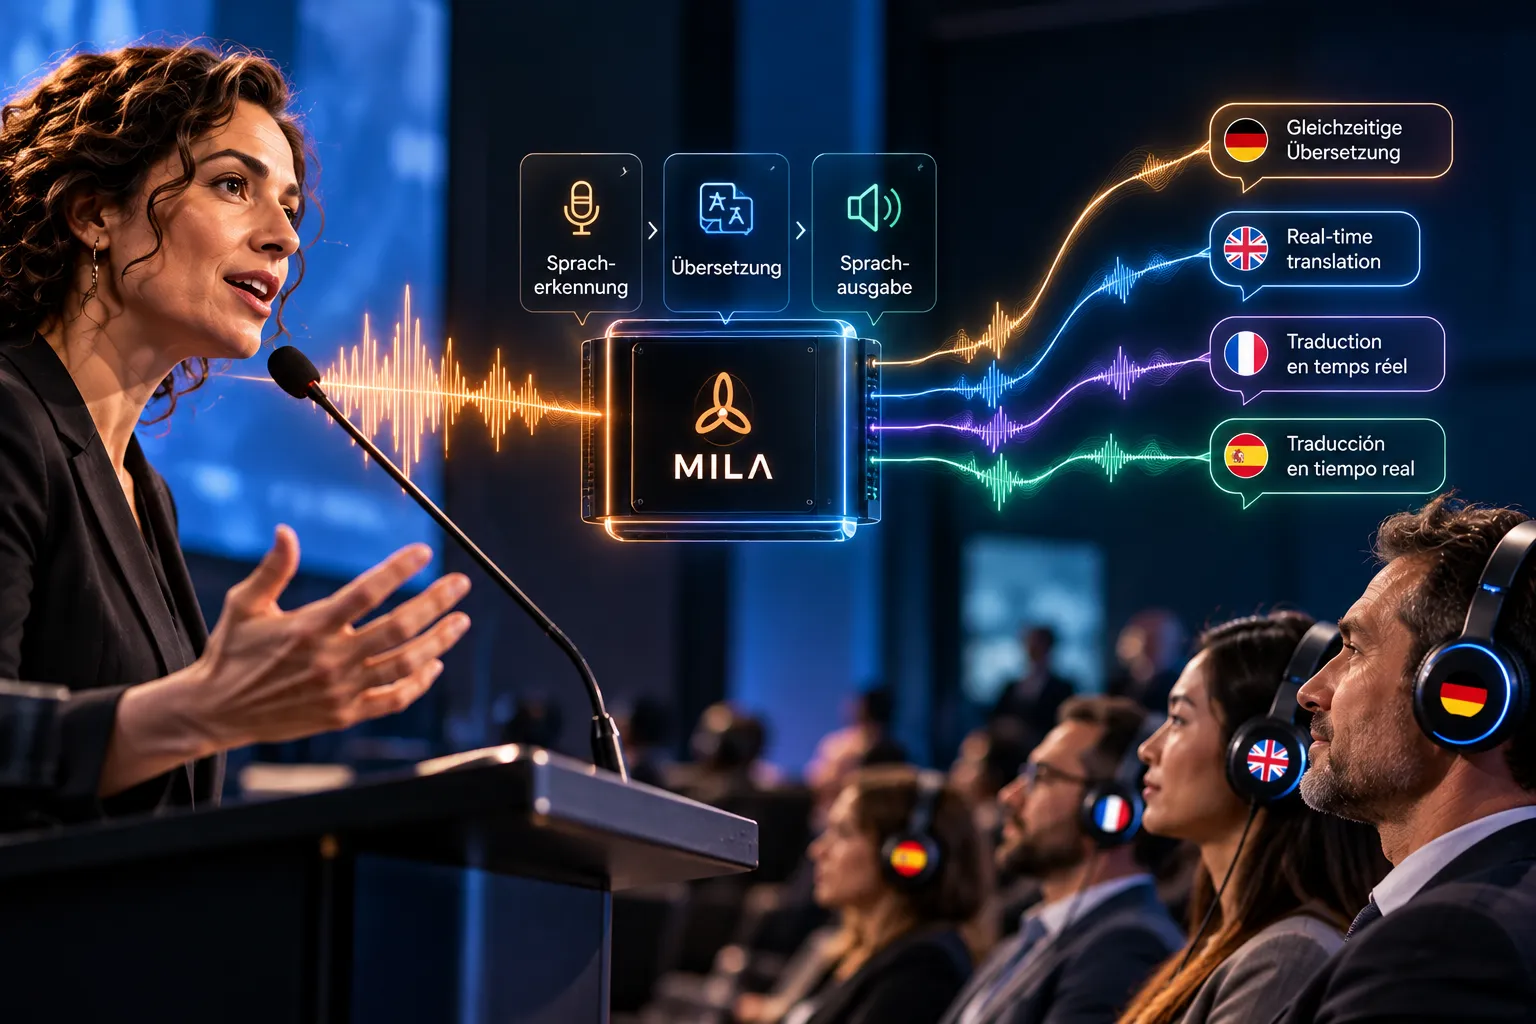
Prelegentka rozpoczyna na podium długie niemieckie zdanie, a kluczowy czasownik pojawia się dopiero na samym końcu. Tłumacz symultaniczny słucha, porządkuje treść i zaczyna mówić, zanim zdanie dobiegnie końca. Tłumacz AI stoi przed dokładnie tym samym zadaniem: musi jednocześnie słuchać, tłumaczyć i mówić. To, jak sobie z tym radzi, w dużej mierze zależy od jego architektury. Dotychczas wiele systemów do tłumaczenia symultanicznego działa w kilku następujących po sobie etapach. Nowe podejścia badawcze próbują ściślej powiązać te etapy przetwarzania. W tym artykule wyjaśniamy najważniejsze podejścia, ich zalety i wady oraz to, dlaczego kwestia architektury ma znaczenie także dla Państwa jako organizatorów.
Klasyczny pipeline: ASR, tłumaczenie, synteza mowy
Sprawdzona budowa systemu tłumaczenia AI to łańcuch złożony z trzech elementów:
- Rozpoznawanie mowy (ASR, Automatic Speech Recognition): Model zamienia słowo mówione na tekst.
- Tłumaczenie (Translation): Drugi model przenosi ten tekst na język docelowy.
- Synteza mowy (TTS, Text-to-Speech): Sztuczny głos wypowiada tłumaczenie.
Każdy element wykonuje jasno określone zadanie i przekazuje swój wynik kolejnemu. Dlatego mówi się o architekturze modułowej lub o potoku przetwarzania (pipeline).
Co przemawia za budową modułową
Największą zaletą jest przejrzystość. Pomiędzy etapami powstają wyniki, które można obejrzeć i sprawdzić – przede wszystkim transkrypcja po rozpoznaniu mowy. Jeśli słowo zostanie błędnie przetłumaczone, można ustalić, czy zostało źle rozpoznane już wcześniej, czy zmienione dopiero podczas tłumaczenia.
Ponadto poszczególne elementy można optymalizować lub wymieniać osobno. Terminy fachowe i nazwy własne można wprowadzić dokładnie tam, gdzie są potrzebne, na przykład przy rozpoznawaniu nazwy produktu lub przy tłumaczeniu terminu specjalistycznego. A gdy pojawi się lepszy model dla danego etapu, nie trzeba przebudowywać całego systemu.
Gdzie pipeline napotyka ograniczenia
Łańcuch ma również słabe strony. Błędy się przenoszą: to, co system rozpoznawania mowy źle zrozumie, kolejny etap przetłumaczy tak, jak zostało rozpoznane, a nie tak, jak było zamierzone. Ponadto sumują się czasy przetwarzania poszczególnych etapów.
Trzecia kwestia dotyczy sposobu mówienia. Przy zamianie na tekst łatwo giną informacje takie jak akcent, tempo mówienia czy ironia. Czego nie ma już w tekście, tego synteza mowy na końcu również nie jest w stanie oddać. Temu zagadnieniu poświęciliśmy osobny artykuł: Czy AI potrafi tłumaczyć emocje?
End-to-End Speech-to-Speech Translation
W tym miejscu pojawia się dziedzina badań, która w ostatnich latach zyskała wiele uwagi: End-to-End Speech-to-Speech Translation. Idea jest następująca: jeden model przyjmuje mowę i bezpośrednio generuje mowę w języku docelowym, bez konieczności przechodzenia przez zapisany tekst.
Wynikają z tego potencjalne korzyści. Mniej przekazań między poszczególnymi modelami może przyspieszyć przetwarzanie. A ponieważ model pracuje na samym dźwięku, istnieje szansa, że przeniesie także cechy pierwotnego sposobu mówienia.
Po drugiej stronie stoją wyzwania. Zintegrowany model jest trudniejszy do zrozumienia: jeśli nie ma widocznego etapu pośredniego, trudniej przypisać błąd do jego przyczyny. Również celowe sterowanie, na przykład narzucenie określonych terminów fachowych, nie jest w zamkniętym modelu tak łatwo możliwe jak w pipelinie.
Modele AI natywnie przetwarzające dźwięk: brzmienie jako osobne źródło informacji
Ściśle powiązane z tym podejściem są tak zwane modele AI natywnie przetwarzające dźwięk (audio-native). Przetwarzają one sygnały audio bezpośrednio, zamiast pracować wyłącznie z tekstem. Dzięki temu mogą co do zasady wykorzystywać informacje zawarte wyłącznie w dźwięku, na przykład pauzy lub akcenty.
Granice między podejściami coraz bardziej się przy tym zacierają. W badaniach istnieją też formy mieszane, łączące elementy łańcucha modułowego z modelami zintegrowanymi. Dlatego pytanie coraz rzadziej brzmi „pipeline czy end-to-end?”, lecz raczej: które części przetwarzania powinny być ściśle powiązane, a gdzie sensowny jest widoczny, sterowalny etap pośredni? Żadne z podejść nie jest z góry lepsze. To, która architektura ma sens, zależy od tego, co w danym zastosowaniu liczy się najbardziej.
Niezależnie od architektury obowiązuje zasada: każdy model może pracować tylko z sygnałem, który do niego dociera. Dlaczego dźwięk stoi na początku każdego tłumaczenia, przeczytają Państwo w naszym artykule Tłumaczenie AI a technika audio: dlaczego wszystko zaczyna się od mikrofonu.
Streaming: tłumaczenie symultaniczne, zanim zdanie się skończy
W przypadku tłumaczenia symultanicznego na konferencji lub kongresie nie wystarczy dobrze tłumaczyć. System musi też robić to w sposób ciągły. Nie może czekać, aż prelegentka zakończy wystąpienie, lecz musi przetwarzać tok wypowiedzi w małych fragmentach. Tę zasadę nazywa się przetwarzaniem strumieniowym (streaming).
Wynika z tego podstawowy kompromis:
- Wczesne tłumaczenie oznacza krótkie opóźnienie, ale mniej kontekstu. System może być zmuszony tłumaczyć, zanim stanie się jasne, dokąd zmierza zdanie.
- Dłuższe słuchanie oznacza więcej kontekstu, a tym samym lepszą podstawę, ale też większy dystans do oryginału.
Przykład z początku pokazuje, dlaczego jest to tak wymagające: w języku niemieckim czasownik często stoi na końcu zdania, a w wielu językach docelowych pojawia się wcześnie. System strumieniowy musi więc zdecydować, jak długo czekać. Do tego dochodzi fakt, że tekst można jeszcze poprawić w tle, a słowa już wypowiedzianego w języku docelowym – nie.
Które kierunki rozwoju są szczególnie istotne dla systemów czasu rzeczywistego
W przypadku zastosowań na żywo podczas wydarzeń szczególnie ważne są naszym zdaniem cztery kierunki rozwoju:
- Modele obsługujące streaming, które radzą sobie z niedokończonymi zdaniami i dobrze wyważają opóźnienie i kontekst.
- Sterowalność, aby terminy fachowe, nazwy produktów i nazwy własne z programu niezawodnie docierały w takiej formie, w jakiej zostały zamierzone.
- Możliwość monitorowania, aby w trakcie wydarzenia w każdej chwili było widać, co system aktualnie rozpoznaje i generuje.
- Wydajność, aby wydajne modele mogły działać również na sprzęcie na miejscu, zamiast polegać na odległych centrach danych.
Co architektura oznacza dla Państwa wydarzenia
Nie potrzebują Państwo specjalistycznej wiedzy o modelach językowych. Architektura systemu tłumaczeniowego decyduje jednak o tym, jak elastycznie można go optymalizować, monitorować i rozwijać. I właśnie to odczują Państwo w praktyce: gdy nazwa Państwa głównego sponsora zostanie poprawnie przekazana, gdy termin fachowy z Państwa branży będzie trafny lub gdy w razie problemu ktoś szybko zareaguje.
Dlatego w MILA nie traktujemy tłumaczenia symultanicznego jako interfejsu, który wystarczy podłączyć, lecz jako cały łańcuch przetwarzania – od mikrofonu po słuchawki. W praktyce oznacza to:
- Terminy fachowe i nazwy własne z Państwa programu konfigurujemy z wyprzedzeniem.
- Tłumaczenie symultaniczne AI działa lokalnie na naszym własnym sprzęcie w miejscu wydarzenia, bez chmury. Wypowiedzi nie opuszczają Państwa wydarzenia.
- Technik systemowy jest zawsze na miejscu. Planuje wszystko razem z Państwem, montuje sprzęt, nadzoruje tłumaczenie w trakcie wydarzenia, a następnie demontuje sprzęt.
- Każdy język trafia na osobnym kanale do Państwa istniejącego systemu do tłumaczeń symultanicznych lub techniki konferencyjnej; na życzenie zapewniamy odbiorniki i słuchawki dla gości.
Badania nad systemami speech-to-speech rozwijają się szybko, a my uważnie je śledzimy. Jeśli chcą Państwo dowiedzieć się, jak może wyglądać tłumaczenie symultaniczne na Państwa kongresie, konferencji lub wydarzeniu firmowym, szczegóły dotyczące techniki i przebiegu znajdą Państwo na naszej stronie Usługi. Odpowiedzi na najczęstsze pytania zebraliśmy w naszym FAQ.
