Blog · 11.8.2026
Simultanübersetzung mit KI: Wenn die Maschine zuhört, übersetzt und spricht
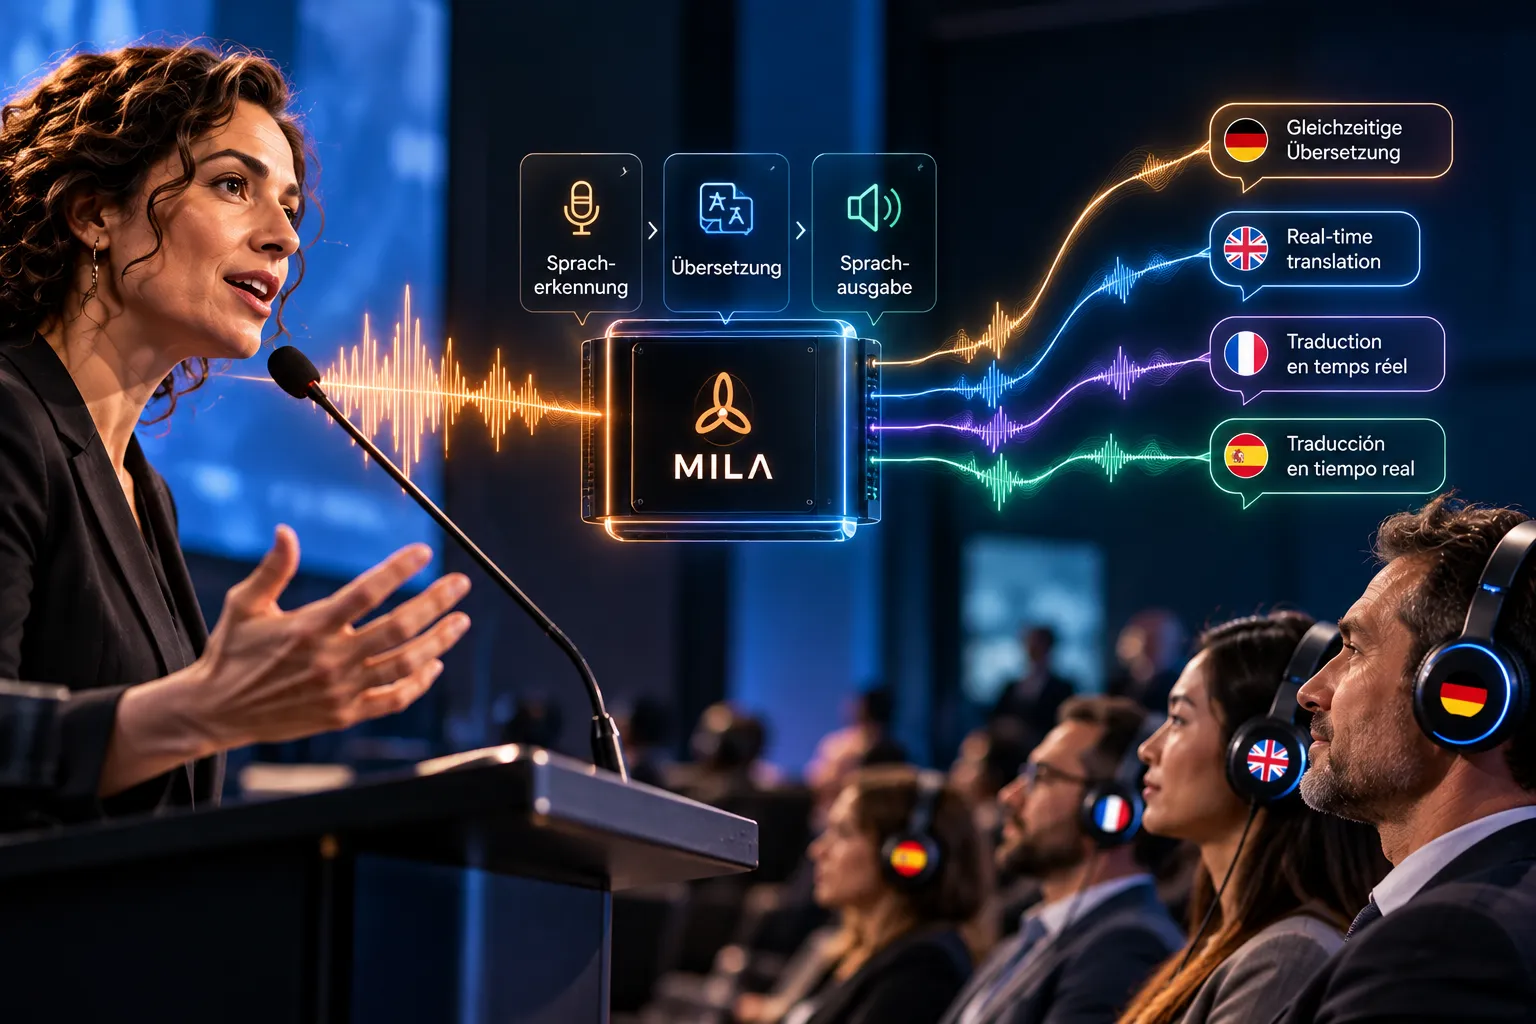
Eine Rednerin beginnt auf dem Podium einen langen deutschen Satz, und das entscheidende Verb steht ganz am Ende. Ein menschlicher Simultandolmetscher hört zu, ordnet ein und beginnt zu sprechen, bevor der Satz vollständig ist. Ein KI-Dolmetscher steht vor genau derselben Aufgabe: Er muss gleichzeitig zuhören, übersetzen und sprechen. Wie er das löst, hängt stark von seiner Architektur ab. Bislang arbeiten viele Systeme für die Simultanübersetzung in mehreren aufeinanderfolgenden Schritten. Neue Forschungsansätze versuchen, diese Verarbeitung enger miteinander zu verbinden. In diesem Beitrag erklären wir die wichtigsten Ansätze, ihre Vor- und Nachteile und warum die Frage nach der Architektur auch für Sie als Veranstaltende relevant ist.
Die klassische Pipeline: ASR, Übersetzung, Sprachausgabe
Der bewährte Aufbau eines KI-Dolmetschsystems ist eine Kette aus drei Bausteinen:
- Spracherkennung (ASR, Automatic Speech Recognition): Ein Modell wandelt das gesprochene Wort in Text um.
- Übersetzung (Translation): Ein zweites Modell überträgt diesen Text in die Zielsprache.
- Sprachausgabe (TTS, Text-to-Speech): Eine künstliche Stimme spricht die Übersetzung aus.
Jeder Baustein erledigt eine klar umrissene Aufgabe und übergibt sein Ergebnis an den nächsten. Man spricht deshalb von einer modularen Architektur oder einer Pipeline.
Was für den modularen Aufbau spricht
Der größte Vorteil liegt in der Transparenz. Zwischen den Schritten entstehen Ergebnisse, die sich ansehen und prüfen lassen, allen voran das Transkript nach der Spracherkennung. Wird ein Wort falsch übersetzt, lässt sich nachvollziehen, ob es schon falsch erkannt wurde oder erst bei der Übersetzung verändert wurde.
Außerdem lassen sich die Bausteine einzeln optimieren oder austauschen. Fachbegriffe und Eigennamen können gezielt dort eingebracht werden, wo sie gebraucht werden, etwa bei der Erkennung eines Produktnamens oder bei der Übersetzung eines Fachterminus. Und wenn ein besseres Modell für einen Teilschritt verfügbar wird, muss nicht das gesamte System neu aufgebaut werden.
Wo die Pipeline an Grenzen stößt
Die Kette hat auch Schwächen. Fehler setzen sich fort: Was die Spracherkennung falsch versteht, übersetzt die nächste Stufe so, wie es erkannt wurde, nicht so, wie es gemeint war. Zudem summieren sich die Verarbeitungszeiten der einzelnen Schritte.
Ein dritter Punkt betrifft die Sprechweise. Bei der Umwandlung in Text gehen Informationen wie Betonung, Sprechtempo oder Ironie leicht verloren. Was im Text nicht mehr steht, kann die Sprachausgabe am Ende auch nicht wiedergeben. Diesem Thema haben wir einen eigenen Beitrag gewidmet: Kann KI Emotionen übersetzen?
End-to-End Speech-to-Speech Translation
Hier setzt ein Forschungsfeld an, das in den vergangenen Jahren stark an Aufmerksamkeit gewonnen hat: die End-to-End Speech-to-Speech Translation. Die Idee: Ein einziges Modell nimmt gesprochene Sprache auf und erzeugt direkt gesprochene Sprache in der Zielsprache, ohne zwingend den Umweg über einen ausgeschriebenen Text zu gehen.
Daraus ergeben sich mögliche Vorteile. Weniger Übergaben zwischen einzelnen Modellen können die Verarbeitung beschleunigen. Und weil das Modell mit dem Klang selbst arbeitet, besteht die Chance, Eigenschaften der ursprünglichen Sprechweise mit zu übertragen.
Dem stehen Herausforderungen gegenüber. Ein integriertes Modell ist schwerer zu durchschauen: Wenn es keinen sichtbaren Zwischenschritt gibt, lässt sich ein Fehler schwerer einer Ursache zuordnen. Auch die gezielte Steuerung, etwa die Vorgabe bestimmter Fachbegriffe, ist bei einem geschlossenen Modell nicht ohne Weiteres so möglich wie in einer Pipeline.
Audio-native KI-Modelle: Klang als eigene Informationsquelle
Eng verwandt mit diesem Ansatz sind sogenannte audio-native KI-Modelle. Sie verarbeiten Audiosignale direkt, statt ausschließlich mit Text zu arbeiten. Dadurch können sie grundsätzlich Informationen nutzen, die nur im Klang enthalten sind, etwa Pausen oder Betonungen.
Die Grenzen zwischen den Ansätzen verschwimmen dabei zunehmend. In der Forschung gibt es auch Mischformen, die Elemente einer modularen Kette mit integrierten Modellen verbinden. Die Frage lautet deshalb immer seltener „Pipeline oder End-to-End?“, sondern eher: Welche Teile der Verarbeitung sollten eng verbunden sein, und wo ist ein sichtbarer, steuerbarer Zwischenschritt sinnvoll? Keiner der Ansätze ist pauschal überlegen. Welche Architektur sinnvoll ist, hängt davon ab, was im jeweiligen Einsatz am meisten zählt.
Unabhängig von der Architektur gilt: Jedes Modell kann nur mit dem Signal arbeiten, das bei ihm ankommt. Warum der Ton am Anfang jeder Übersetzung steht, lesen Sie in unserem Beitrag KI-Dolmetschen und Audiotechnik: Warum alles am Mikrofon beginnt.
Streaming: Simultanübersetzung, bevor der Satz zu Ende ist
Für eine Simultanübersetzung auf einer Konferenz oder einem Kongress reicht es nicht, gut zu übersetzen. Das System muss es auch fortlaufend tun. Es kann nicht warten, bis eine Rednerin ihren Vortrag beendet hat, sondern muss den Redefluss in kleinen Abschnitten verarbeiten. Dieses Prinzip nennt man Streaming-Verarbeitung.
Daraus ergibt sich eine grundlegende Abwägung:
- Früh übersetzen bedeutet kurze Verzögerung, aber weniger Kontext. Das System muss womöglich übersetzen, bevor klar ist, wohin der Satz führt.
- Länger zuhören bedeutet mehr Kontext und damit eine bessere Grundlage, aber auch mehr Abstand zum Original.
Das Beispiel vom Anfang zeigt, warum das so anspruchsvoll ist: Im Deutschen steht das Verb oft am Satzende, in vielen Zielsprachen kommt es früh. Ein Streaming-System muss also entscheiden, wie lange es abwartet. Hinzu kommt: Text lässt sich im Hintergrund noch korrigieren, ein bereits gesprochenes Wort in der Zielsprache nicht mehr.
Welche Entwicklungen für Echtzeitsysteme besonders relevant sind
Für den Live-Einsatz bei Veranstaltungen sind aus unserer Sicht vor allem vier Entwicklungen wichtig:
- Streaming-fähige Modelle, die mit unvollständigen Sätzen umgehen und die Balance zwischen Verzögerung und Kontext gut treffen.
- Steuerbarkeit, damit Fachbegriffe, Produktnamen und Eigennamen aus dem Programm verlässlich so ankommen, wie sie gemeint sind.
- Überwachbarkeit, damit während der Veranstaltung jederzeit erkennbar ist, was das System gerade erkennt und ausgibt.
- Effizienz, damit leistungsfähige Modelle auch auf Technik vor Ort laufen können, statt auf entfernte Rechenzentren angewiesen zu sein.
Was die Architektur für Ihre Veranstaltung bedeutet
Sie brauchen kein Fachwissen über Sprachmodelle. Die Architektur eines Dolmetschsystems bestimmt aber, wie flexibel es sich optimieren, überwachen und weiterentwickeln lässt. Und genau das merken Sie im Einsatz: wenn der Name Ihres Hauptsponsors korrekt übertragen wird, wenn ein Fachbegriff aus Ihrer Branche sitzt oder wenn bei einem Problem schnell jemand eingreifen kann.
Bei MILA verstehen wir die Simultanübersetzung deshalb nicht als Schnittstelle, die man einfach anschließt, sondern als gesamte Verarbeitungskette vom Mikrofon bis zum Kopfhörer. Konkret heißt das:
- Fachbegriffe und Eigennamen aus Ihrem Programm richten wir vorab ein.
- Die KI-Simultanübersetzung läuft lokal auf unserer eigenen Technik am Veranstaltungsort, ohne Cloud. Gesprochenes verlässt Ihre Veranstaltung nicht.
- Ein Systemtechniker ist immer vor Ort. Er plant mit Ihnen, baut auf, betreut die Übersetzung während der Veranstaltung und baut wieder ab.
- Jede Sprache kommt auf einem eigenen Kanal in Ihre vorhandene Dolmetscheranlage oder Konferenztechnik; auf Wunsch stellen wir Empfänger und Kopfhörer für die Gäste bereit.
Die Forschung zu Speech-to-Speech-Systemen entwickelt sich schnell, und wir verfolgen sie genau. Wenn Sie wissen möchten, wie eine Simultanübersetzung für Ihren Kongress, Ihre Konferenz oder Ihre Firmenveranstaltung aussehen kann, finden Sie Details zu Technik und Ablauf auf unserer Seite zu den Leistungen. Antworten auf häufige Fragen haben wir in unseren FAQ zusammengestellt.
