Blog · 19.8.2026
Speech-to-Speech Translation: Wie moderne KI-Sprachübersetzung funktioniert
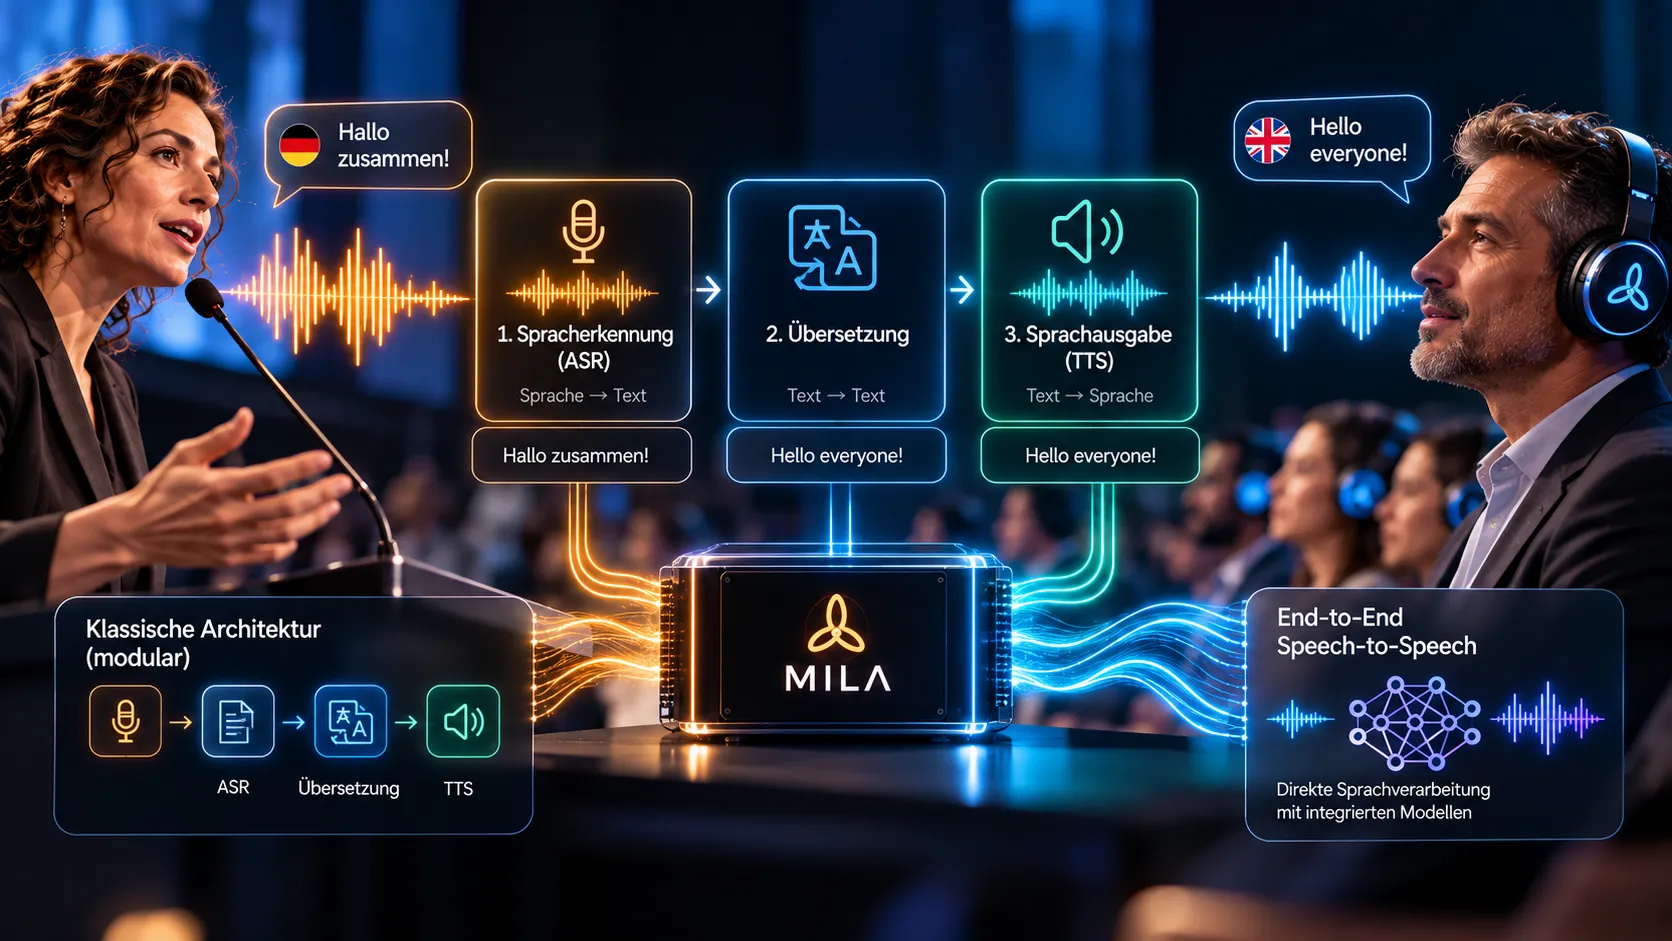
Eine Rednerin spricht Deutsch, im Saal folgen Gäste dem Vortrag über Kopfhörer – auf Englisch, Französisch oder Polnisch. Was für das Publikum wie ein einziger Vorgang wirkt, besteht technisch aus mehreren Aufgaben, die eng ineinandergreifen müssen. Genau darum geht es bei der Speech-to-Speech Translation, der Übersetzung von gesprochener Sprache in gesprochene Sprache. In diesem Beitrag erklären wir, wie die klassische Verarbeitungskette aufgebaut ist, wo ihre Grenzen liegen, welche neuen KI-Architekturen die Forschung erprobt – und warum diese Fragen auch für Sie als Veranstalter relevant sind.
Drei Aufgaben, ein Ziel
Ein professionelles KI-Dolmetschsystem muss mehrere komplexe Aufgaben miteinander verbinden. Es muss:
- gesprochene Sprache erkennen,
- den Inhalt in die Zielsprache übersetzen,
- und daraus eine verständliche Sprachausgabe erzeugen.
Ein menschlicher Simultandolmetscher erledigt all das in einem Kopf: zuhören, verstehen, übertragen, sprechen. Bei einer maschinellen Simultanübersetzung werden diese Aufgaben traditionell auf unterschiedliche Modelle verteilt, von denen jedes auf seinen Teil spezialisiert ist. Wie sich KI-Dolmetschen und menschliche Konferenzdolmetscher grundsätzlich unterscheiden, beleuchten wir im Beitrag KI-Dolmetscher oder Mensch: Wird der Simultandolmetscher überflüssig?
Die Aufteilung auf mehrere Modelle besitzt Vorteile, aber auch technische Grenzen – beides lohnt einen genaueren Blick.
Die klassische Verarbeitungskette der Speech-to-Speech Translation
In ihrer klassischen Form läuft die Speech-to-Speech Translation in drei aufeinanderfolgenden Schritten ab. Das Ergebnis eines Schritts ist jeweils die Eingabe für den nächsten.
Schritt 1: Automatische Spracherkennung (ASR)
Am Anfang steht die automatische Spracherkennung, kurz ASR (Automatic Speech Recognition). Sie wandelt das Audiosignal – etwa vom Mikrofon am Rednerpult – in Text um. Aus dem Gesprochenen werden Wörter und Sätze.
Schritt 2: Maschinelle Übersetzung
Anschließend übersetzt ein maschinelles Übersetzungsmodell den erkannten Inhalt in die Zielsprache. Es arbeitet mit dem Text, den die Spracherkennung geliefert hat – nicht mit dem ursprünglichen Ton.
Schritt 3: Sprachsynthese (Text-to-Speech)
Im dritten Schritt erzeugt ein Text-to-Speech-System, kurz TTS, aus dem übersetzten Text die gesprochene Ausgabe. Diese Stimme hören die Gäste schließlich im Kopfhörer oder über die Konferenztechnik.
Der Vorteil: Jede Komponente lässt sich einzeln verbessern
Diese modulare Architektur hat einen klaren Vorteil: Die einzelnen Komponenten lassen sich unabhängig voneinander optimieren. Steht ein besseres Modell für einen der Schritte zur Verfügung, kann es eingesetzt werden, ohne dass die anderen Bausteine neu entwickelt werden müssen. Jeder Teil der Kette lässt sich gezielt prüfen, anpassen und austauschen.
Wo die Herausforderungen liegen
So übersichtlich die Kette ist – sie bringt grundsätzliche Herausforderungen mit sich.
Jeder Verarbeitungsschritt benötigt Zeit
Spracherkennung, Übersetzung und Sprachsynthese laufen nacheinander ab, und jeder dieser Schritte benötigt Zeit. Bei einer Simultanübersetzung, bei der die Gäste dem Programm möglichst zeitnah folgen sollen, ist das ein zentraler Faktor.
Fehler wandern durch die Kette
Eine weitere Herausforderung ist weniger offensichtlich: Fehler können von einer Komponente an die nächste weitergegeben werden. Wenn die Spracherkennung einen Begriff falsch interpretiert, erhält das Übersetzungsmodell bereits fehlerhafte Informationen. Es übersetzt dann womöglich sauber – aber eben das Falsche. Die Sprachsynthese gibt diesen Fehler am Ende hörbar wieder.
Besonders heikel ist das bei Fachbegriffen und Eigennamen, wie sie auf Kongressen und Fachkonferenzen ständig vorkommen. Ein einziger falsch erkannter Begriff kann einem Satz eine andere Bedeutung geben. Deshalb ist der erste Schritt so wichtig – und mit ihm die Qualität des Eingangssignals. Warum der Ton über vieles entscheidet, beschreiben wir im Beitrag KI-Dolmetschen und Audiotechnik: Warum alles am Mikrofon beginnt.
End-to-End Speech-to-Speech Translation: der direktere Weg
Ein alternatives Forschungsfeld beschäftigt sich mit Modellen, die Sprachinformationen direkter verarbeiten. Man spricht von End-to-End Speech-to-Speech Translation. Solche Systeme können bestimmte Zwischenschritte reduzieren oder intern enger miteinander verbinden – statt streng getrennter Stationen entsteht ein stärker integrierter Verarbeitungsweg.
Was integrierte Modelle erhalten können
Der Reiz dieses Ansatzes liegt in dem, was bei der klassischen Kette verloren gehen kann. Sobald gesprochene Sprache in Text umgewandelt wird, bleiben vor allem die Wörter übrig. Stimmmerkmale, Prosodie – also Betonung, Rhythmus und Sprechmelodie – sowie Teile des sprachlichen Kontexts stehen nicht im Text.
Integrierte Ansätze eröffnen neue Möglichkeiten, solche Informationen mitzuübertragen. Wie weit die Forschung etwa bei der Übertragung von Emotionen ist und wo die Grenzen liegen, haben wir im Beitrag Kann KI Emotionen übersetzen? zusammengefasst.
Keine automatische Abkürzung
Allerdings sind integrierte Systeme nicht automatisch schneller oder zuverlässiger, nur weil sie weniger getrennte Zwischenschritte haben. Auch ihre Kontrollierbarkeit und Anpassbarkeit müssen berücksichtigt werden.
Für den Einsatz bei Veranstaltungen ist das keine Nebensache: Wer Fachbegriffe und Eigennamen vorab einrichten und die Übersetzung während der Veranstaltung betreuen möchte, braucht ein System, an dem sich gezielt ansetzen lässt.
Modulare oder integrierte Architektur?
Beide Ansätze besitzen Vorteile: Modulare Systeme lassen sich Baustein für Baustein austauschen und optimieren. Integrierte Modelle können Informationen wie Prosodie und Stimmmerkmale erhalten, die bei einer textbasierten Zwischenverarbeitung verloren gehen. Welche Architektur besser geeignet ist, hängt von den Anforderungen ab – eine pauschale Antwort gibt es nicht.
Was das für Ihre Veranstaltung bedeutet
Als Veranstalter, Agentur, Unternehmen oder Verband müssen Sie keine Modellarchitekturen bewerten. Für Sie zählt, dass Ihre Gäste dem Programm in ihrer Sprache folgen können – ob auf einem Kongress, bei einer Hauptversammlung oder in einer öffentlichen Sitzung. Trotzdem hilft das Wissen um die Verarbeitungskette, wenn Sie eine Simultanübersetzung für Ihre Veranstaltung planen. Denn einige Faktoren lassen sich vorab beeinflussen:
- Der Ton: Weil alles mit der Spracherkennung beginnt, entscheidet ein sauberes Mikrofonsignal mit darüber, was in den folgenden Schritten ankommt.
- Das Programm: Fachbegriffe und Eigennamen, die vorab bekannt sind, lassen sich vorbereiten. Bei MILA richten wir sie vor der Veranstaltung ein.
- Die Betreuung: Eine KI-gestützte Simultanübersetzung sollte nicht unbeobachtet laufen. Bei uns betreut ein Systemtechniker die Übersetzung während der Veranstaltung vor Ort.
Die MILA-Perspektive
Für MILA ist die Architektur eines Sprachsystems eine zentrale technische Entscheidung. Wir beschäftigen uns mit der Frage, wie sich Übersetzungsqualität, Echtzeitfähigkeit und lokale Verarbeitung miteinander verbinden lassen.
Die lokale Verarbeitung ist dabei ein fester Bestandteil unseres Angebots: Unsere KI-Simultanübersetzung läuft lokal auf unserer eigenen Technik am Veranstaltungsort, ohne Cloud. Gesprochenes verlässt die Veranstaltung nicht.
Dabei betrachten wir sowohl spezialisierte Einzelmodelle als auch neue integrierte Ansätze. Denn die Qualität eines KI-Dolmetschsystems entsteht nicht durch ein einzelnes Modell. Sie entsteht durch das Zusammenspiel der gesamten Verarbeitungskette – vom Eingangssignal über die Vorbereitung der Sprachen bis zur Betreuung vor Ort.
Am Ende der Kette kommt jede Sprache auf einem eigenen Kanal in die vorhandene Dolmetscheranlage oder Konferenztechnik; auf Wunsch stellen wir Empfänger und Kopfhörer für die Gäste bereit. Wie Technik, Ablauf und Zusatzleistungen im Einzelnen aussehen, finden Sie auf unserer Seite zu den Leistungen. Wenn Sie eine mehrsprachige Veranstaltung planen, sprechen wir gern mit Ihnen darüber, was Ihr Programm braucht.
