Blog · 10.8.2026
Kann KI Stimmen unterscheiden? Sprechererkennung und Voice Cloning erklärt
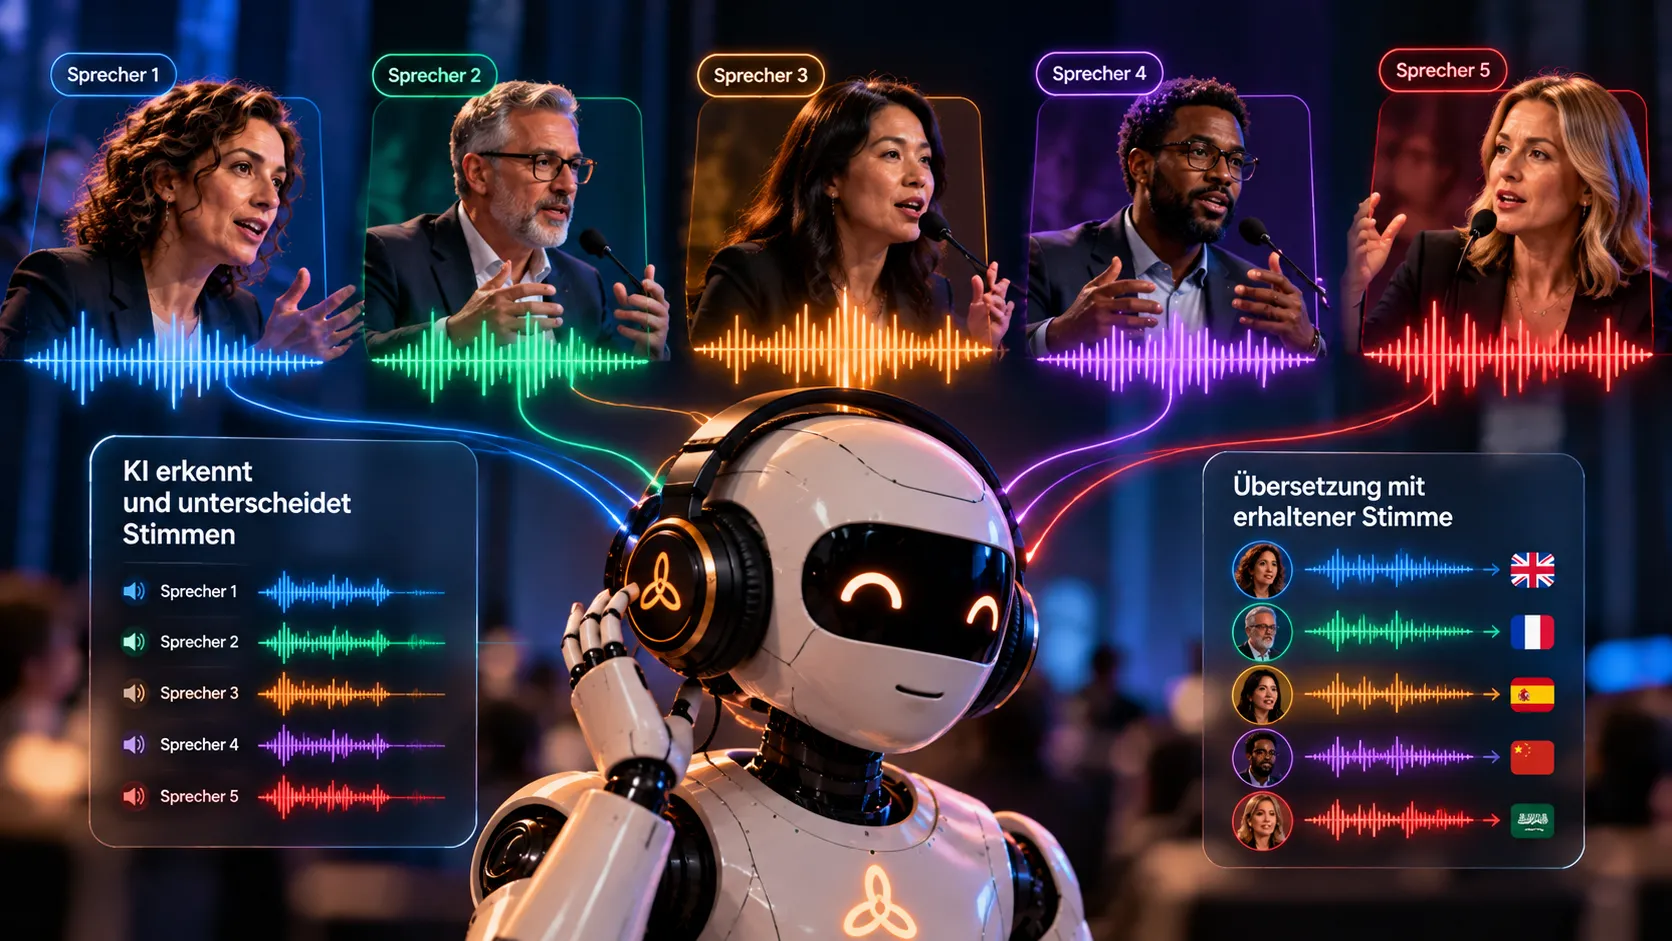
Wer spricht gerade? Bei einem klassischen Vortrag stellt sich diese Frage kaum: Eine Person spricht, das Publikum hört zu. Auf dem Podium sieht das anders aus. Mehrere Personen wechseln sich ab, unterbrechen einander oder sprechen gleichzeitig. Für eine KI-gestützte Simultanübersetzung entsteht dadurch eine zusätzliche Aufgabe: Das System muss nicht nur verstehen, was gesagt wird, sondern möglichst auch erkennen, wer gerade spricht. Genau darum geht es bei der Sprechererkennung. In diesem Beitrag erklären wir, wie Speaker Diarization funktioniert, warum überlappende Sprache so anspruchsvoll ist, was Voice Cloning für die Übersetzung bedeuten könnte – und welche Verantwortung mit der Nachbildung menschlicher Stimmen verbunden ist.
Vom Vortrag zum Podium: Warum die Frage „Wer spricht?“ wichtig wird
Ob Mensch oder KI: Für jede Übersetzung macht das Format einen großen Unterschied. Bei einer Keynote auf einem Kongress oder einer Präsentation auf einer Firmenveranstaltung gibt es eine klare Quelle: das Mikrofon am Rednerpult oder das Headset der Person auf der Bühne. Wer gerade spricht, ist eindeutig.
Bei einer Podiumsdiskussion verschiebt sich das. Die Moderation stellt eine Frage, ein Gast antwortet, ein zweiter widerspricht, ein dritter ergänzt mitten im Satz. Solche Wechsel sind gewollt, sie machen eine Diskussion lebendig. Für ein KI-System bedeuten sie aber, dass zwei Aufgaben gleichzeitig zu lösen sind:
- Was wird gesagt? Das ist die Grundlage jeder Übersetzung.
- Wer sagt es? Diese Information hilft, Beiträge auseinanderzuhalten und Zusammenhänge nachvollziehbar zu machen.
Wer eine Diskussion in der Übersetzung verfolgt, ist darauf angewiesen, dass Wechsel zwischen Sprecherinnen und Sprechern erkennbar bleiben. Sonst verschwimmen Rede und Gegenrede schnell zu einem einzigen Strom.
Sprechererkennung per KI: Was Speaker Diarization leistet
Der Fachbegriff für die zeitliche Zuordnung von Sprachabschnitten zu unterschiedlichen Sprechern lautet Speaker Diarization. Ein solches System analysiert akustische Eigenschaften des Signals und versucht, verschiedene Stimmen voneinander zu unterscheiden.
Das Ergebnis ist eine zeitliche Struktur. Vereinfacht kann sie so aussehen:
- Sprecher A spricht im ersten Abschnitt,
- Sprecher B übernimmt,
- Sprecher C meldet sich zu Wort,
- anschließend spricht wieder Sprecher A.
Wichtig ist dabei ein Punkt, der oft übersehen wird: Speaker Diarization ist nicht dasselbe wie die Identifikation von Personen. Das System muss nicht zwangsläufig wissen, welche realen Menschen hinter den Stimmen stehen. Es reicht, dass es Stimme A und Stimme B als verschiedene Stimmen erkennt. Ob A die Moderatorin und B der Vorstand ist, bleibt für diese Aufgabe zunächst offen.
Für eine Simultanübersetzung ist genau diese Fähigkeit relevant. Schon die Information, dass gerade eine andere Person spricht als vorher, kann helfen, eine Diskussion verständlicher wiederzugeben.
Wenn alle gleichzeitig reden: Sprechertrennung bei überlappender Sprache
Besonders schwierig wird es, wenn mehrere Menschen gleichzeitig sprechen. In einer lebhaften Podiumsdiskussion kommt das regelmäßig vor – ein kurzer Einwurf, ein zustimmendes Wort, zwei Antworten, die sich überschneiden.
Hier kommen Verfahren zur Audio Source Separation ins Spiel. Sie sollen unterschiedliche Sprachsignale, die sich überlagern, voneinander trennen. Im besten Fall entstehen aus einer Mischung wieder einzelne, verständliche Stimmen.
Die Qualität solcher Verfahren hängt allerdings stark vom Ausgangsmaterial und von den akustischen Bedingungen ab. Je klarer die einzelnen Stimmen im Signal enthalten sind, desto besser lassen sie sich auseinanderhalten. Was im Ton bereits untergegangen ist, kann auch eine ausgefeilte Trennung nicht zuverlässig zurückholen.
Was das für Ihre Planung bedeutet
Für Veranstalter heißt das: Die Frage, wie gut eine KI Sprecher unterscheiden kann, ist immer auch eine Frage der Tontechnik. Wie die Mikrofonierung bei Podien die Grundlage jeder Übersetzung legt, haben wir ausführlich im Beitrag KI-Dolmetschen und Audiotechnik: Warum alles am Mikrofon beginnt beschrieben. Wenn Sie eine Simultanübersetzung bei einer Podiumsdiskussion planen, lohnt es sich, den Ton früh gemeinsam abzustimmen.
Voice Cloning: Kann eine Übersetzung die Stimme erhalten?
Ein zweites Forschungsfeld geht noch einen Schritt weiter. Es beschäftigt sich mit der synthetischen Nachbildung menschlicher Stimmen, häufig als Voice Cloning bezeichnet.
Moderne Sprachsynthese kann bestimmte Eigenschaften einer Stimme übernehmen und für neue sprachliche Inhalte verwenden. Für die Übersetzung eröffnen sich dadurch neue Möglichkeiten: Ein Redner könnte in einer anderen Sprache wiedergegeben werden, während charakteristische Eigenschaften seiner Stimme teilweise erhalten bleiben.
Das Wort „teilweise“ ist dabei bewusst gewählt. Es geht nicht darum, eine Person vollständig zu kopieren, sondern darum, dass die Übersetzung nicht mehr wie eine fremde Stimme klingt, sondern Merkmale des Originals mitträgt.
In Kombination mit der Sprechererkennung wird das Potenzial sichtbar: Wenn ein System erkennt, dass gerade Sprecher B spricht, und dessen Stimmeigenschaften in der Zielsprache erhält, könnte eine übersetzte Podiumsdiskussion deutlich leichter zu verfolgen sein. Ähnliche Fragen stellen sich bei der Übertragung von Betonung und Ausdruck – mehr dazu lesen Sie in unserem Beitrag Kann KI Emotionen übersetzen?
Technische Möglichkeiten und ethische Fragen
So spannend die Technik ist: Die Nachbildung menschlicher Stimmen bringt erhebliche Verantwortung mit sich. Eine Stimme ist etwas sehr Persönliches. Wer sie synthetisch erzeugt, bewegt sich in einem sensiblen Bereich.
Drei Voraussetzungen sind aus unserer Sicht zentral:
- Einwilligung: Die Person, deren Stimme nachgebildet wird, muss dem zustimmen.
- Transparenz: Gerade im professionellen Umfeld muss klar sein, wann eine synthetische Stimme verwendet wird. Das Publikum sollte wissen, dass es eine Übersetzung hört und nicht die Person selbst.
- Schutz vor Missbrauch: Nachgebildete Stimmen dürfen nicht außerhalb des vereinbarten Zwecks verwendet werden.
Für Unternehmen, Verbände und öffentliche Einrichtungen sind diese Fragen nicht abstrakt. Auf einer Hauptversammlung, einer Fachkonferenz oder einer öffentlichen Sitzung muss jederzeit nachvollziehbar sein, wer was gesagt hat – und in welcher Form das wiedergegeben wird.
Die MILA-Perspektive auf Sprechererkennung und Stimmerhaltung
Für zukünftige KI-Dolmetschsysteme sind Sprechererkennung und Stimmerhaltung wichtige Entwicklungsfelder. Besonders bei Podiumsdiskussionen könnte eine zuverlässige Zuordnung der Beiträge zu den einzelnen Sprechern die Verständlichkeit verbessern. Wir beobachten diese Technologien deshalb aufmerksam.
Unser Maßstab bleibt dabei derselbe: Technische Innovation muss einen tatsächlichen Mehrwert für die Kommunikation schaffen. Eine neue Funktion ist für uns erst dann sinnvoll, wenn sie Ihren Gästen hilft, einer Veranstaltung besser zu folgen.
Bei Ihrer Veranstaltung setzen wir heute auf das, was sich verlässlich planen lässt. Die KI-Simultanübersetzung läuft lokal auf unserer eigenen Technik am Veranstaltungsort, ohne Cloud – Gesprochenes verlässt die Veranstaltung nicht. Fachbegriffe und Eigennamen aus dem Programm richten wir vorab ein. Jede Sprache kommt auf einem eigenen Kanal in die vorhandene Dolmetscheranlage oder Konferenztechnik, auf Wunsch mit Empfängern und Kopfhörern für die Gäste. Und ein Systemtechniker ist immer vor Ort: Er plant mit Ihnen, baut auf, betreut die Übersetzung während der Veranstaltung und baut wieder ab.
Sie planen einen Kongress, eine Konferenz oder eine Firmenveranstaltung mit Podiumsdiskussion und möchten wissen, wie sich die Übersetzung dafür umsetzen lässt? Alle Details zu Technik und Ablauf finden Sie auf unserer Seite zu den Leistungen. Welche Formate wir begleiten, zeigen unsere Einsatzbereiche – sprechen Sie uns gern an.
