Blog · 14. 8. 2026
Malé jazykové modely: Proč může být při tlumočení menší lepší
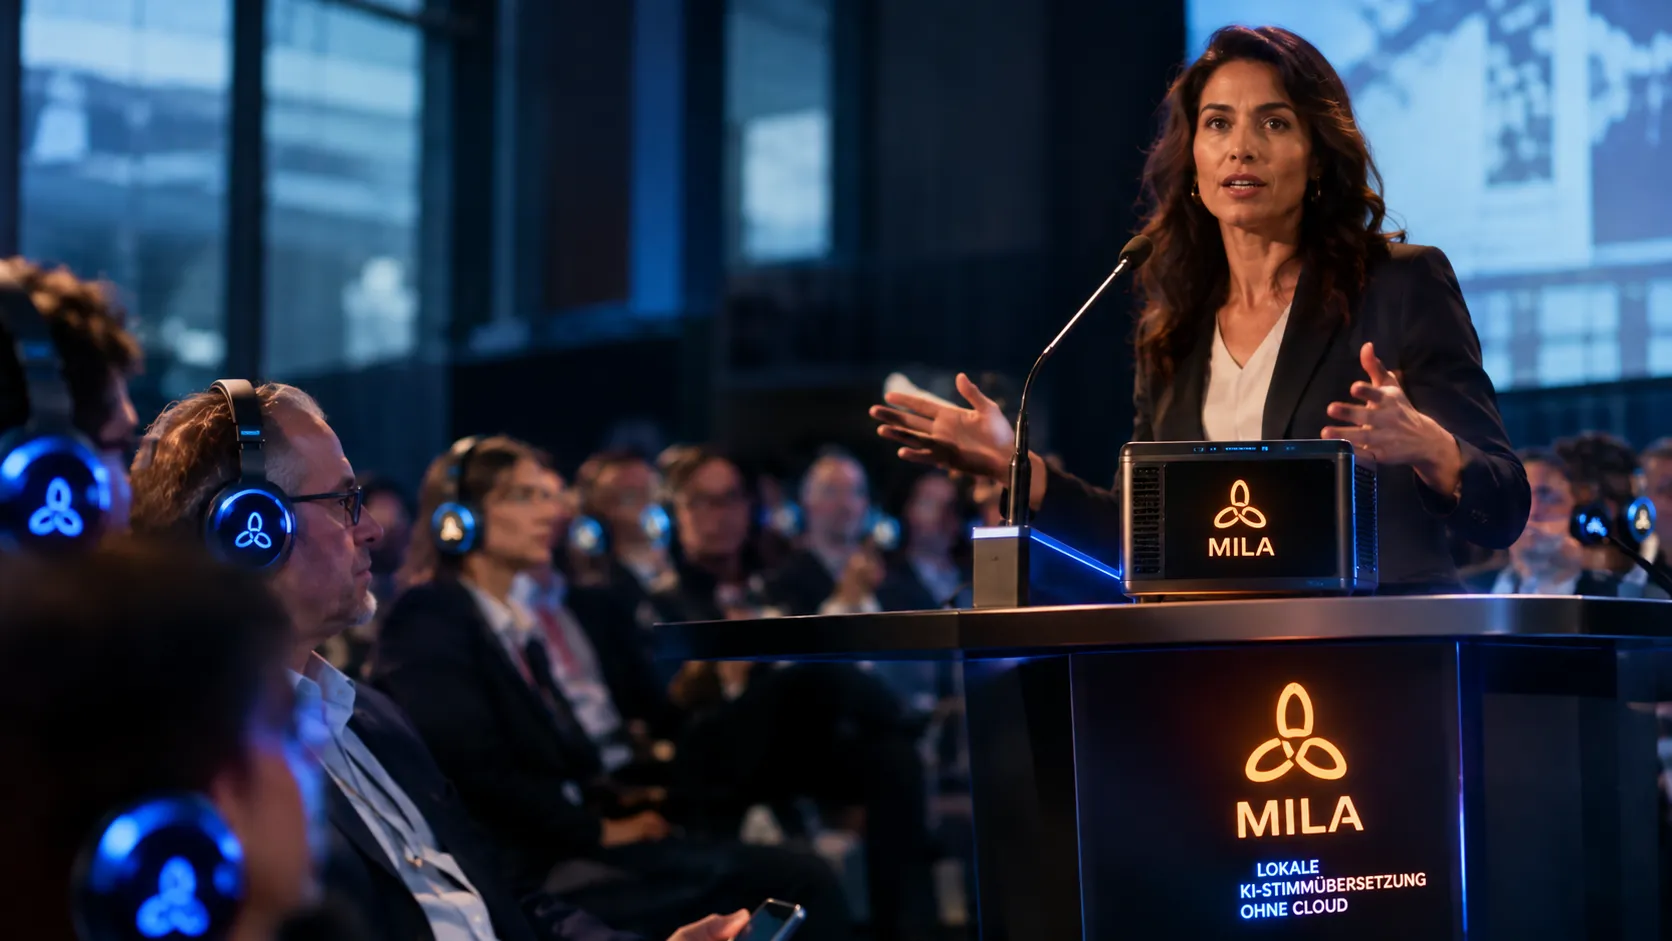
Když se píše o umělé inteligenci, často jde o superlativy: stále více parametrů, stále více trénovacích dat, stále více výpočetního výkonu. Tato cesta umožnila působivý pokrok. U simultánního tlumočení na akcích se však nabízí jiná, velmi praktická otázka: Kolik výkonu AI je ve skutečnosti potřeba? Právě zde přicházejí ke slovu malé jazykové modely. V tomto článku vysvětlujeme, proč jsou specializované a cíleně optimalizované modely zajímavé pro tlumočnické systémy, jaké techniky za nimi stojí – a kde jsou jejich hranice.
Větší neznamená automaticky lepší
Vývoj umělé inteligence byl dlouho formován jednoduchou představou: Více parametrů, více trénovacích dat a více výpočetního výkonu vede k výkonnějším modelům. Tato souvislost není chybná – přinesla mnoho schopností, které dnes působí téměř samozřejmě.
Pro mnoho praktických aplikací však nestačí. Kdo technologii používá v každodenní praxi, neptá se jen na to, co model v zásadě dokáže. Rozhodující je, zda určitý úkol spolehlivě splní – za podmínek, které skutečně panují. Na akci to znamená: s technikou, která je na místě k dispozici, a za běhu programu.
Specializace místo maximální velikosti
Univerzální jazykový model je generalista. Má programovat, psát texty, řešit matematické úlohy a odpovídat na otázky z libovolných oblastí. Tato šíře má svou cenu: Model, který má umět všechno, musí v sobě spojovat velmi mnoho schopností.
Model pro rozpoznávání řeči nebo překlad má naproti tomu jasně vymezený úkol. Má rozpoznat mluvenou řeč nebo převést větu z jednoho jazyka do druhého. Programový kód ani matematické úlohy k tomu nepatří. Takový specializovaný model proto nutně nepotřebuje stejnou šíři schopností jako univerzál.
Díky cílené optimalizaci mohou být menší modely pro určité úkoly velmi výkonné. Přirovnání z dílny: Na konkrétní šroub nepotřebujete celou sadu nářadí, ale ten správný klíč.
Jak se malé jazykové modely stávají efektivnějšími
Existují různé postupy, jak modely zeštíhlit. Dva z nich hrají v současném vývoji obzvlášť důležitou roli: kvantizace a Knowledge Distillation.
Kvantizace: menší přesnost, méně paměti
Jazykový model se v jádru skládá z velkého množství číselných hodnot, takzvaných vah modelu. Při kvantizaci se tyto váhy ukládají a zpracovávají s nižší numerickou přesností – zjednodušeně řečeno: s hrubším odstupňováním čísel namísto velmi jemného rozlišení.
To může výrazně snížit paměťové nároky modelu, a tím i požadavky na hardware.
Metoda má však i svou odvrácenou stranu. V závislosti na postupu a modelu může dojít ke ztrátě části přesnosti. Jak velká tato ztráta bude, nelze paušálně říci. Proto platí: Po každé optimalizaci je nutné kvalitu znovu ověřit. Model, který potřebuje méně paměti, ale přestane spolehlivě rozpoznávat odborné termíny, by pro odbornou konferenci nebyl žádným zlepšením.
Knowledge Distillation: z velkého modelu na malý
Druhým přístupem je takzvaná Knowledge Distillation, volně přeloženo destilace znalostí. Menší model se přitom trénuje s pomocí většího modelu. Velký model do jisté míry přebírá roli učitele, menší roli žáka.
Cílem je zpřístupnit určité schopnosti velkého modelu v efektivnější architektuře. Malý model tedy nemusí ovládat vše, co umí jeho vzor – ale především to, k čemu bude později nasazen.
Proč je to důležité pro simultánní tlumočení
Tři úkoly, které sdílejí zdroje
V profesionálních tlumočnických systémech nepracuje jediný model, ale je nutné provádět několik úkolů současně. Jak tyto kroky klasicky spolupracují, jsme podrobněji popsali v článku Dokáže AI tlumočit emoce?:
- Rozpoznávání řeči: Mluvené slovo je rozpoznáno.
- Překlad: Rozpoznaný obsah je převeden do cílového jazyka.
- Syntéza řeči: Umělý hlas přednese překlad.
Všechny tři kroky soupeří o stejné zdroje: výpočetní výkon a paměť. A to ne jednorázově, ale nepřetržitě – po celou dobu, kdy se na pódiu mluví.
Co mohou efektivnější modely umožnit
Efektivnější modely proto mohou přinést značnou praktickou výhodu. Když každý jednotlivý úkol spotřebuje méně zdrojů, vzniká prostor. Tento prostor možná umožní:
- více paralelních jazykových kanálů, například když hosté sledují akci v několika cílových jazycích,
- nižší nároky na hardware v místě konání,
- kratší dobu zpracování, tedy menší odstup mezi mluveným originálem a tlumočením.
Slovo „možná“ je přitom zvoleno záměrně. Jaká výhoda se v praxi skutečně dostaví, závisí na konkrétním modelu, na optimalizačním postupu a na celém systému – a stejně jako u kvantizace je nutné ji pokaždé ověřit.
Lokální AI: Proč pro nás efektivita není teoretická otázka
V MILA běží AI simultánní tlumočení lokálně na naší vlastní technice v místě konání – bez cloudu. Mluvené slovo neopustí akci. Pro firmy, svazy a veřejné instituce, na jejichž akcích se probírají i důvěrná témata, to může být důležitý bod.
Lokální provoz však také znamená: Výpočty probíhají na technice, kterou si přivezeme. Proto pro nás otázka, kolik výkonu model pro svůj úkol potřebuje, nemá jen akademický význam.
Pro Vás jako pořadatele zůstává průběh přehledný: Každý jazyk přichází na samostatném kanálu do stávajícího tlumočnického zařízení nebo konferenční techniky, na přání zajistíme pro hosty přijímače a sluchátka. Kdo hledá tlumočníka na akci, nemusí se tedy zabývat architekturami modelů – to převezmeme my.
Pohled MILA: Velikost není kritériem kvality
Pro MILA není rozhodující velikost jazykového modelu. Relevantní jsou čtyři kritéria:
- Kvalita tlumočení: Dorazí obsah do cílového jazyka srozumitelně a správně?
- Latence: Kolik času uplyne mezi originálem a tlumočením?
- Stabilita: Funguje systém spolehlivě po celou dobu akce?
- Spotřeba zdrojů: Kolik výpočetního výkonu a paměti je k tomu zapotřebí?
Proto zvlášť sledujeme vývoj efektivních modelů a technologií lokální inference – tedy postupů, jimiž se modely spouštějí přímo na vlastním hardwaru.
Stejně důležité je to, co lze naplánovat nezávisle na modelu: Odborné termíny a vlastní jména z programu nastavíme předem a na místě je vždy systémový technik. Naplánuje vše s Vámi, provede instalaci, během akce se stará o tlumočení a poté techniku opět demontuje. A protože i ten nejlepší model dokáže přeložit jen to, co slyší, hraje stejně velkou roli i zvuk – více v našem článku AI tlumočení a audiotechnika: Proč vše začíná u mikrofonu.
Závěr: Vhodná AI místo té největší
Malé jazykové modely nejsou samoúčelné. Kvantizace a Knowledge Distillation mohou modely zeštíhlit, každá optimalizace se však musí poměřovat kvalitou. U simultánního tlumočení na kongresech, odborných konferencích nebo firemních akcích nakonec rozhoduje to, co dorazí do sálu.
Nejzajímavější AI pro profesionální použití není vždy ta největší – ale ta, která svůj úkol spolehlivě splní.
Pokud plánujete tlumočení na svou příští akci, najdete všechny podrobnosti o technice, jazycích a průběhu na naší stránce Služby. Odpovědi na časté otázky jsme shrnuli v FAQ.
