Blog · 11/08/2026
Interprétation simultanée par IA : quand la machine écoute, traduit et parle
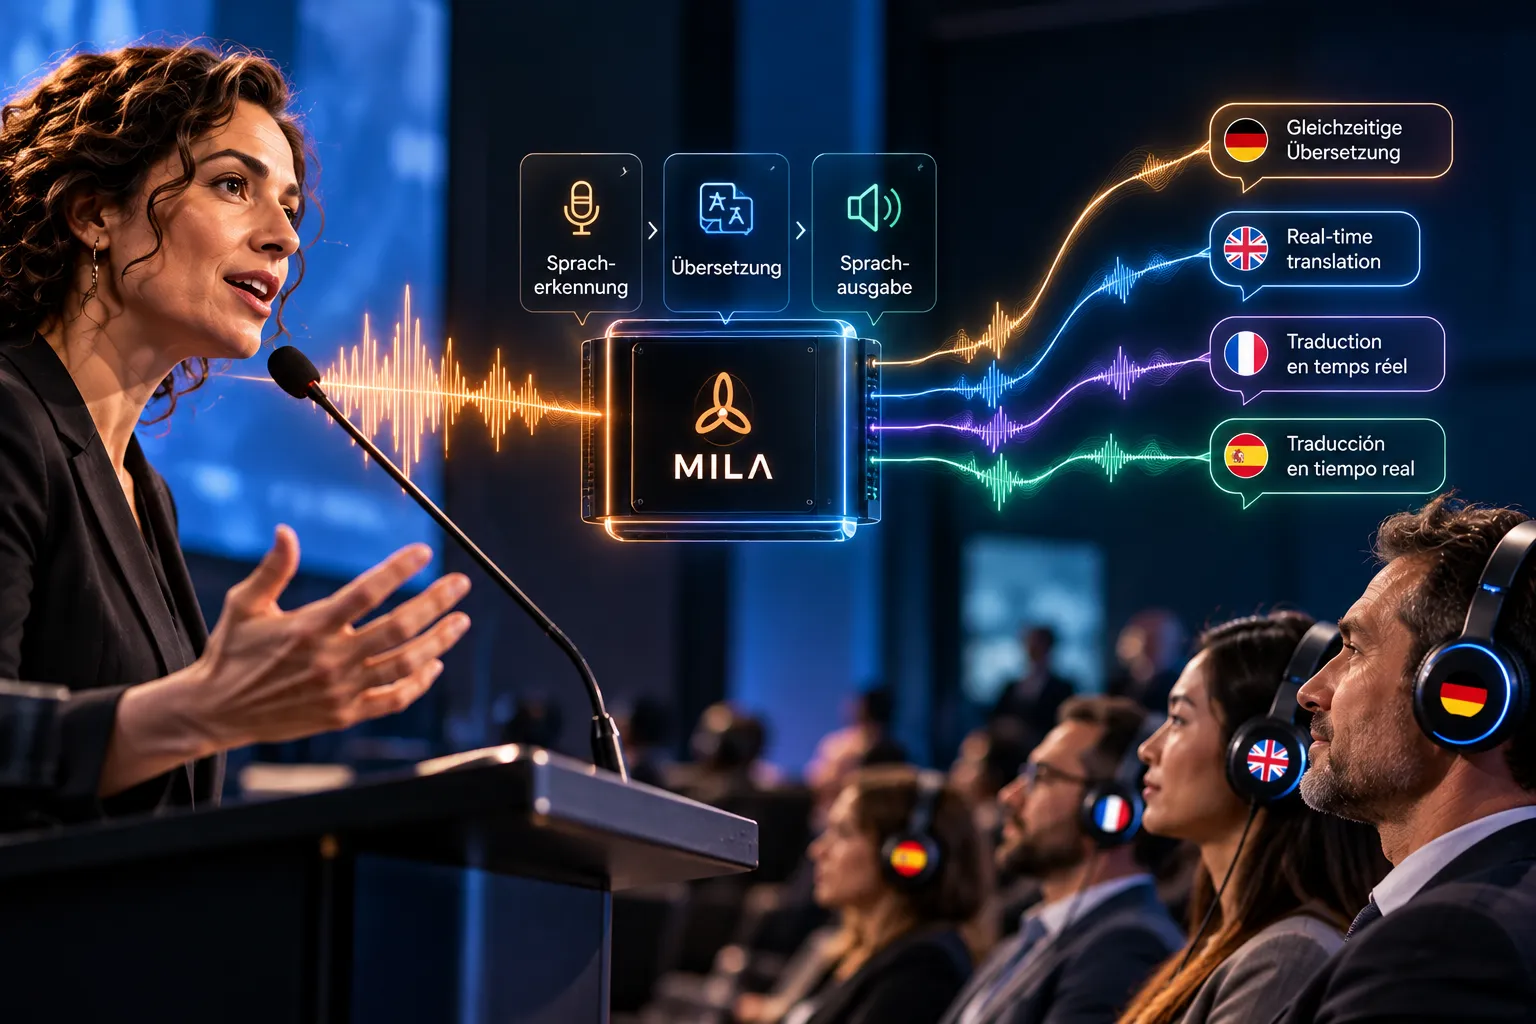
Une intervenante commence à la tribune une longue phrase en allemand, et le verbe décisif se trouve tout à la fin. Un interprète simultané humain écoute, analyse et commence à parler avant que la phrase ne soit terminée. Un interprète IA est confronté exactement à la même tâche : il doit écouter, traduire et parler en même temps. La manière dont il y parvient dépend fortement de son architecture. Jusqu'à présent, de nombreux systèmes d'interprétation simultanée fonctionnent en plusieurs étapes successives. De nouvelles approches de recherche tentent de relier plus étroitement ces traitements. Dans cet article, nous présentons les principales approches, leurs avantages et leurs inconvénients, et expliquons pourquoi la question de l'architecture vous concerne aussi en tant qu'organisateur.
Le pipeline classique : ASR, traduction, synthèse vocale
L'architecture éprouvée d'un système d'interprétation par IA est une chaîne composée de trois briques :
- Reconnaissance vocale (ASR, Automatic Speech Recognition) : un modèle convertit la parole en texte.
- Traduction (Translation) : un deuxième modèle transpose ce texte dans la langue cible.
- Synthèse vocale (TTS, Text-to-Speech) : une voix artificielle prononce la traduction.
Chaque brique remplit une tâche clairement définie et transmet son résultat à la suivante. On parle donc d'une architecture modulaire ou d'un pipeline.
Les atouts de l'architecture modulaire
Le principal avantage réside dans la transparence. Entre les étapes, des résultats intermédiaires apparaissent, que l'on peut consulter et vérifier, à commencer par la transcription issue de la reconnaissance vocale. Si un mot est mal traduit, on peut déterminer s'il a déjà été mal reconnu ou s'il a été modifié seulement lors de la traduction.
Par ailleurs, les briques peuvent être optimisées ou remplacées individuellement. Les termes techniques et les noms propres peuvent être intégrés de manière ciblée là où ils sont nécessaires, par exemple pour la reconnaissance d'un nom de produit ou la traduction d'un terme spécialisé. Et lorsqu'un meilleur modèle devient disponible pour une étape, il n'est pas nécessaire de reconstruire l'ensemble du système.
Les limites du pipeline
La chaîne présente aussi des faiblesses. Les erreurs se propagent : ce que la reconnaissance vocale comprend mal, l'étape suivante le traduit tel qu'il a été reconnu, et non tel qu'il était voulu. De plus, les temps de traitement des différentes étapes s'additionnent.
Un troisième point concerne la manière de parler. Lors de la conversion en texte, des informations comme l'intonation, le débit ou l'ironie se perdent facilement. Ce qui ne figure plus dans le texte, la synthèse vocale ne peut pas non plus le restituer à la fin. Nous avons consacré un article à part entière à ce sujet : L'IA peut-elle traduire les émotions ?
End-to-End Speech-to-Speech Translation
C'est là qu'intervient un domaine de recherche qui a suscité une attention croissante ces dernières années : la End-to-End Speech-to-Speech Translation. L'idée : un modèle unique capte la parole et génère directement de la parole dans la langue cible, sans nécessairement passer par un texte écrit.
Il en découle des avantages potentiels. Moins de transmissions entre modèles distincts peut accélérer le traitement. Et comme le modèle travaille avec le son lui-même, il est possible de transmettre aussi certaines caractéristiques de la manière de parler d'origine.
Ces avantages s'accompagnent de défis. Un modèle intégré est plus difficile à comprendre : sans étape intermédiaire visible, il est plus difficile d'attribuer une erreur à une cause. Le pilotage ciblé, par exemple l'imposition de certains termes techniques, n'est pas non plus aussi simple avec un modèle fermé qu'avec un pipeline.
Modèles d'IA audio natifs : le son comme source d'information à part entière
Étroitement liés à cette approche, les modèles d'IA dits audio natifs traitent directement les signaux audio, au lieu de travailler uniquement avec du texte. Ils peuvent ainsi, en principe, exploiter des informations contenues uniquement dans le son, comme les pauses ou les accentuations.
Les frontières entre les approches s'estompent de plus en plus. La recherche propose aussi des formes hybrides qui combinent des éléments d'une chaîne modulaire avec des modèles intégrés. La question n'est donc plus tant « pipeline ou end-to-end ? », mais plutôt : quelles parties du traitement doivent être étroitement liées, et où une étape intermédiaire visible et pilotable est-elle utile ? Aucune approche n'est supérieure dans l'absolu. L'architecture appropriée dépend de ce qui compte le plus dans chaque cas d'utilisation.
Quelle que soit l'architecture, une règle s'applique : chaque modèle ne peut travailler qu'avec le signal qui lui parvient. Découvrez pourquoi le son est le point de départ de toute traduction dans notre article Interprétation par IA et technique audio : pourquoi tout commence au micro.
Streaming : l'interprétation simultanée avant la fin de la phrase
Pour une interprétation simultanée lors d'une conférence ou d'un congrès, il ne suffit pas de bien traduire. Le système doit aussi le faire en continu. Il ne peut pas attendre qu'une intervenante ait terminé son exposé, mais doit traiter le flux de parole par petits segments. Ce principe s'appelle le traitement en streaming.
Il en résulte un arbitrage fondamental :
- Traduire tôt signifie un faible décalage, mais moins de contexte. Le système doit parfois traduire avant de savoir où mène la phrase.
- Écouter plus longtemps signifie davantage de contexte et donc une meilleure base, mais aussi un écart plus important avec l'original.
L'exemple du début montre pourquoi c'est si exigeant : en allemand, le verbe se trouve souvent en fin de phrase, alors que dans de nombreuses langues cibles, il arrive tôt. Un système de streaming doit donc décider combien de temps il attend. À cela s'ajoute qu'un texte peut encore être corrigé en arrière-plan, mais pas un mot déjà prononcé dans la langue cible.
Les évolutions particulièrement importantes pour les systèmes en temps réel
Pour une utilisation en direct lors d'événements, quatre évolutions sont selon nous particulièrement importantes :
- Des modèles compatibles avec le streaming, capables de gérer des phrases incomplètes et de trouver le bon équilibre entre décalage et contexte.
- La pilotabilité, afin que les termes techniques, les noms de produits et les noms propres du programme soient restitués de manière fiable, tels qu'ils sont voulus.
- La supervision, afin que l'on puisse voir à tout moment pendant l'événement ce que le système reconnaît et restitue.
- L'efficacité, afin que des modèles performants puissent fonctionner sur du matériel sur place, au lieu de dépendre de centres de données distants.
Ce que l'architecture signifie pour votre événement
Vous n'avez pas besoin de connaissances spécialisées sur les modèles de langage. L'architecture d'un système d'interprétation détermine cependant avec quelle flexibilité il peut être optimisé, supervisé et amélioré. Et c'est précisément ce que vous constatez sur le terrain : lorsque le nom de votre sponsor principal est correctement restitué, lorsqu'un terme technique de votre secteur est juste ou lorsque quelqu'un peut intervenir rapidement en cas de problème.
Chez MILA, nous ne concevons donc pas l'interprétation simultanée comme une interface que l'on se contente de brancher, mais comme une chaîne de traitement complète, du micro jusqu'au casque. Concrètement, cela signifie :
- Nous paramétrons à l'avance les termes techniques et les noms propres de votre programme.
- L'interprétation simultanée par IA fonctionne localement sur notre propre matériel sur le lieu de l'événement, sans cloud. Les propos tenus ne quittent pas votre événement.
- Un technicien système est toujours présent sur place. Il planifie avec vous, installe le matériel, assure le suivi de l'interprétation pendant l'événement et démonte ensuite.
- Chaque langue est diffusée sur un canal dédié de votre système d'interprétation ou de votre équipement de conférence existant ; sur demande, nous fournissons des récepteurs et des casques pour les participants.
La recherche sur les systèmes Speech-to-Speech évolue rapidement, et nous la suivons de près. Si vous souhaitez savoir à quoi pourrait ressembler une interprétation simultanée pour votre congrès, votre conférence ou votre événement d'entreprise, vous trouverez des détails sur la technique et le déroulement sur notre page Prestations. Nous avons rassemblé les réponses aux questions fréquentes dans notre FAQ.
