Blog · 19/08/2026
Speech-to-Speech Translation : comment fonctionne la traduction vocale moderne par IA
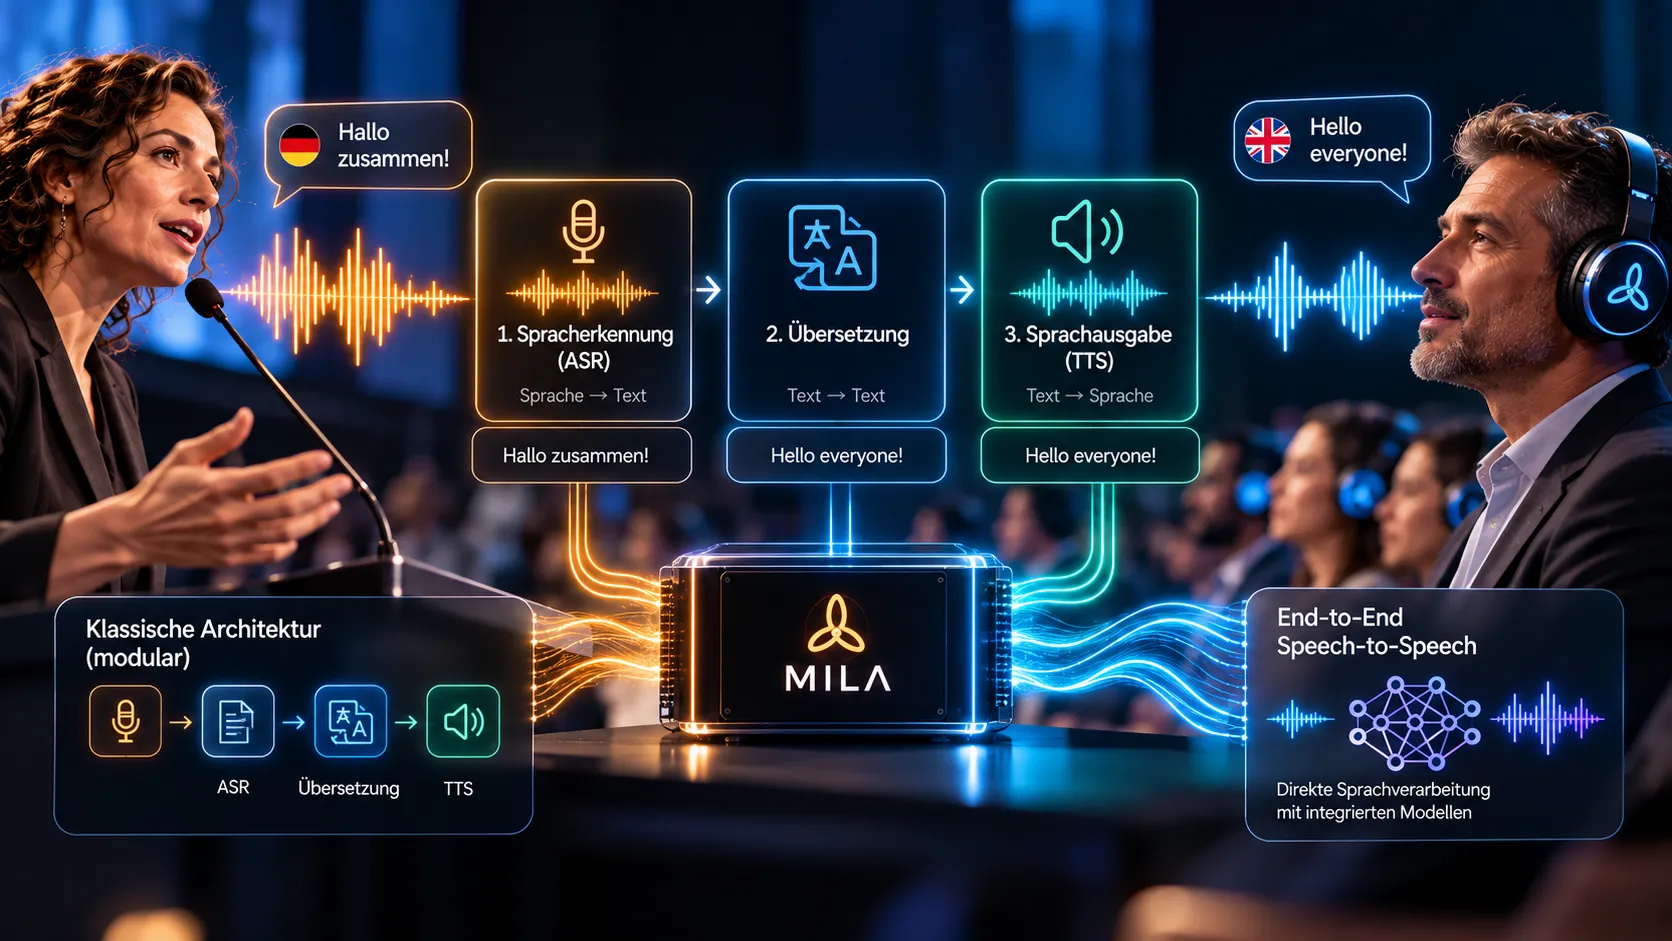
Une intervenante s'exprime en allemand ; dans la salle, les participants suivent son exposé au casque – en anglais, en français ou en polonais. Ce qui semble au public ne former qu'un seul processus repose techniquement sur plusieurs tâches qui doivent s'imbriquer étroitement. C'est précisément l'objet de la Speech-to-Speech Translation, la traduction de la langue parlée vers la langue parlée. Dans cet article, nous expliquons comment la chaîne de traitement classique est construite, quelles sont ses limites, quelles nouvelles architectures d'IA la recherche expérimente – et pourquoi ces questions vous concernent aussi en tant qu'organisateur.
Trois tâches, un objectif
Un système professionnel d'interprétation par IA doit combiner plusieurs tâches complexes. Il doit :
- reconnaître la langue parlée,
- traduire le contenu dans la langue cible,
- et produire à partir de celui-ci une restitution vocale compréhensible.
Un interprète simultané humain accomplit tout cela dans une seule tête : écouter, comprendre, transposer, parler. Dans une interprétation simultanée automatique, ces tâches sont traditionnellement réparties entre différents modèles, chacun spécialisé dans sa partie. Nous examinons les différences fondamentales entre l'interprétation par IA et les interprètes de conférence humains dans l'article Interprète IA ou humain : l'interprète simultané devient-il superflu ?
La répartition entre plusieurs modèles présente des avantages, mais aussi des limites techniques – les deux méritent un examen plus attentif.
La chaîne de traitement classique de la Speech-to-Speech Translation
Dans sa forme classique, la Speech-to-Speech Translation se déroule en trois étapes successives. Le résultat de chaque étape constitue l'entrée de la suivante.
Étape 1 : reconnaissance automatique de la parole (ASR)
Tout commence par la reconnaissance automatique de la parole, ou ASR (Automatic Speech Recognition). Elle convertit le signal audio – par exemple celui du micro du pupitre – en texte. Les paroles prononcées deviennent des mots et des phrases.
Étape 2 : traduction automatique
Un modèle de traduction automatique traduit ensuite le contenu reconnu dans la langue cible. Il travaille avec le texte fourni par la reconnaissance vocale – et non avec le son d'origine.
Étape 3 : synthèse vocale (Text-to-Speech)
À la troisième étape, un système Text-to-Speech, ou TTS, génère la restitution vocale à partir du texte traduit. C'est cette voix que les participants entendent finalement dans leur casque ou via le système de conférence.
L'avantage : chaque composant peut être amélioré séparément
Cette architecture modulaire présente un avantage net : les différents composants peuvent être optimisés indépendamment les uns des autres. Lorsqu'un meilleur modèle est disponible pour l'une des étapes, il peut être intégré sans qu'il soit nécessaire de redévelopper les autres briques. Chaque élément de la chaîne peut être vérifié, ajusté et remplacé de manière ciblée.
Où se situent les défis
Aussi claire que soit cette chaîne, elle s'accompagne de défis fondamentaux.
Chaque étape de traitement prend du temps
La reconnaissance vocale, la traduction et la synthèse vocale se succèdent, et chacune de ces étapes prend du temps. Pour une interprétation simultanée, où les participants doivent suivre le programme avec le moins de décalage possible, c'est un facteur essentiel.
Les erreurs se propagent dans la chaîne
Un autre défi est moins évident : les erreurs peuvent être transmises d'un composant au suivant. Si la reconnaissance vocale interprète mal un terme, le modèle de traduction reçoit déjà des informations erronées. Il traduit alors peut-être correctement – mais justement la mauvaise chose. La synthèse vocale restitue finalement cette erreur de manière audible.
C'est particulièrement délicat pour les termes techniques et les noms propres, omniprésents dans les congrès et les conférences spécialisées. Un seul terme mal reconnu peut donner un autre sens à une phrase. C'est pourquoi la première étape est si importante – et avec elle la qualité du signal d'entrée. Nous expliquons pourquoi le son est déterminant dans l'article Interprétation par IA et technique audio : pourquoi tout commence au micro.
End-to-End Speech-to-Speech Translation : la voie plus directe
Un autre domaine de recherche s'intéresse à des modèles qui traitent les informations vocales de manière plus directe. On parle de End-to-End Speech-to-Speech Translation. Ces systèmes peuvent réduire certaines étapes intermédiaires ou les relier plus étroitement en interne – au lieu de stations strictement séparées, on obtient un processus de traitement plus intégré.
Ce que les modèles intégrés peuvent préserver
L'intérêt de cette approche réside dans ce qui peut se perdre dans la chaîne classique. Dès que la langue parlée est convertie en texte, il ne reste pour l'essentiel que les mots. Les caractéristiques de la voix, la prosodie – c'est-à-dire l'accentuation, le rythme et la mélodie de la parole – ainsi qu'une partie du contexte linguistique ne figurent pas dans le texte.
Les approches intégrées ouvrent de nouvelles possibilités pour transmettre aussi ces informations. Nous avons résumé où en est la recherche, par exemple pour la transmission des émotions, et où se situent les limites dans l'article L'IA peut-elle traduire les émotions ?
Pas de raccourci automatique
Toutefois, les systèmes intégrés ne sont pas automatiquement plus rapides ou plus fiables simplement parce qu'ils comportent moins d'étapes intermédiaires distinctes. Leur contrôlabilité et leur adaptabilité doivent également être prises en compte.
Pour une utilisation lors d'événements, ce n'est pas un détail : si vous souhaitez paramétrer à l'avance les termes techniques et les noms propres et superviser la traduction pendant l'événement, il vous faut un système sur lequel on peut intervenir de manière ciblée.
Architecture modulaire ou intégrée ?
Les deux approches présentent des avantages : les systèmes modulaires peuvent être remplacés et optimisés brique par brique. Les modèles intégrés peuvent préserver des informations comme la prosodie et les caractéristiques de la voix, qui se perdent lors d'un traitement intermédiaire basé sur le texte. L'architecture la mieux adaptée dépend des exigences – il n'existe pas de réponse universelle.
Ce que cela signifie pour votre événement
En tant qu'organisateur, agence, entreprise ou association, vous n'avez pas à évaluer des architectures de modèles. Ce qui compte pour vous, c'est que vos participants puissent suivre le programme dans leur langue – que ce soit lors d'un congrès, d'une assemblée générale ou d'une séance publique. La connaissance de la chaîne de traitement vous aide néanmoins lorsque vous planifiez une interprétation simultanée pour votre événement. Car certains facteurs peuvent être influencés en amont :
- Le son : comme tout commence par la reconnaissance vocale, un signal micro propre contribue à déterminer ce qui parvient aux étapes suivantes.
- Le programme : les termes techniques et les noms propres connus à l'avance peuvent être préparés. Chez MILA, nous les paramétrons avant l'événement.
- La supervision : une interprétation simultanée assistée par IA ne doit pas fonctionner sans surveillance. Chez nous, un technicien système supervise la traduction sur place pendant l'événement.
Le point de vue de MILA
Pour MILA, l'architecture d'un système vocal est une décision technique centrale. Nous nous penchons sur la question de savoir comment concilier qualité de traduction, capacité en temps réel et traitement local.
Le traitement local fait partie intégrante de notre offre : notre interprétation simultanée par IA fonctionne localement sur notre propre matériel sur le lieu de l'événement, sans cloud. Les paroles prononcées ne quittent pas l'événement.
Nous examinons aussi bien des modèles individuels spécialisés que de nouvelles approches intégrées. Car la qualité d'un système d'interprétation par IA ne provient pas d'un modèle unique. Elle naît de l'interaction de l'ensemble de la chaîne de traitement – du signal d'entrée à la supervision sur place, en passant par la préparation des langues.
En bout de chaîne, chaque langue est transmise sur son propre canal au système d'interprétation ou au système de conférence existant ; sur demande, nous mettons à disposition des récepteurs et des casques pour les participants. Vous trouverez le détail de la technique, du déroulement et des prestations complémentaires sur notre page Prestations. Si vous planifiez un événement multilingue, nous serons heureux d'échanger avec vous sur les besoins de votre programme.
