Blog · 14-8-2026
Kleine taalmodellen: waarom kleiner beter kan zijn bij tolken
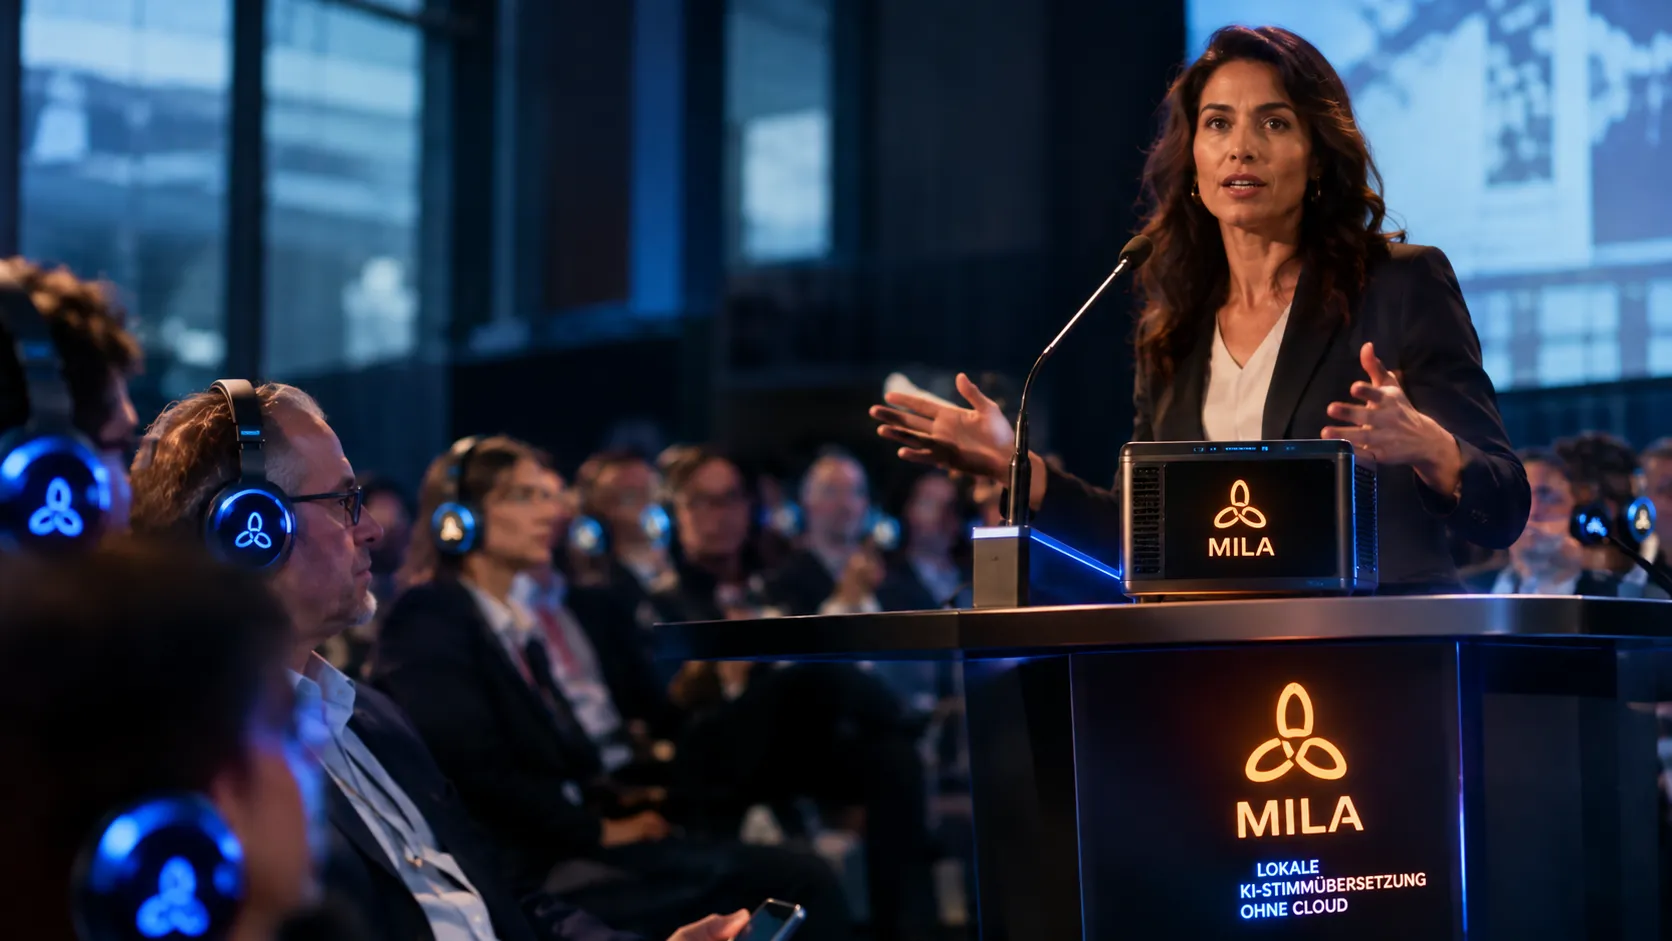
Wanneer er over kunstmatige intelligentie wordt bericht, gaat het vaak om superlatieven: steeds meer parameters, steeds meer trainingsdata, steeds meer rekenkracht. Die weg heeft indrukwekkende vooruitgang mogelijk gemaakt. Voor simultaantolken bij evenementen speelt echter een andere, zeer praktische vraag: hoeveel AI-prestatie is er eigenlijk nodig? Precies hier komen kleine taalmodellen in beeld. In dit artikel leggen we uit waarom gespecialiseerde en gericht geoptimaliseerde modellen interessant zijn voor tolksystemen, welke technieken erachter zitten – en waar de grenzen liggen.
Groter is niet automatisch beter
De ontwikkeling van kunstmatige intelligentie werd lange tijd bepaald door een eenvoudig idee: meer parameters, meer trainingsdata en meer rekenkracht leiden tot krachtigere modellen. Dat verband is niet onjuist – het heeft veel van de mogelijkheden opgeleverd die tegenwoordig bijna vanzelfsprekend lijken.
Voor veel praktische toepassingen schiet het echter tekort. Wie een technologie in de dagelijkse praktijk inzet, vraagt zich niet alleen af wat een model in principe kan. Doorslaggevend is of het een bepaalde taak betrouwbaar uitvoert – onder de omstandigheden die er werkelijk zijn. Bij een evenement betekent dat: met de techniek die ter plaatse beschikbaar is, en terwijl het programma loopt.
Specialisatie in plaats van maximale omvang
Een universeel taalmodel is een generalist. Het moet kunnen programmeren, teksten schrijven, wiskundige problemen oplossen en vragen over willekeurige onderwerpen beantwoorden. Die breedte heeft een prijs: een model dat alles moet kunnen, moet heel veel vaardigheden in zich verenigen.
Een model voor spraakherkenning of vertaling heeft daarentegen een duidelijk afgebakende opdracht. Het moet gesproken taal herkennen of een zin van de ene taal naar de andere overbrengen. Programmacode of wiskundige opgaven horen daar niet bij. Zo'n gespecialiseerd model heeft daarom niet noodzakelijkerwijs dezelfde breedte aan vaardigheden nodig als een allrounder.
Door gerichte optimalisatie kunnen kleinere modellen voor bepaalde taken zeer krachtig zijn. Een vergelijking uit de werkplaats: voor een bepaalde schroef heeft u niet het hele assortiment nodig, maar de passende sleutel.
Hoe kleine taalmodellen efficiënter worden
Er bestaan verschillende methoden om modellen slanker te maken. Twee daarvan spelen in de huidige ontwikkeling een bijzonder belangrijke rol: kwantisatie en knowledge distillation.
Kwantisatie: minder precisie, minder geheugen
Een taalmodel bestaat in de kern uit zeer veel getalwaarden, de zogenaamde modelgewichten. Bij kwantisatie worden deze gewichten met een lagere numerieke precisie opgeslagen en verwerkt – eenvoudig gezegd: met grover afgestufte getallen in plaats van zeer fijn opgeloste.
Dat kan het geheugengebruik van een model aanzienlijk verminderen en daarmee de eisen aan de hardware verlagen.
De methode heeft echter een keerzijde. Afhankelijk van de methode en het model kan daarbij een deel van de nauwkeurigheid verloren gaan. Hoe groot dat verlies uitvalt, valt niet in het algemeen te zeggen. Daarom geldt: na elke optimalisatie moet de kwaliteit opnieuw worden gecontroleerd. Een model dat minder geheugen nodig heeft, maar vaktermen niet meer betrouwbaar herkent, zou voor een vakconferentie geen verbetering zijn.
Knowledge distillation: van groot naar klein model
Een tweede benadering is de zogenaamde knowledge distillation, vrij vertaald kennisdistillatie. Daarbij wordt een kleiner model getraind met behulp van een groter model. Het grote model neemt als het ware de rol van leraar op zich, het kleinere die van leerling.
Het doel is om bepaalde vaardigheden van het grote model bruikbaar te maken in een efficiëntere architectuur. Het kleine model hoeft dus niet alles te beheersen wat zijn voorbeeld kan – maar vooral datgene waarvoor het later wordt ingezet.
Waarom dit relevant is voor simultaantolken
Drie taken die de middelen delen
Bij professionele tolksystemen werkt niet één enkel model, maar moeten meerdere taken tegelijk worden uitgevoerd. Hoe deze stappen klassiek samenwerken, hebben we uitgebreider beschreven in het artikel Kan AI emoties vertalen?:
- Spraakherkenning: het gesproken woord wordt herkend.
- Vertaling: de herkende inhoud wordt naar de doeltaal overgebracht.
- Spraaksynthese: een kunstmatige stem geeft de vertaling weer.
Alle drie de stappen concurreren om dezelfde middelen: rekenkracht en geheugen. En dat niet eenmalig, maar doorlopend – zolang er op het podium wordt gesproken.
Wat efficiëntere modellen mogelijk kunnen maken
Efficiëntere modellen kunnen daarom een aanzienlijk praktisch voordeel bieden. Als elke afzonderlijke taak minder middelen vraagt, ontstaat er ruimte. Die ruimte maakt mogelijk:
- meer parallelle taalkanalen, bijvoorbeeld wanneer gasten een evenement in meerdere doeltalen volgen,
- lagere hardware-eisen op de evenementlocatie,
- kortere verwerkingstijden, dus minder tijd tussen het gesproken origineel en de vertaling.
Het woord ‘mogelijk’ is daarbij bewust gekozen. Welk voordeel zich in de praktijk daadwerkelijk voordoet, hangt af van het betreffende model, de optimalisatiemethode en het totale systeem – en moet, net als bij kwantisatie, telkens opnieuw worden getoetst.
Lokale AI: waarom efficiëntie voor ons geen theoretische kwestie is
Bij MILA draait het AI-simultaantolken lokaal op onze eigen techniek op de evenementlocatie – zonder cloud. Wat er gesproken wordt, verlaat het evenement niet. Voor bedrijven, brancheorganisaties en overheidsinstellingen bij wier evenementen ook vertrouwelijke onderwerpen aan bod komen, kan dat een belangrijk punt zijn.
Lokale verwerking betekent echter ook: er wordt gerekend op de techniek die wij meebrengen. Daarom is de vraag hoeveel rekenkracht een model voor zijn taak nodig heeft voor ons niet alleen van academisch belang.
Voor u als organisator blijft het verloop daarbij overzichtelijk: elke taal komt via een eigen kanaal binnen in de aanwezige tolkinstallatie of conferentietechniek; desgewenst leveren wij ontvangers en koptelefoons voor de gasten. Wie een tolk voor evenementen zoekt, hoeft zich dus niet met modelarchitecturen bezig te houden – dat nemen wij voor onze rekening.
Het MILA-perspectief: omvang is geen kwaliteitscriterium
Voor MILA is niet de omvang van een taalmodel doorslaggevend. Er zijn vier relevante criteria:
- Vertaalkwaliteit: komt de inhoud begrijpelijk en correct over in de doeltaal?
- Latentie: hoeveel tijd zit er tussen origineel en vertaling?
- Stabiliteit: draait het systeem gedurende het hele evenement betrouwbaar?
- Verbruik van middelen: hoeveel rekenkracht en geheugen zijn daarvoor nodig?
We volgen daarom vooral de ontwikkeling van efficiënte modellen en lokale inferentietechnologieën – dat wil zeggen de methoden waarmee modellen direct op eigen hardware worden uitgevoerd.
Minstens zo belangrijk is wat zich onafhankelijk van het model laat plannen: vaktermen en eigennamen uit het programma stellen we vooraf in, en er is altijd een systeemtechnicus ter plaatse. Hij plant met u, bouwt op, begeleidt de vertaling tijdens het evenement en bouwt weer af. En omdat ook het beste model alleen kan vertalen wat het hoort, speelt het geluid een even grote rol – meer daarover in ons artikel AI-tolken en audiotechniek: waarom alles begint bij de microfoon.
Conclusie: de passende AI in plaats van de grootste
Kleine taalmodellen zijn geen doel op zich. Kwantisatie en knowledge distillation kunnen modellen slanker maken, maar elke optimalisatie moet zich bewijzen aan de kwaliteit. Voor simultaantolken bij congressen, vakconferenties of bedrijfsevenementen telt uiteindelijk wat er in de zaal aankomt.
De meest interessante AI is voor professionele toepassingen niet altijd de grootste – maar degene die haar taak betrouwbaar vervult.
Plant u een vertaling voor uw volgende evenement? Alle details over techniek, talen en verloop vindt u op onze pagina over onze diensten. Antwoorden op veelgestelde vragen hebben we verzameld in de FAQ.
