Blog · 14.08.2026
Małe modele językowe: dlaczego mniejsze może być lepsze w tłumaczeniu symultanicznym
Gdy mowa o sztucznej inteligencji, często pojawiają się superlatywy: coraz więcej parametrów, coraz więcej danych treningowych, coraz większa moc obliczeniowa. Ta droga umożliwiła imponujący postęp. W przypadku tłumaczenia symultanicznego podczas wydarzeń pojawia się jednak inne, bardzo praktyczne pytanie: ile mocy AI jest rzeczywiście potrzebne? Właśnie tu do gry wchodzą małe modele językowe. W tym artykule wyjaśniamy, dlaczego wyspecjalizowane i celowo optymalizowane modele są interesujące dla systemów tłumaczenia symultanicznego, jakie techniki za nimi stoją – i gdzie leżą ich ograniczenia.
Większy nie znaczy automatycznie lepszy
Rozwój sztucznej inteligencji przez długi czas kształtowało proste przekonanie: więcej parametrów, więcej danych treningowych i większa moc obliczeniowa prowadzą do wydajniejszych modeli. Ta zależność nie jest błędna – to dzięki niej powstało wiele możliwości, które dziś wydają się niemal oczywiste.
W wielu praktycznych zastosowaniach to jednak za mało. Kto korzysta z technologii na co dzień, pyta nie tylko o to, co model w ogóle potrafi. Decydujące jest, czy niezawodnie wykonuje określone zadanie – w warunkach, które faktycznie panują. Podczas wydarzenia oznacza to: z użyciem sprzętu dostępnego na miejscu i w trakcie trwającego programu.
Specjalizacja zamiast maksymalnego rozmiaru
Uniwersalny model językowy to generalista. Ma programować, pisać teksty, rozwiązywać problemy matematyczne i odpowiadać na pytania z dowolnych dziedzin. Ta wszechstronność ma swoją cenę: model, który ma umieć wszystko, musi łączyć w sobie bardzo wiele umiejętności.
Model do rozpoznawania mowy lub tłumaczenia ma natomiast jasno określone zadanie. Ma rozpoznawać mowę albo przenosić zdanie z jednego języka na inny. Kod programu czy zadania matematyczne do tego nie należą. Taki wyspecjalizowany model nie potrzebuje więc koniecznie tak szerokiego zakresu umiejętności jak model uniwersalny.
Dzięki celowej optymalizacji mniejsze modele mogą być bardzo wydajne w określonych zadaniach. Porównanie z warsztatu: do konkretnej śruby nie potrzeba całego zestawu narzędzi, lecz odpowiedniego klucza.
Jak małe modele językowe stają się wydajniejsze
Istnieją różne metody odchudzania modeli. Dwie z nich odgrywają w obecnym rozwoju szczególnie ważną rolę: kwantyzacja i Knowledge Distillation.
Kwantyzacja: mniejsza precyzja, mniej pamięci
Model językowy składa się w istocie z bardzo wielu wartości liczbowych, tzw. wag modelu. Przy kwantyzacji wagi te są zapisywane i przetwarzane z mniejszą precyzją numeryczną – w uproszczeniu: za pomocą liczb o grubszej gradacji zamiast bardzo dokładnych.
Może to znacznie zmniejszyć zapotrzebowanie modelu na pamięć, a tym samym obniżyć wymagania sprzętowe.
Metoda ma jednak swoją drugą stronę. W zależności od procedury i modelu może przy tym zostać utracona część dokładności. Jak duża będzie ta strata, nie da się powiedzieć ogólnie. Dlatego obowiązuje zasada: po każdej optymalizacji jakość trzeba sprawdzić ponownie. Model, który potrzebuje mniej pamięci, ale nie rozpoznaje już niezawodnie terminów fachowych, nie byłby dla konferencji branżowej żadnym usprawnieniem.
Knowledge Distillation: od dużego do małego modelu
Drugim podejściem jest tzw. Knowledge Distillation, czyli w wolnym tłumaczeniu destylacja wiedzy. Mniejszy model jest trenowany z pomocą większego. Duży model pełni niejako rolę nauczyciela, mniejszy – ucznia.
Celem jest wykorzystanie określonych umiejętności dużego modelu w wydajniejszej architekturze. Mały model nie musi więc opanować wszystkiego, co potrafi jego wzór – lecz przede wszystkim to, do czego będzie później używany.
Dlaczego ma to znaczenie dla tłumaczenia symultanicznego
Trzy zadania dzielące te same zasoby
W profesjonalnych systemach tłumaczenia symultanicznego nie pracuje jeden model – wiele zadań musi być wykonywanych jednocześnie. Jak te etapy klasycznie ze sobą współdziałają, opisaliśmy szerzej w artykule Czy AI potrafi tłumaczyć emocje?:
- Rozpoznawanie mowy: wypowiedź zostaje rozpoznana.
- Tłumaczenie: rozpoznana treść jest przenoszona na język docelowy.
- Synteza mowy: sztuczny głos odtwarza tłumaczenie.
Wszystkie trzy etapy konkurują o te same zasoby: moc obliczeniową i pamięć. I to nie jednorazowo, lecz nieprzerwanie – tak długo, jak na scenie ktoś mówi.
Co mogą umożliwić wydajniejsze modele
Wydajniejsze modele mogą więc dawać znaczącą przewagę praktyczną. Jeśli każde pojedyncze zadanie wymaga mniej zasobów, powstaje zapas. Ten zapas umożliwia potencjalnie:
- więcej równoległych kanałów językowych, np. gdy goście śledzą wydarzenie w kilku językach docelowych,
- niższe wymagania sprzętowe w miejscu wydarzenia,
- krótszy czas przetwarzania, czyli mniejsze opóźnienie między oryginalną wypowiedzią a tłumaczeniem.
Słowo „potencjalnie” zostało tu wybrane celowo. To, jaka korzyść faktycznie pojawi się w praktyce, zależy od danego modelu, metody optymalizacji i całego systemu – i, podobnie jak przy kwantyzacji, za każdym razem musi zostać sprawdzone.
Lokalna AI: dlaczego wydajność nie jest dla nas kwestią teoretyczną
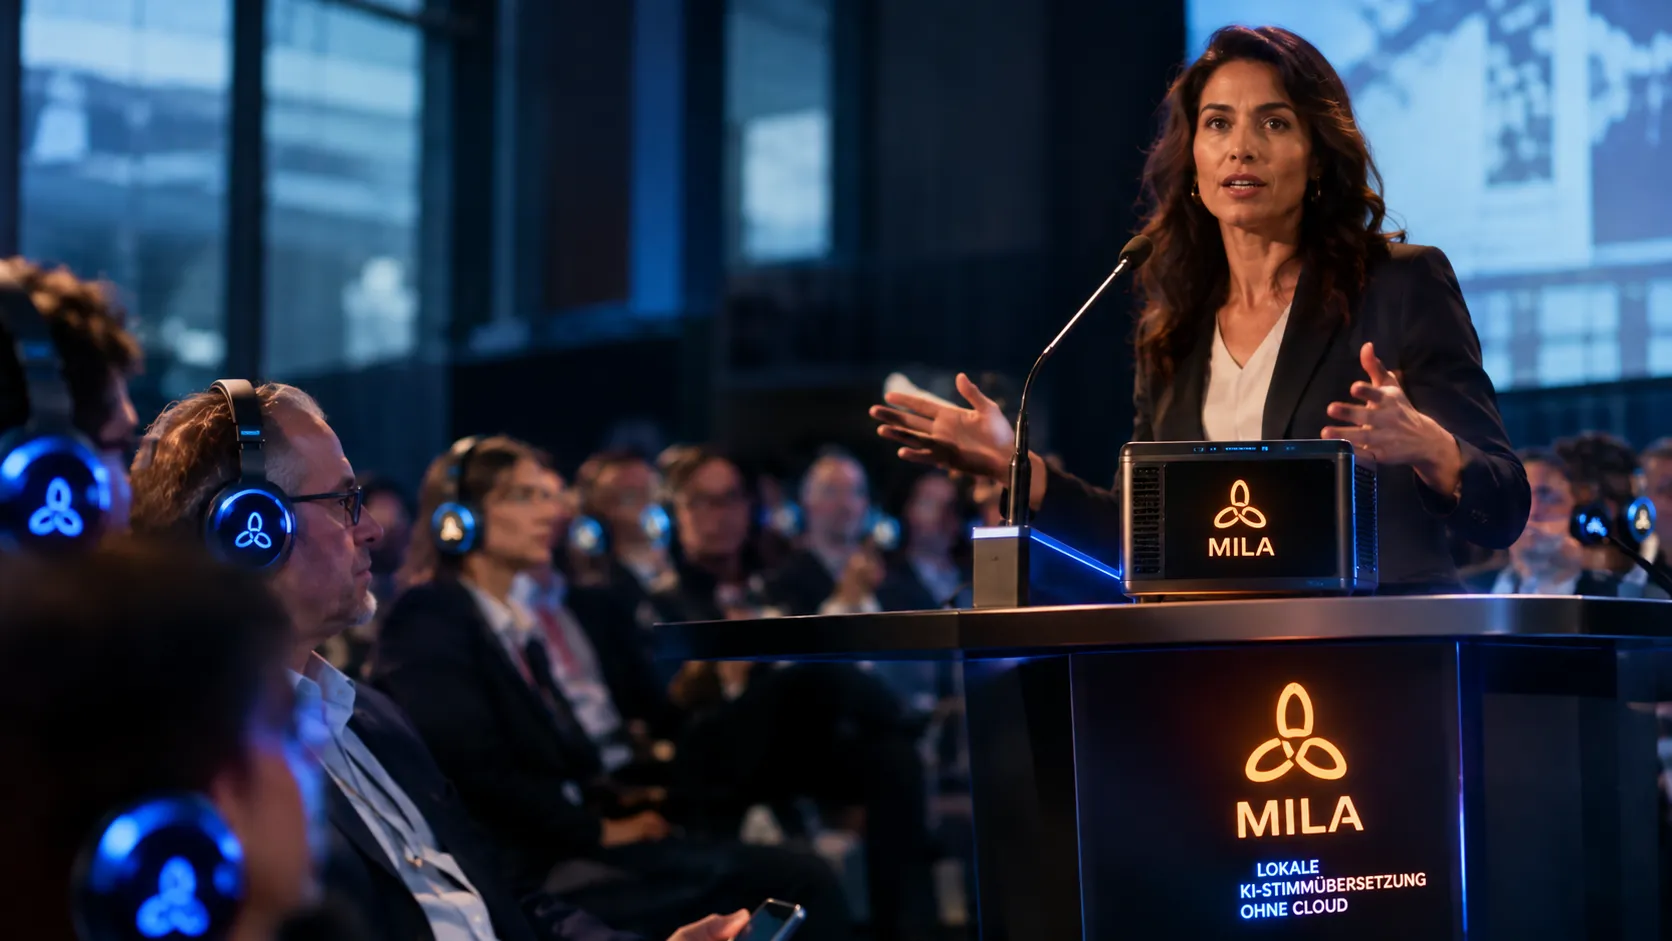
W MILA symultaniczne tłumaczenie AI działa lokalnie na naszym własnym sprzęcie w miejscu wydarzenia – bez chmury. Wypowiedzi nie opuszczają wydarzenia. Dla firm, stowarzyszeń i instytucji publicznych, na których wydarzeniach poruszane są także poufne tematy, może to być istotna kwestia.
Praca lokalna oznacza jednak również: obliczenia odbywają się na sprzęcie, który przywozimy. Dlatego pytanie, ile mocy potrzebuje model do swojego zadania, nie ma dla nas wyłącznie akademickiego znaczenia.
Dla Państwa jako organizatorów przebieg pozostaje przy tym prosty: każdy język trafia osobnym kanałem do istniejącego systemu do tłumaczeń symultanicznych lub techniki konferencyjnej, a na życzenie zapewniamy gościom odbiorniki i słuchawki. Kto szuka tłumacza na wydarzenie, nie musi więc zajmować się architekturą modeli – tym zajmujemy się my.
Perspektywa MILA: rozmiar nie jest kryterium jakości
Dla MILA decydujący nie jest rozmiar modelu językowego. Istotne są cztery kryteria:
- Jakość tłumaczenia: czy treść dociera w języku docelowym w sposób zrozumiały i poprawny?
- Opóźnienie: ile czasu mija między oryginałem a tłumaczeniem?
- Stabilność: czy system działa niezawodnie przez całe wydarzenie?
- Zużycie zasobów: ile mocy obliczeniowej i pamięci jest do tego potrzebne?
Dlatego szczególnie uważnie śledzimy rozwój wydajnych modeli i technologii lokalnej inferencji – czyli metod, dzięki którym modele są uruchamiane bezpośrednio na własnym sprzęcie.
Równie ważne jest to, co da się zaplanować niezależnie od modelu: terminy fachowe i nazwy własne z programu konfigurujemy z wyprzedzeniem, a technik systemowy jest zawsze na miejscu. Planuje wszystko razem z Państwem, montuje sprzęt, nadzoruje tłumaczenie w trakcie wydarzenia i go demontuje. A ponieważ nawet najlepszy model może przetłumaczyć tylko to, co usłyszy, równie dużą rolę odgrywa dźwięk – więcej na ten temat w naszym artykule Tłumaczenie AI a technika audio: dlaczego wszystko zaczyna się od mikrofonu.
Podsumowanie: odpowiednia AI zamiast największej
Małe modele językowe nie są celem samym w sobie. Kwantyzacja i Knowledge Distillation mogą odchudzić modele, ale każda optymalizacja musi być oceniana przez pryzmat jakości. W tłumaczeniu symultanicznym podczas kongresów, konferencji branżowych czy wydarzeń firmowych liczy się ostatecznie to, co dociera do sali.
Najciekawsza AI w profesjonalnych zastosowaniach to nie zawsze ta największa – lecz ta, która niezawodnie wykonuje swoje zadanie.
Jeśli planują Państwo tłumaczenie na kolejne wydarzenie, wszystkie szczegóły dotyczące techniki, języków i przebiegu znajdą Państwo na naszej stronie Usługi. Odpowiedzi na najczęstsze pytania zebraliśmy w FAQ.
