Blogg · 2026-08-10
Kan AI skilja mellan röster? Talarigenkänning och röstkloning förklarat
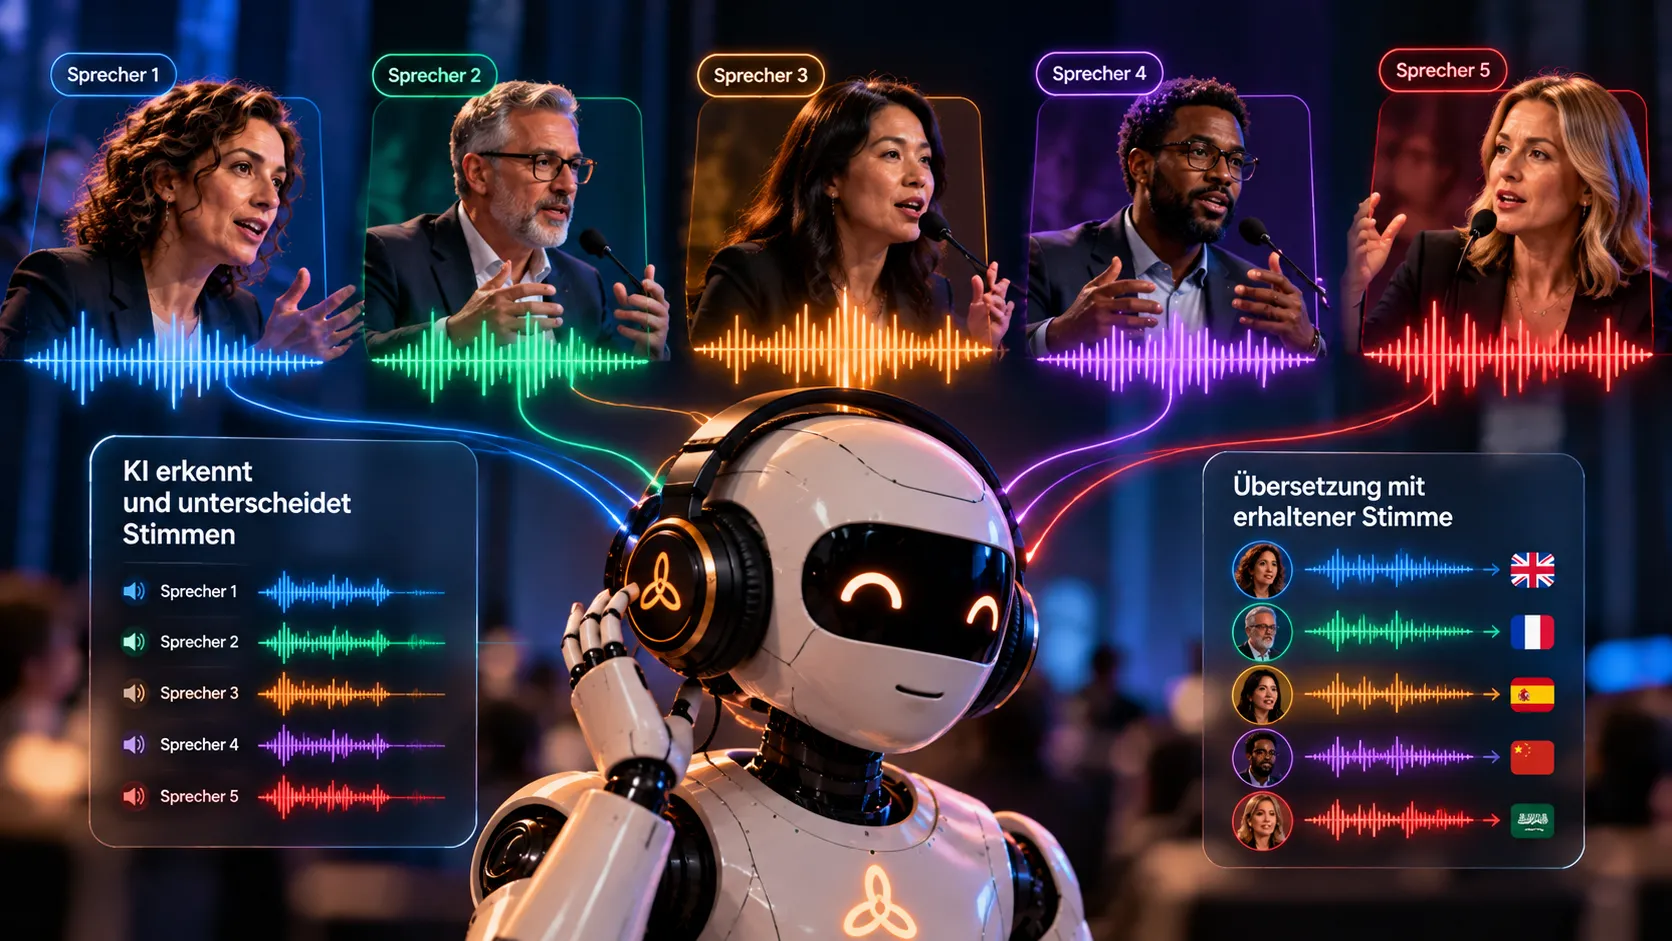
Vem talar just nu? Vid en klassisk föreläsning uppstår knappast den frågan: en person talar, publiken lyssnar. På podiet ser det annorlunda ut. Flera personer turas om, avbryter varandra eller talar samtidigt. För en AI-stödd simultantolkning innebär det en extra uppgift: systemet måste inte bara förstå vad som sägs, utan helst också känna igen vem som talar. Det är just det talaridentifiering handlar om. I det här inlägget förklarar vi hur Speaker Diarization fungerar, varför överlappande tal är så krävande, vad Voice Cloning skulle kunna innebära för tolkningen – och vilket ansvar som följer med att återskapa mänskliga röster.
Från föreläsning till podium: Varför frågan ”Vem talar?” blir viktig
Oavsett om det är en människa eller AI: för all tolkning gör formatet stor skillnad. Vid en keynote på en kongress eller en presentation på ett företagsevent finns en tydlig källa: mikrofonen vid talarstolen eller headsetet på personen på scenen. Vem som talar är entydigt.
Vid en paneldebatt förändras det. Moderatorn ställer en fråga, en gäst svarar, en andra invänder, en tredje fyller i mitt i meningen. Sådana växlingar är avsiktliga, de gör en diskussion levande. För ett AI-system innebär de dock att två uppgifter måste lösas samtidigt:
- Vad sägs? Det är grunden för all tolkning.
- Vem säger det? Den informationen hjälper till att hålla isär inläggen och göra sammanhangen begripliga.
Den som följer en diskussion via tolkning är beroende av att växlingarna mellan talarna förblir märkbara. Annars flyter tal och genmäle snabbt ihop till en enda ström.
Talaridentifiering med AI: Vad Speaker Diarization åstadkommer
Facktermen för att tidsmässigt koppla talavsnitt till olika talare är Speaker Diarization. Ett sådant system analyserar signalens akustiska egenskaper och försöker skilja olika röster från varandra.
Resultatet är en tidsmässig struktur. Förenklat kan den se ut så här:
- Talare A talar i det första avsnittet,
- Talare B tar över,
- Talare C begär ordet,
- därefter talar Talare A igen.
En sak som ofta förbises är viktig här: Speaker Diarization är inte detsamma som att identifiera personer. Systemet behöver inte nödvändigtvis veta vilka verkliga människor som står bakom rösterna. Det räcker att det känner igen röst A och röst B som olika röster. Om A är moderatorn och B styrelseledamoten förblir till att börja med öppet för den här uppgiften.
För en simultantolkning är det just denna förmåga som är relevant. Redan informationen att en annan person talar nu än tidigare kan hjälpa till att återge en diskussion mer begripligt.
När alla pratar samtidigt: Talarseparation vid överlappande tal
Särskilt svårt blir det när flera människor talar samtidigt. I en livlig paneldebatt händer det regelbundet – en kort inflikning, ett instämmande ord, två svar som överlappar varandra.
Här kommer metoder för Audio Source Separation in i bilden. De ska separera olika talsignaler som ligger ovanpå varandra. I bästa fall blir en blandning åter till enskilda, begripliga röster.
Kvaliteten på sådana metoder beror dock starkt på källmaterialet och de akustiska förhållandena. Ju tydligare de enskilda rösterna finns i signalen, desto bättre kan de hållas isär. Det som redan har gått förlorat i ljudet kan inte heller en sofistikerad separation på ett tillförlitligt sätt få tillbaka.
Vad det betyder för er planering
För arrangörer innebär det: frågan om hur väl en AI kan skilja talare åt är alltid också en fråga om ljudteknik. Hur mikrofoneringen vid paneler lägger grunden för all tolkning har vi beskrivit utförligt i inlägget AI-tolkning och ljudteknik: Varför allt börjar vid mikrofonen. Om ni planerar simultantolkning vid en paneldebatt lönar det sig att stämma av ljudet tillsammans i ett tidigt skede.
Voice Cloning: Kan en tolkning bevara rösten?
Ett andra forskningsområde går ytterligare ett steg. Det handlar om syntetisk återskapning av mänskliga röster, ofta kallat Voice Cloning.
Modern talsyntes kan överta vissa egenskaper hos en röst och använda dem för nytt språkligt innehåll. För tolkning öppnar det nya möjligheter: en talare skulle kunna återges på ett annat språk, medan karakteristiska drag i hans röst delvis bevaras.
Ordet ”delvis” är medvetet valt. Det handlar inte om att kopiera en person fullständigt, utan om att tolkningen inte längre ska låta som en främmande röst, utan bära med sig drag från originalet.
I kombination med talaridentifiering blir potentialen synlig: om ett system känner igen att Talare B talar just nu och bevarar dennes röstegenskaper på målspråket, skulle en tolkad paneldebatt kunna bli betydligt lättare att följa. Liknande frågor uppstår när det gäller att överföra betoning och uttryck – läs mer om det i vårt inlägg Kan AI tolka känslor?
Tekniska möjligheter och etiska frågor
Hur spännande tekniken än är: att återskapa mänskliga röster medför ett betydande ansvar. En röst är något mycket personligt. Den som skapar den syntetiskt rör sig på ett känsligt område.
Tre förutsättningar är enligt vår uppfattning centrala:
- Samtycke: Personen vars röst återskapas måste ge sitt medgivande.
- Transparens: Särskilt i professionella sammanhang måste det vara tydligt när en syntetisk röst används. Publiken bör veta att den hör en tolkning och inte personen själv.
- Skydd mot missbruk: Återskapade röster får inte användas utanför det överenskomna syftet.
För företag, organisationer och offentliga institutioner är dessa frågor inte abstrakta. Vid en bolagsstämma, en fackkonferens eller ett offentligt sammanträde måste det alltid gå att följa vem som sa vad – och i vilken form det återges.
MILA:s perspektiv på talaridentifiering och röstbevarande
För framtida system för AI-tolkning är talaridentifiering och röstbevarande viktiga utvecklingsområden. Särskilt vid paneldebatter skulle en tillförlitlig koppling av inläggen till de enskilda talarna kunna förbättra begripligheten. Därför följer vi dessa tekniker noga.
Vår måttstock förblir densamma: teknisk innovation måste skapa ett verkligt mervärde för kommunikationen. En ny funktion är meningsfull för oss först när den hjälper era gäster att följa ett evenemang bättre.
Vid ert evenemang satsar vi i dag på det som går att planera tillförlitligt. AI-simultantolkningen körs lokalt på vår egen teknik på plats, utan moln – det som sägs lämnar inte evenemanget. Facktermer och egennamn från programmet lägger vi in i förväg. Varje språk går på en egen kanal in i den befintliga tolkanläggningen eller konferenstekniken, vid önskemål med mottagare och hörlurar för gästerna. Och en systemtekniker finns alltid på plats: han planerar med er, riggar, övervakar tolkningen under evenemanget och riggar ner igen.
Planerar ni en kongress, en konferens eller ett företagsevent med paneldebatt och vill veta hur tolkningen kan genomföras? Alla detaljer om teknik och genomförande hittar ni på vår sida om tjänster. Vilka format vi stöttar visar våra användningsområden – kontakta oss gärna.
