Blogg · 2026-08-11
Simultantolkning med AI: När maskinen lyssnar, översätter och talar
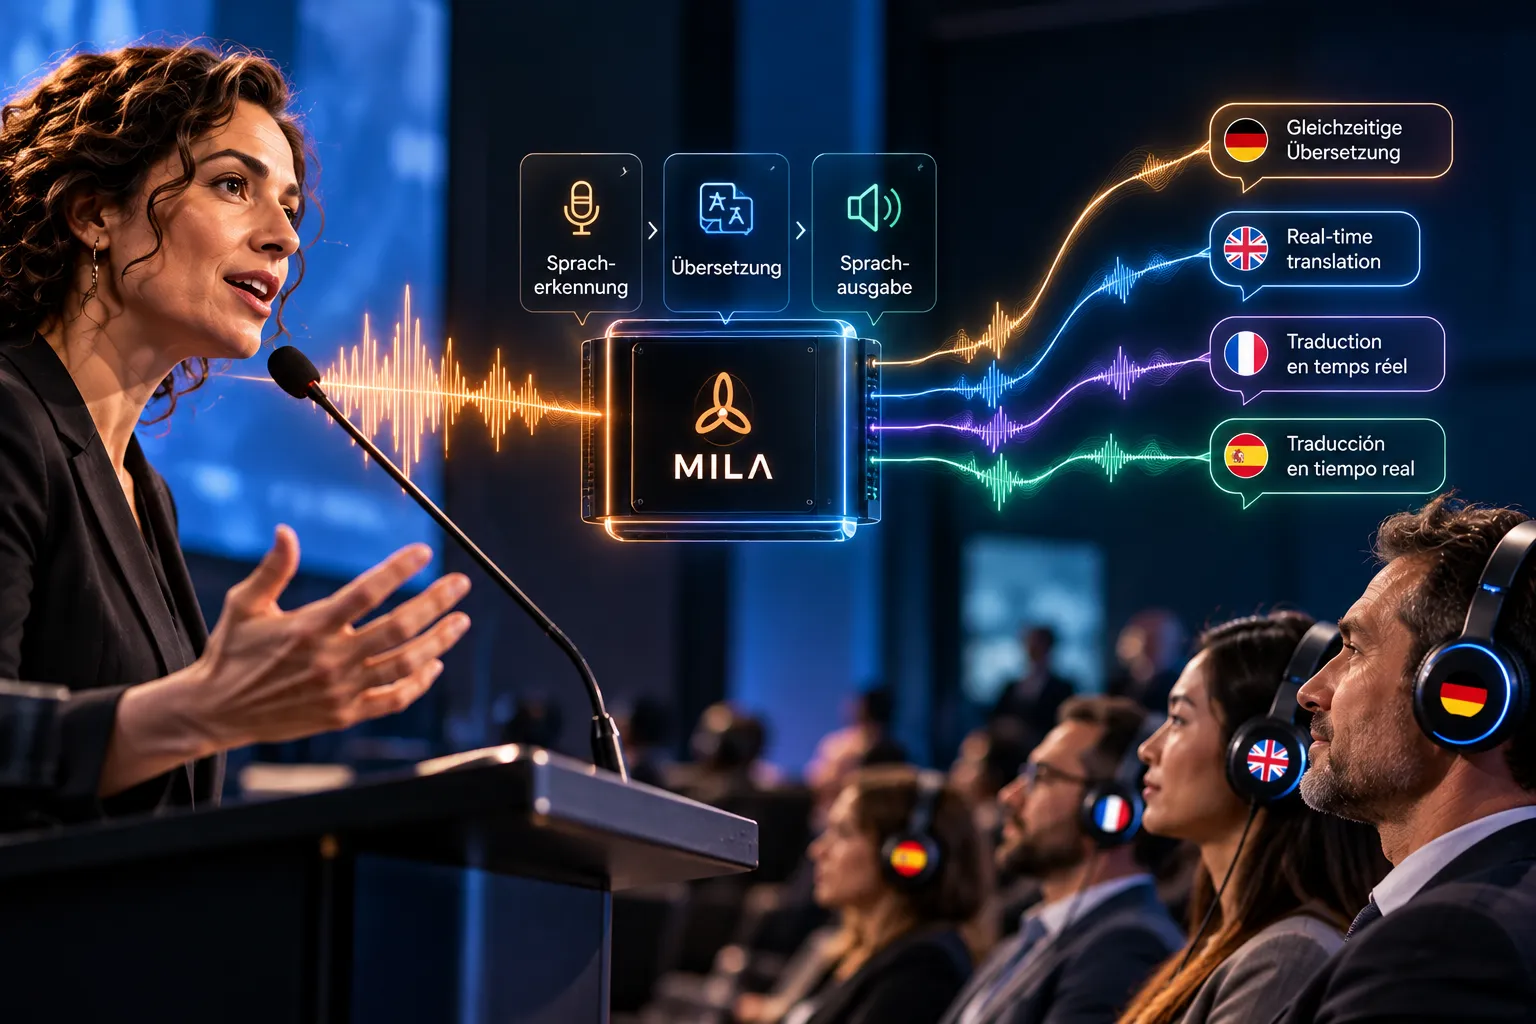
En talare på podiet inleder en lång tysk mening, och det avgörande verbet står allra sist. En mänsklig simultantolk lyssnar, sätter in det sagda i sitt sammanhang och börjar tala innan meningen är färdig. En AI-tolk står inför exakt samma uppgift: den måste samtidigt lyssna, översätta och tala. Hur den löser det beror i hög grad på dess arkitektur. Hittills arbetar många system för simultantolkning i flera på varandra följande steg. Nya forskningsansatser försöker koppla samman denna bearbetning tätare. I den här artikeln förklarar vi de viktigaste ansatserna, deras för- och nackdelar och varför frågan om arkitektur även är relevant för er som arrangör.
Den klassiska pipelinen: ASR, översättning, talsyntes
Den beprövade uppbyggnaden av ett system för AI-tolkning är en kedja av tre byggstenar:
- Taligenkänning (ASR, Automatic Speech Recognition): En modell omvandlar det talade ordet till text.
- Översättning (Translation): En andra modell överför texten till målspråket.
- Talsyntes (TTS, Text-to-Speech): En syntetisk röst läser upp översättningen.
Varje byggsten utför en tydligt avgränsad uppgift och lämnar sitt resultat vidare till nästa. Därför talar man om en modulär arkitektur eller en pipeline.
Vad som talar för den modulära uppbyggnaden
Den största fördelen ligger i transparensen. Mellan stegen uppstår resultat som går att granska och kontrollera, framför allt transkriptet efter taligenkänningen. Om ett ord översätts fel går det att spåra om det redan uppfattades fel eller om det ändrades först vid översättningen.
Dessutom kan byggstenarna optimeras eller bytas ut var för sig. Facktermer och egennamn kan läggas in just där de behövs, till exempel vid igenkänningen av ett produktnamn eller vid översättningen av en fackterm. Och när en bättre modell för ett delsteg blir tillgänglig behöver inte hela systemet byggas om.
Där pipelinen når sina gränser
Kedjan har också svagheter. Fel fortplantar sig: det som taligenkänningen missuppfattar översätter nästa steg så som det uppfattades, inte så som det var menat. Dessutom summeras bearbetningstiderna för de enskilda stegen.
En tredje punkt gäller sättet att tala. Vid omvandlingen till text går information som betoning, taltempo eller ironi lätt förlorad. Det som inte längre finns i texten kan talsyntesen i slutändan inte heller återge. Vi har ägnat en egen artikel åt detta ämne: Kan AI översätta känslor?
End-to-End Speech-to-Speech Translation
Här kommer ett forskningsfält in som har fått stor uppmärksamhet de senaste åren: end-to-end speech-to-speech translation. Idén: en enda modell tar emot talat språk och genererar direkt talat språk på målspråket, utan att nödvändigtvis gå omvägen via en utskriven text.
Detta ger möjliga fördelar. Färre överlämningar mellan enskilda modeller kan snabba upp bearbetningen. Och eftersom modellen arbetar med själva ljudet finns en chans att även föra över egenskaper hos det ursprungliga sättet att tala.
Det finns också utmaningar. En integrerad modell är svårare att genomskåda: när det inte finns något synligt mellansteg är det svårare att härleda ett fel till en orsak. Även riktad styrning, till exempel att ange vissa facktermer, är inte lika enkelt möjlig i en sluten modell som i en pipeline.
Audio-native AI-modeller: ljudet som egen informationskälla
Nära besläktade med denna ansats är så kallade audio-native AI-modeller. De bearbetar ljudsignaler direkt i stället för att enbart arbeta med text. Därmed kan de i princip utnyttja information som bara finns i ljudet, till exempel pauser eller betoningar.
Gränserna mellan ansatserna blir samtidigt alltmer flytande. Inom forskningen finns även blandformer som kombinerar delar av en modulär kedja med integrerade modeller. Frågan är därför allt mer sällan ”Pipeline eller end-to-end?”, utan snarare: vilka delar av bearbetningen bör vara tätt sammankopplade, och var är ett synligt, styrbart mellansteg meningsfullt? Ingen av ansatserna är generellt överlägsen. Vilken arkitektur som är lämplig beror på vad som väger tyngst i respektive tillämpning.
Oavsett arkitektur gäller: varje modell kan bara arbeta med den signal som når den. Varför ljudet står i början av varje översättning kan ni läsa i vår artikel AI-tolkning och ljudteknik: Varför allt börjar vid mikrofonen.
Streaming: simultantolkning innan meningen är slut
För simultantolkning på en konferens eller en kongress räcker det inte att översätta bra. Systemet måste också göra det löpande. Det kan inte vänta tills en talare har avslutat sitt föredrag, utan måste bearbeta talflödet i små avsnitt. Denna princip kallas streamingbearbetning.
Det leder till en grundläggande avvägning:
- Att översätta tidigt innebär kort fördröjning men mindre kontext. Systemet kan behöva översätta innan det står klart vart meningen är på väg.
- Att lyssna längre innebär mer kontext och därmed ett bättre underlag, men också större avstånd till originalet.
Exemplet från början visar varför detta är så krävande: på tyska står verbet ofta sist i meningen, i många målspråk kommer det tidigt. Ett streamingsystem måste alltså avgöra hur länge det ska vänta. Därtill kommer att text fortfarande kan korrigeras i bakgrunden, medan ett redan uttalat ord på målspråket inte längre kan det.
Vilka utvecklingar som är särskilt relevanta för realtidssystem
För liveanvändning vid evenemang är enligt vår bedömning framför allt fyra utvecklingar viktiga:
- Streamingkapabla modeller, som hanterar ofullständiga meningar och hittar en bra balans mellan fördröjning och kontext.
- Styrbarhet, så att facktermer, produktnamn och egennamn från programmet tillförlitligt kommer fram så som de är menade.
- Övervakningsbarhet, så att det under evenemanget hela tiden går att se vad systemet just känner igen och återger.
- Effektivitet, så att kraftfulla modeller kan köras även på teknik på plats i stället för att vara beroende av avlägsna datacenter.
Vad arkitekturen betyder för ert evenemang
Ni behöver ingen expertkunskap om språkmodeller. Men ett tolkningssystems arkitektur avgör hur flexibelt det kan optimeras, övervakas och vidareutvecklas. Och det är precis det ni märker i praktiken: när namnet på er huvudsponsor återges korrekt, när en fackterm från er bransch sitter eller när någon snabbt kan ingripa vid ett problem.
På MILA ser vi därför inte simultantolkning som ett gränssnitt man bara kopplar in, utan som hela bearbetningskedjan från mikrofon till hörlurar. Konkret innebär det:
- Facktermer och egennamn från ert program lägger vi in i förväg.
- AI-simultantolkningen körs lokalt på vår egen teknik på evenemangsplatsen, utan moln. Det som sägs lämnar inte ert evenemang.
- En systemtekniker finns alltid på plats. Teknikern planerar tillsammans med er, bygger upp, övervakar tolkningen under evenemanget och monterar ned igen.
- Varje språk går ut på en egen kanal i er befintliga tolkanläggning eller konferensteknik; på begäran tillhandahåller vi mottagare och hörlurar till gästerna.
Forskningen kring speech-to-speech-system utvecklas snabbt, och vi följer den noga. Om ni vill veta hur simultantolkning kan se ut för er kongress, er konferens eller ert företagsevenemang hittar ni detaljer om teknik och genomförande på vår sida om våra tjänster. Svar på vanliga frågor har vi samlat i vår FAQ.
