Blogg · 2026-08-19
Speech-to-Speech Translation: Så fungerar modern AI-baserad talöversättning
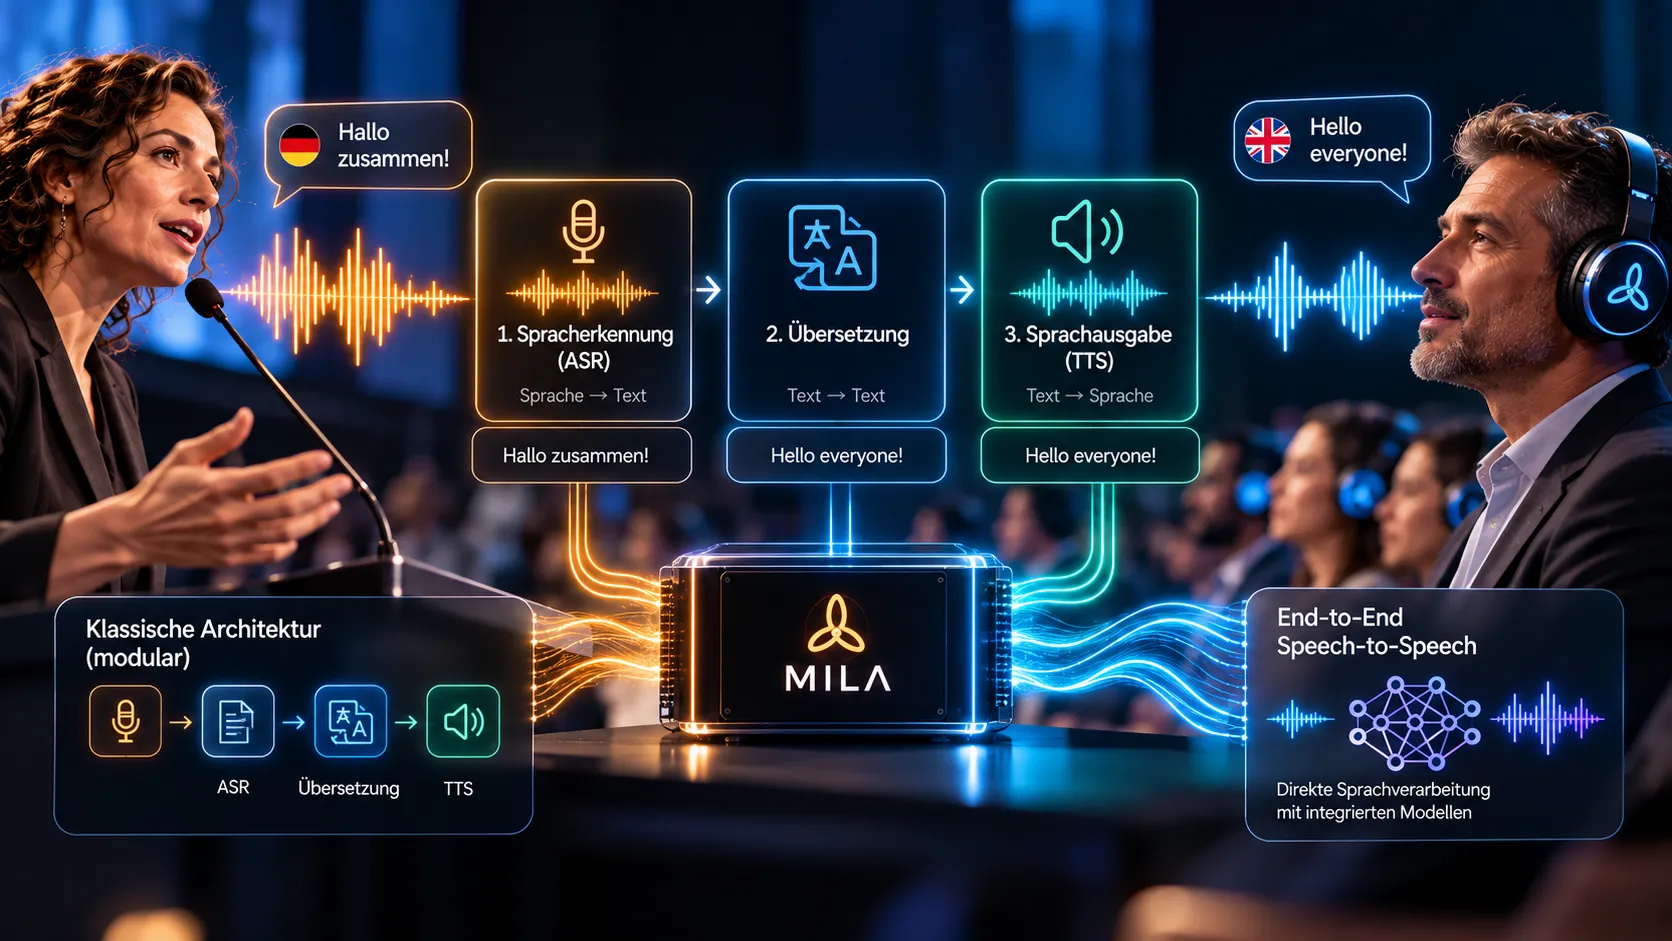
En talare håller sitt anförande på tyska, och i salen följer gästerna föredraget i hörlurar – på engelska, franska eller polska. Det som för publiken ser ut som en enda process består tekniskt sett av flera uppgifter som måste samverka nära. Det är just detta som Speech-to-Speech Translation handlar om: översättning av talat språk till talat språk. I det här inlägget förklarar vi hur den klassiska bearbetningskedjan är uppbyggd, var dess begränsningar ligger, vilka nya AI-arkitekturer forskningen prövar – och varför dessa frågor också är relevanta för er som arrangör.
Tre uppgifter, ett mål
Ett professionellt system för AI-tolkning måste kombinera flera komplexa uppgifter. Det måste:
- känna igen talat språk,
- översätta innehållet till målspråket,
- och utifrån det skapa ett begripligt talat resultat.
En mänsklig simultantolk gör allt detta i ett och samma huvud: lyssnar, förstår, överför och talar. Vid maskinell simultantolkning fördelas dessa uppgifter traditionellt på olika modeller, som var och en är specialiserad på sin del. Hur AI-tolkning och mänskliga konferenstolkar skiljer sig i grunden belyser vi i inlägget AI-tolk eller människa: Blir simultantolken överflödig?
Att fördela uppgifterna på flera modeller har fördelar, men också tekniska begränsningar – båda delarna är värda en närmare titt.
Den klassiska bearbetningskedjan för Speech-to-Speech Translation
I sin klassiska form sker Speech-to-Speech Translation i tre steg efter varandra. Resultatet av varje steg utgör indata för nästa.
Steg 1: Automatisk taligenkänning (ASR)
Först kommer den automatiska taligenkänningen, förkortat ASR (Automatic Speech Recognition). Den omvandlar ljudsignalen – till exempel från mikrofonen i talarstolen – till text. Det talade blir till ord och meningar.
Steg 2: Maskinöversättning
Därefter översätter en modell för maskinöversättning det igenkända innehållet till målspråket. Den arbetar med texten som taligenkänningen har levererat – inte med det ursprungliga ljudet.
Steg 3: Talsyntes (Text-to-Speech)
I det tredje steget skapar ett Text-to-Speech-system, förkortat TTS, det talade resultatet utifrån den översatta texten. Det är den rösten som gästerna till slut hör i hörlurarna eller via konferenstekniken.
Fördelen: Varje komponent kan förbättras separat
Den här modulära arkitekturen har en tydlig fördel: De enskilda komponenterna kan optimeras oberoende av varandra. Om en bättre modell blir tillgänglig för något av stegen kan den användas utan att de övriga byggstenarna behöver utvecklas på nytt. Varje del av kedjan kan testas, anpassas och bytas ut på ett målinriktat sätt.
Var utmaningarna ligger
Hur överskådlig kedjan än är – den medför grundläggande utmaningar.
Varje bearbetningssteg tar tid
Taligenkänning, översättning och talsyntes sker efter varandra, och vart och ett av dessa steg tar tid. Vid simultantolkning, där gästerna ska kunna följa programmet med så liten fördröjning som möjligt, är detta en central faktor.
Fel vandrar genom kedjan
En annan utmaning är mindre uppenbar: Fel kan föras vidare från en komponent till nästa. Om taligenkänningen tolkar ett begrepp felaktigt får översättningsmodellen redan felaktig information. Den översätter då kanske korrekt – men just det som är fel. Talsyntesen återger till slut felet hörbart.
Det är särskilt känsligt när det gäller facktermer och egennamn, som ständigt förekommer på kongresser och fackkonferenser. Ett enda felaktigt igenkänt begrepp kan ge en mening en annan betydelse. Därför är det första steget så viktigt – och med det kvaliteten på ingångssignalen. Varför ljudet avgör så mycket beskriver vi i inlägget AI-tolkning och ljudteknik: Varför allt börjar vid mikrofonen.
End-to-End Speech-to-Speech Translation: den mer direkta vägen
Ett alternativt forskningsfält handlar om modeller som bearbetar språkinformation mer direkt. Man talar om End-to-End Speech-to-Speech Translation. Sådana system kan minska vissa mellansteg eller koppla ihop dem närmare internt – i stället för strikt åtskilda stationer uppstår en mer integrerad bearbetningsväg.
Vad integrerade modeller kan bevara
Det lockande med detta tillvägagångssätt ligger i det som kan gå förlorat i den klassiska kedjan. Så snart talat språk omvandlas till text återstår framför allt orden. Röstegenskaper, prosodi – alltså betoning, rytm och satsmelodi – samt delar av det språkliga sammanhanget finns inte i texten.
Integrerade metoder öppnar nya möjligheter att överföra även sådan information. Hur långt forskningen har kommit när det till exempel gäller att överföra känslor, och var gränserna går, har vi sammanfattat i inlägget Kan AI översätta känslor?
Ingen automatisk genväg
Integrerade system är dock inte automatiskt snabbare eller mer tillförlitliga bara för att de har färre åtskilda mellansteg. Även deras kontrollerbarhet och anpassningsbarhet måste beaktas.
För användning vid evenemang är detta ingen bisak: Den som vill lägga in facktermer och egennamn i förväg och övervaka översättningen under evenemanget behöver ett system där man kan göra riktade insatser.
Modulär eller integrerad arkitektur?
Båda metoderna har fördelar: Modulära system kan bytas ut och optimeras byggsten för byggsten. Integrerade modeller kan bevara information som prosodi och röstegenskaper, som går förlorad vid en textbaserad mellanbearbetning. Vilken arkitektur som passar bäst beror på kraven – det finns inget generellt svar.
Vad det betyder för ert evenemang
Som arrangör, byrå, företag eller förbund behöver ni inte utvärdera modellarkitekturer. För er är det viktiga att era gäster kan följa programmet på sitt språk – oavsett om det är på en kongress, vid en bolagsstämma eller vid ett offentligt sammanträde. Ändå är det till hjälp att känna till bearbetningskedjan när ni planerar simultantolkning för ert evenemang. Vissa faktorer går nämligen att påverka i förväg:
- Ljudet: Eftersom allt börjar med taligenkänningen är en ren mikrofonsignal med och avgör vad som når fram i de följande stegen.
- Programmet: Facktermer och egennamn som är kända i förväg kan förberedas. Hos MILA lägger vi in dem före evenemanget.
- Övervakningen: AI-baserad simultantolkning bör inte köras utan uppsikt. Hos oss övervakar en systemtekniker tolkningen på plats under evenemanget.
MILA:s perspektiv
För MILA är arkitekturen i ett språksystem ett centralt tekniskt beslut. Vi arbetar med frågan om hur översättningskvalitet, realtidsförmåga och lokal bearbetning kan kombineras.
Den lokala bearbetningen är en fast del av vårt erbjudande: Vår AI-simultantolkning körs lokalt på vår egen teknik på evenemangsplatsen, utan moln. Det som sägs lämnar inte evenemanget.
Vi tittar både på specialiserade enskilda modeller och på nya integrerade metoder. Kvaliteten i ett system för AI-tolkning uppstår nämligen inte genom en enskild modell. Den uppstår genom samspelet i hela bearbetningskedjan – från ingångssignalen via förberedelsen av språken till övervakningen på plats.
I slutet av kedjan leds varje språk på en egen kanal in i den befintliga tolkanläggningen eller konferenstekniken; på begäran tillhandahåller vi mottagare och hörlurar för gästerna. Hur teknik, genomförande och tilläggstjänster ser ut i detalj hittar ni på vår sida om tjänster. Om ni planerar ett flerspråkigt evenemang pratar vi gärna med er om vad ert program behöver.
