Blog · 14.8.2026
Kleine Sprachmodelle: Warum kleiner beim Dolmetschen besser sein kann
Wenn über künstliche Intelligenz berichtet wird, geht es oft um Superlative: immer mehr Parameter, immer mehr Trainingsdaten, immer mehr Rechenleistung. Dieser Weg hat beeindruckende Fortschritte ermöglicht. Für die Simultanübersetzung bei Veranstaltungen stellt sich jedoch eine andere, sehr praktische Frage: Wie viel KI-Leistung wird tatsächlich gebraucht? Genau hier kommen kleine Sprachmodelle ins Spiel. In diesem Beitrag erklären wir, warum spezialisierte und gezielt optimierte Modelle für Dolmetschsysteme interessant sind, welche Techniken dahinterstehen – und wo die Grenzen liegen.
Größer ist nicht automatisch besser
Die Entwicklung künstlicher Intelligenz wurde lange von einer einfachen Vorstellung geprägt: Mehr Parameter, mehr Trainingsdaten und mehr Rechenleistung führen zu leistungsfähigeren Modellen. Dieser Zusammenhang ist nicht falsch – er hat viele der Fähigkeiten hervorgebracht, die heute fast selbstverständlich wirken.
Für viele praktische Anwendungen greift er aber zu kurz. Wer eine Technologie im Alltag einsetzt, fragt nicht nur, was ein Modell grundsätzlich kann. Entscheidend ist, ob es eine bestimmte Aufgabe zuverlässig erledigt – unter den Bedingungen, die tatsächlich herrschen. Bei einer Veranstaltung heißt das: mit der Technik, die vor Ort zur Verfügung steht, und während das Programm läuft.
Spezialisierung statt maximaler Größe
Ein universelles Sprachmodell ist ein Generalist. Es soll programmieren, Texte schreiben, mathematische Probleme lösen und Fragen zu beliebigen Themen beantworten. Diese Bandbreite hat ihren Preis: Ein Modell, das alles können soll, muss sehr viele Fähigkeiten in sich vereinen.
Ein Modell für Spracherkennung oder Übersetzung hat dagegen einen klar umrissenen Auftrag. Es soll gesprochene Sprache erkennen oder einen Satz von einer Sprache in eine andere übertragen. Programmcode oder mathematische Aufgaben gehören nicht dazu. Ein solches spezialisiertes Modell benötigt deshalb nicht zwangsläufig dieselbe Bandbreite an Fähigkeiten wie ein Allrounder.
Durch gezielte Optimierung können kleinere Modelle für bestimmte Aufgaben sehr leistungsfähig sein. Ein Vergleich aus der Werkstatt: Für eine bestimmte Schraube braucht es nicht das ganze Sortiment, sondern den passenden Schlüssel.
Wie kleine Sprachmodelle effizienter werden
Um Modelle schlanker zu machen, gibt es verschiedene Verfahren. Zwei davon spielen in der aktuellen Entwicklung eine besonders wichtige Rolle: Quantisierung und Knowledge Distillation.
Quantisierung: weniger Präzision, weniger Speicher
Ein Sprachmodell besteht im Kern aus sehr vielen Zahlenwerten, den sogenannten Modellgewichten. Bei der Quantisierung werden diese Gewichte mit geringerer numerischer Präzision gespeichert und verarbeitet – vereinfacht gesagt: mit gröber abgestuften Zahlen statt mit sehr fein aufgelösten.
Das kann den Speicherbedarf eines Modells deutlich reduzieren und damit die Anforderungen an die Hardware senken.
Die Methode hat allerdings eine Kehrseite. Je nach Verfahren und Modell kann dabei ein Teil der Genauigkeit verloren gehen. Wie groß dieser Verlust ausfällt, lässt sich nicht pauschal sagen. Deshalb gilt: Nach jeder Optimierung muss die Qualität erneut überprüft werden. Ein Modell, das weniger Speicher braucht, dafür aber Fachbegriffe nicht mehr zuverlässig erkennt, wäre für eine Fachkonferenz keine Verbesserung.
Knowledge Distillation: vom großen zum kleinen Modell
Ein zweiter Ansatz ist die sogenannte Knowledge Distillation, sinngemäß eine Wissensdestillation. Dabei wird ein kleineres Modell mithilfe eines größeren Modells trainiert. Das große Modell übernimmt gewissermaßen die Rolle des Lehrers, das kleinere die des Schülers.
Ziel ist es, bestimmte Fähigkeiten des großen Modells in einer effizienteren Architektur nutzbar zu machen. Das kleine Modell muss also nicht alles beherrschen, was sein Vorbild kann – sondern vor allem das, wofür es später eingesetzt wird.
Warum das für die Simultanübersetzung relevant ist
Drei Aufgaben, die sich die Ressourcen teilen
Bei professionellen Dolmetschsystemen arbeitet nicht ein einzelnes Modell, sondern es müssen mehrere Aufgaben gleichzeitig ausgeführt werden. Wie diese Schritte klassisch zusammenspielen, haben wir im Beitrag Kann KI Emotionen übersetzen? ausführlicher beschrieben:
- Spracherkennung: Das Gesprochene wird erkannt.
- Übersetzung: Der erkannte Inhalt wird in die Zielsprache übertragen.
- Sprachsynthese: Eine künstliche Stimme gibt die Übersetzung wieder.
Alle drei Schritte konkurrieren um dieselben Ressourcen: Rechenleistung und Speicher. Und das nicht einmalig, sondern fortlaufend – so lange, wie auf der Bühne gesprochen wird.
Was effizientere Modelle ermöglichen können
Effizientere Modelle können deshalb einen erheblichen praktischen Vorteil bieten. Wenn jede einzelne Aufgabe weniger Ressourcen beansprucht, entsteht Spielraum. Dieser Spielraum ermöglicht möglicherweise:
- mehr parallele Sprachkanäle, etwa wenn Gäste eine Veranstaltung in mehreren Zielsprachen verfolgen,
- geringere Hardwareanforderungen am Veranstaltungsort,
- kürzere Verarbeitungszeiten, also weniger Abstand zwischen dem gesprochenen Original und der Übersetzung.
Das Wort „möglicherweise“ ist dabei bewusst gewählt. Welcher Vorteil sich in der Praxis tatsächlich einstellt, hängt vom jeweiligen Modell, vom Optimierungsverfahren und vom Gesamtsystem ab – und muss, wie bei der Quantisierung, jedes Mal geprüft werden.
Lokale KI: Warum Effizienz für uns keine Theoriefrage ist
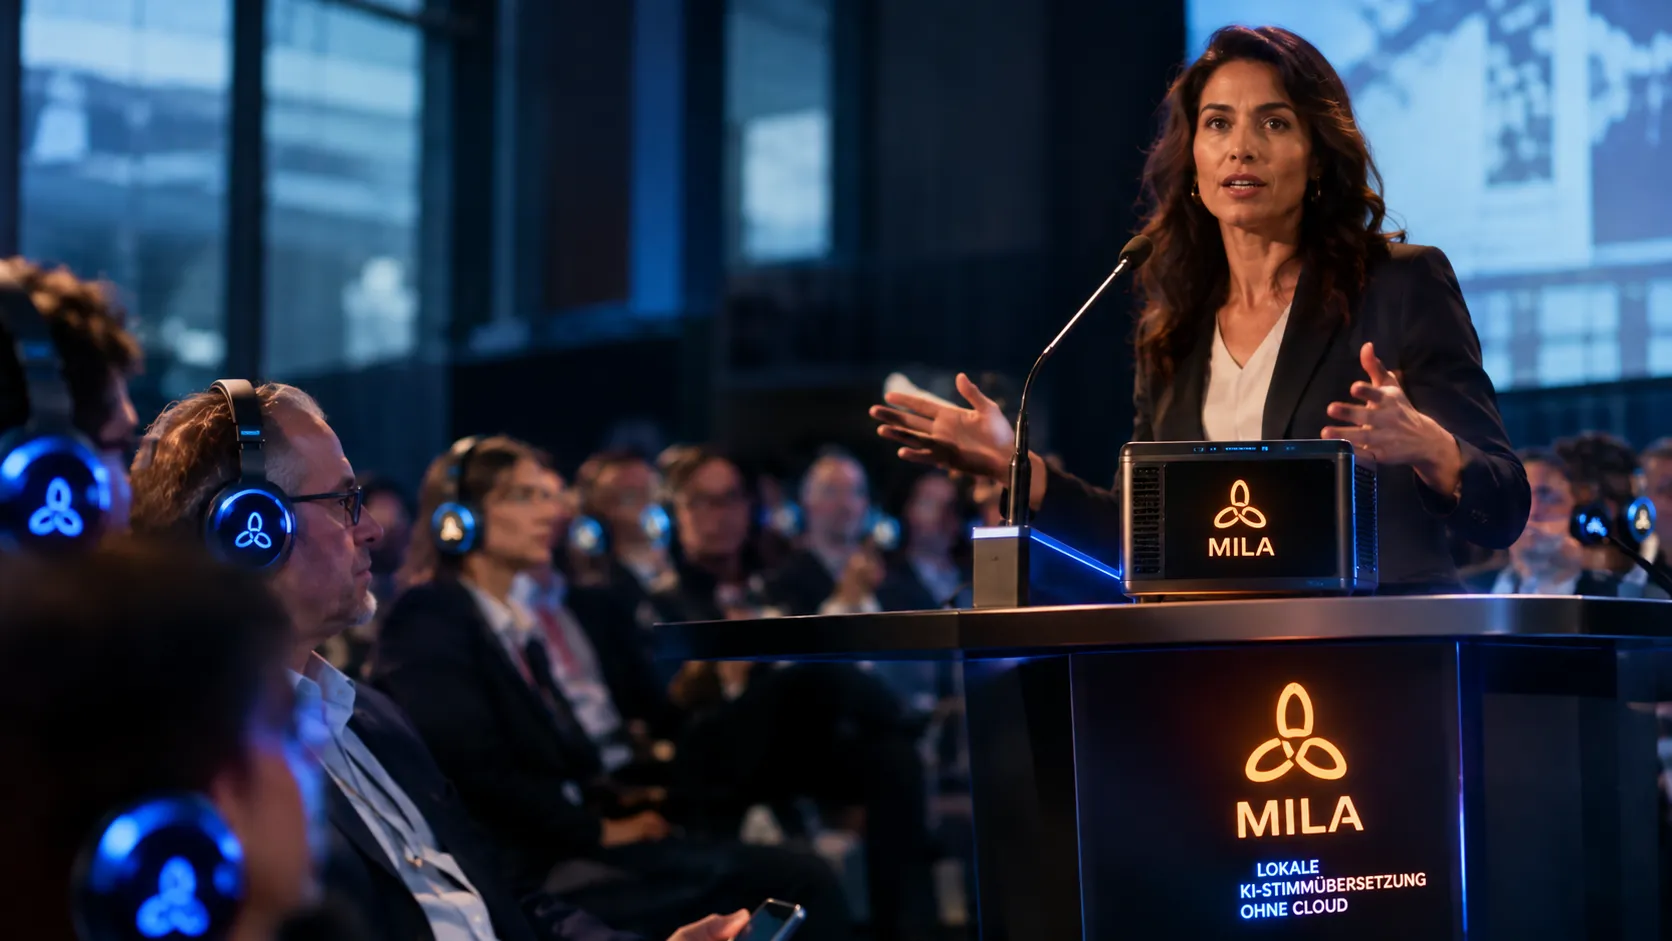
Bei MILA läuft die KI-Simultanübersetzung lokal auf unserer eigenen Technik am Veranstaltungsort – ohne Cloud. Gesprochenes verlässt die Veranstaltung nicht. Für Unternehmen, Verbände und öffentliche Einrichtungen, auf deren Veranstaltungen auch vertrauliche Themen zur Sprache kommen, kann das ein wichtiger Punkt sein.
Lokaler Betrieb bedeutet aber auch: Gerechnet wird auf der Technik, die wir mitbringen. Deshalb ist die Frage, wie viel Leistung ein Modell für seine Aufgabe braucht, für uns nicht nur von akademischem Interesse.
Für Sie als Veranstalter bleibt der Ablauf dabei überschaubar: Jede Sprache kommt auf einem eigenen Kanal in die vorhandene Dolmetscheranlage oder Konferenztechnik, auf Wunsch stellen wir Empfänger und Kopfhörer für die Gäste. Wer einen Dolmetscher für Veranstaltungen sucht, muss sich mit Modellarchitekturen also nicht beschäftigen – das übernehmen wir.
Die MILA-Perspektive: Größe ist kein Qualitätskriterium
Für MILA ist nicht die Größe eines Sprachmodells entscheidend. Relevant sind vier Kriterien:
- Übersetzungsqualität: Kommt der Inhalt verständlich und korrekt in der Zielsprache an?
- Latenz: Wie viel Zeit vergeht zwischen Original und Übersetzung?
- Stabilität: Läuft das System über die gesamte Veranstaltung zuverlässig?
- Ressourcenverbrauch: Wie viel Rechenleistung und Speicher werden dafür benötigt?
Wir beobachten deshalb besonders die Entwicklung effizienter Modelle und lokaler Inferenztechnologien – also der Verfahren, mit denen Modelle direkt auf eigener Hardware ausgeführt werden.
Genauso wichtig ist, was sich unabhängig vom Modell planen lässt: Fachbegriffe und Eigennamen aus dem Programm richten wir vorab ein, und ein Systemtechniker ist immer vor Ort. Er plant mit Ihnen, baut auf, betreut die Übersetzung während der Veranstaltung und baut wieder ab. Und weil auch das beste Modell nur übersetzen kann, was es hört, spielt der Ton eine ebenso große Rolle – mehr dazu in unserem Beitrag KI-Dolmetschen und Audiotechnik: Warum alles am Mikrofon beginnt.
Fazit: Die passende KI statt der größten
Kleine Sprachmodelle sind kein Selbstzweck. Quantisierung und Knowledge Distillation können Modelle schlanker machen, doch jede Optimierung muss sich an der Qualität messen lassen. Für die Simultanübersetzung bei Kongressen, Fachkonferenzen oder Firmenveranstaltungen zählt am Ende, was im Saal ankommt.
Die spannendste KI ist für professionelle Anwendungen nicht immer die größte – sondern diejenige, die ihre Aufgabe zuverlässig erfüllt.
Wenn Sie eine Übersetzung für Ihre nächste Veranstaltung planen, finden Sie alle Details zu Technik, Sprachen und Ablauf auf unserer Seite zu den Leistungen. Antworten auf häufige Fragen haben wir in den FAQ zusammengestellt.
