Blog · 11/8/2026
Interpretación simultánea con IA: cuando la máquina escucha, traduce y habla
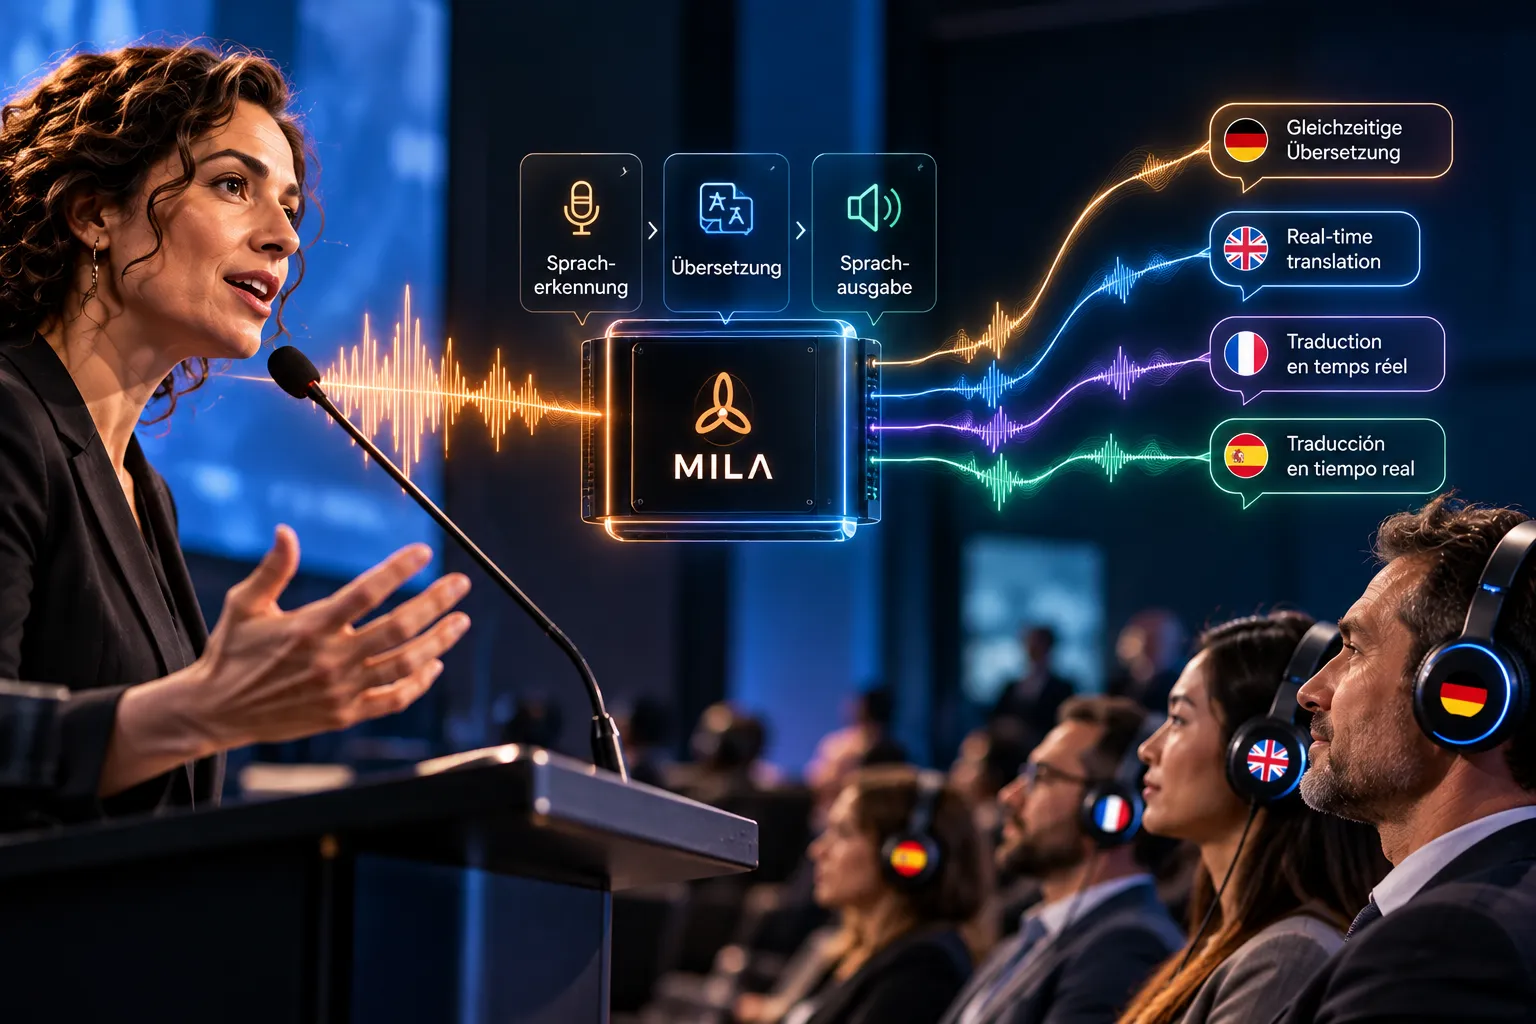
Una ponente comienza en el estrado una larga frase en alemán, y el verbo decisivo aparece justo al final. Un intérprete simultáneo humano escucha, sitúa el contenido y empieza a hablar antes de que la frase esté completa. Un intérprete de IA se enfrenta exactamente a la misma tarea: debe escuchar, traducir y hablar al mismo tiempo. Cómo lo resuelva depende en gran medida de su arquitectura. Hasta ahora, muchos sistemas de interpretación simultánea trabajan en varios pasos sucesivos. Nuevos enfoques de investigación intentan integrar este procesamiento de forma más estrecha. En este artículo le explicamos los enfoques más importantes, sus ventajas e inconvenientes y por qué la cuestión de la arquitectura también es relevante para usted como organizador.
El pipeline clásico: ASR, traducción y salida de voz
La estructura consolidada de un sistema de interpretación con IA es una cadena de tres componentes:
- Reconocimiento de voz (ASR, Automatic Speech Recognition): Un modelo convierte la palabra hablada en texto.
- Traducción (Translation): Un segundo modelo traslada ese texto a la lengua de destino.
- Salida de voz (TTS, Text-to-Speech): Una voz artificial pronuncia la traducción.
Cada componente realiza una tarea claramente delimitada y entrega su resultado al siguiente. Por eso se habla de una arquitectura modular o de un pipeline.
Lo que habla a favor de la estructura modular
La mayor ventaja reside en la transparencia. Entre los pasos se generan resultados que pueden consultarse y revisarse, sobre todo la transcripción tras el reconocimiento de voz. Si una palabra se traduce mal, es posible comprobar si ya se reconoció de forma incorrecta o si se alteró en la traducción.
Además, los componentes pueden optimizarse o sustituirse por separado. Los términos técnicos y los nombres propios pueden incorporarse de forma específica allí donde se necesitan, por ejemplo, en el reconocimiento de un nombre de producto o en la traducción de un término técnico. Y cuando se dispone de un modelo mejor para un paso concreto, no es necesario reconstruir todo el sistema.
Dónde encuentra límites el pipeline
La cadena también tiene puntos débiles. Los errores se propagan: lo que el reconocimiento de voz entiende mal, la siguiente fase lo traduce tal como se reconoció, no como se quiso decir. Además, los tiempos de procesamiento de cada paso se suman.
Un tercer aspecto afecta a la forma de hablar. Al convertir el habla en texto, se pierde fácilmente información como la entonación, el ritmo del discurso o la ironía. Lo que ya no figura en el texto tampoco puede reproducirlo la salida de voz al final. A este tema le hemos dedicado un artículo propio: ¿Puede la IA traducir emociones?
End-to-End Speech-to-Speech Translation
Aquí entra en juego un campo de investigación que ha ganado mucha atención en los últimos años: la End-to-End Speech-to-Speech Translation. La idea: un único modelo recibe lenguaje hablado y genera directamente lenguaje hablado en la lengua de destino, sin pasar necesariamente por un texto escrito.
De ello se derivan posibles ventajas. Menos traspasos entre modelos individuales pueden acelerar el procesamiento. Y como el modelo trabaja con el propio sonido, existe la posibilidad de trasladar también características de la forma de hablar original.
Frente a ello hay retos. Un modelo integrado es más difícil de comprender: si no existe un paso intermedio visible, resulta más complicado atribuir un error a una causa. Tampoco el control específico, como la definición de determinados términos técnicos, es tan sencillo en un modelo cerrado como en un pipeline.
Modelos de IA nativos de audio: el sonido como fuente de información propia
Estrechamente relacionados con este enfoque están los llamados modelos de IA nativos de audio. Procesan directamente señales de audio en lugar de trabajar exclusivamente con texto. Por ello pueden, en principio, aprovechar información que solo está contenida en el sonido, como las pausas o la entonación.
Los límites entre los enfoques se difuminan cada vez más. En la investigación también existen formas mixtas que combinan elementos de una cadena modular con modelos integrados. Por eso, la pregunta es cada vez menos «¿pipeline o end-to-end?» y más bien: ¿qué partes del procesamiento deberían estar estrechamente unidas y dónde tiene sentido un paso intermedio visible y controlable? Ninguno de los enfoques es superior de forma general. Qué arquitectura es adecuada depende de lo que más importe en cada uso.
Independientemente de la arquitectura, se aplica lo siguiente: cada modelo solo puede trabajar con la señal que le llega. Por qué el sonido está al principio de toda traducción se lo contamos en nuestro artículo Interpretación con IA y técnica de audio: por qué todo empieza en el micrófono.
Streaming: interpretación simultánea antes de que termine la frase
Para una interpretación simultánea en una conferencia o un congreso no basta con traducir bien. El sistema también debe hacerlo de forma continua. No puede esperar a que una ponente termine su intervención, sino que debe procesar el discurso en fragmentos pequeños. Este principio se denomina procesamiento en streaming.
De ello se deriva un equilibrio fundamental:
- Traducir pronto significa poco retardo, pero menos contexto. Puede que el sistema tenga que traducir antes de que esté claro hacia dónde va la frase.
- Escuchar más tiempo significa más contexto y, por tanto, una base mejor, pero también más distancia respecto al original.
El ejemplo del principio muestra por qué esto es tan exigente: en alemán, el verbo suele ir al final de la frase; en muchas lenguas de destino aparece pronto. Un sistema de streaming debe decidir, por tanto, cuánto tiempo espera. A esto se suma que un texto todavía puede corregirse en segundo plano, pero una palabra ya pronunciada en la lengua de destino, no.
Qué desarrollos son especialmente relevantes para los sistemas en tiempo real
Para el uso en directo en eventos, en nuestra opinión son importantes sobre todo cuatro desarrollos:
- Modelos aptos para streaming, que gestionen frases incompletas y encuentren un buen equilibrio entre retardo y contexto.
- Controlabilidad, para que los términos técnicos, nombres de productos y nombres propios del programa lleguen de forma fiable tal como se quieren decir.
- Supervisabilidad, para que durante el evento se pueda ver en todo momento qué está reconociendo y emitiendo el sistema.
- Eficiencia, para que modelos potentes también puedan funcionar con equipos in situ, en lugar de depender de centros de datos remotos.
Qué significa la arquitectura para su evento
No necesita conocimientos especializados sobre modelos de lenguaje. Pero la arquitectura de un sistema de interpretación determina con qué flexibilidad puede optimizarse, supervisarse y seguir desarrollándose. Y eso es precisamente lo que usted nota en el evento: cuando el nombre de su patrocinador principal se traslada correctamente, cuando un término técnico de su sector es el adecuado o cuando, ante un problema, alguien puede intervenir rápidamente.
Por eso, en MILA no entendemos la interpretación simultánea como una interfaz que simplemente se conecta, sino como toda la cadena de procesamiento, del micrófono a los auriculares. En concreto, esto significa:
- Configuramos de antemano los términos técnicos y nombres propios de su programa.
- La interpretación simultánea con IA funciona localmente en nuestros propios equipos en el lugar del evento, sin nube. Lo que se dice no sale de su evento.
- Siempre hay un técnico de sistemas in situ. Planifica con usted, realiza el montaje, supervisa la interpretación durante el evento y se encarga del desmontaje.
- Cada idioma llega por un canal propio a su sistema de interpretación o equipo de conferencias existente; si lo desea, proporcionamos receptores y auriculares para los asistentes.
La investigación sobre sistemas speech-to-speech avanza rápidamente y la seguimos de cerca. Si desea saber cómo puede ser una interpretación simultánea para su congreso, su conferencia o su evento corporativo, encontrará detalles sobre la técnica y el desarrollo en nuestra página de servicios. Hemos reunido respuestas a preguntas frecuentes en nuestras FAQ.
