Blog · 19/8/2026
Speech-to-Speech Translation: cómo funciona la traducción de voz moderna con IA
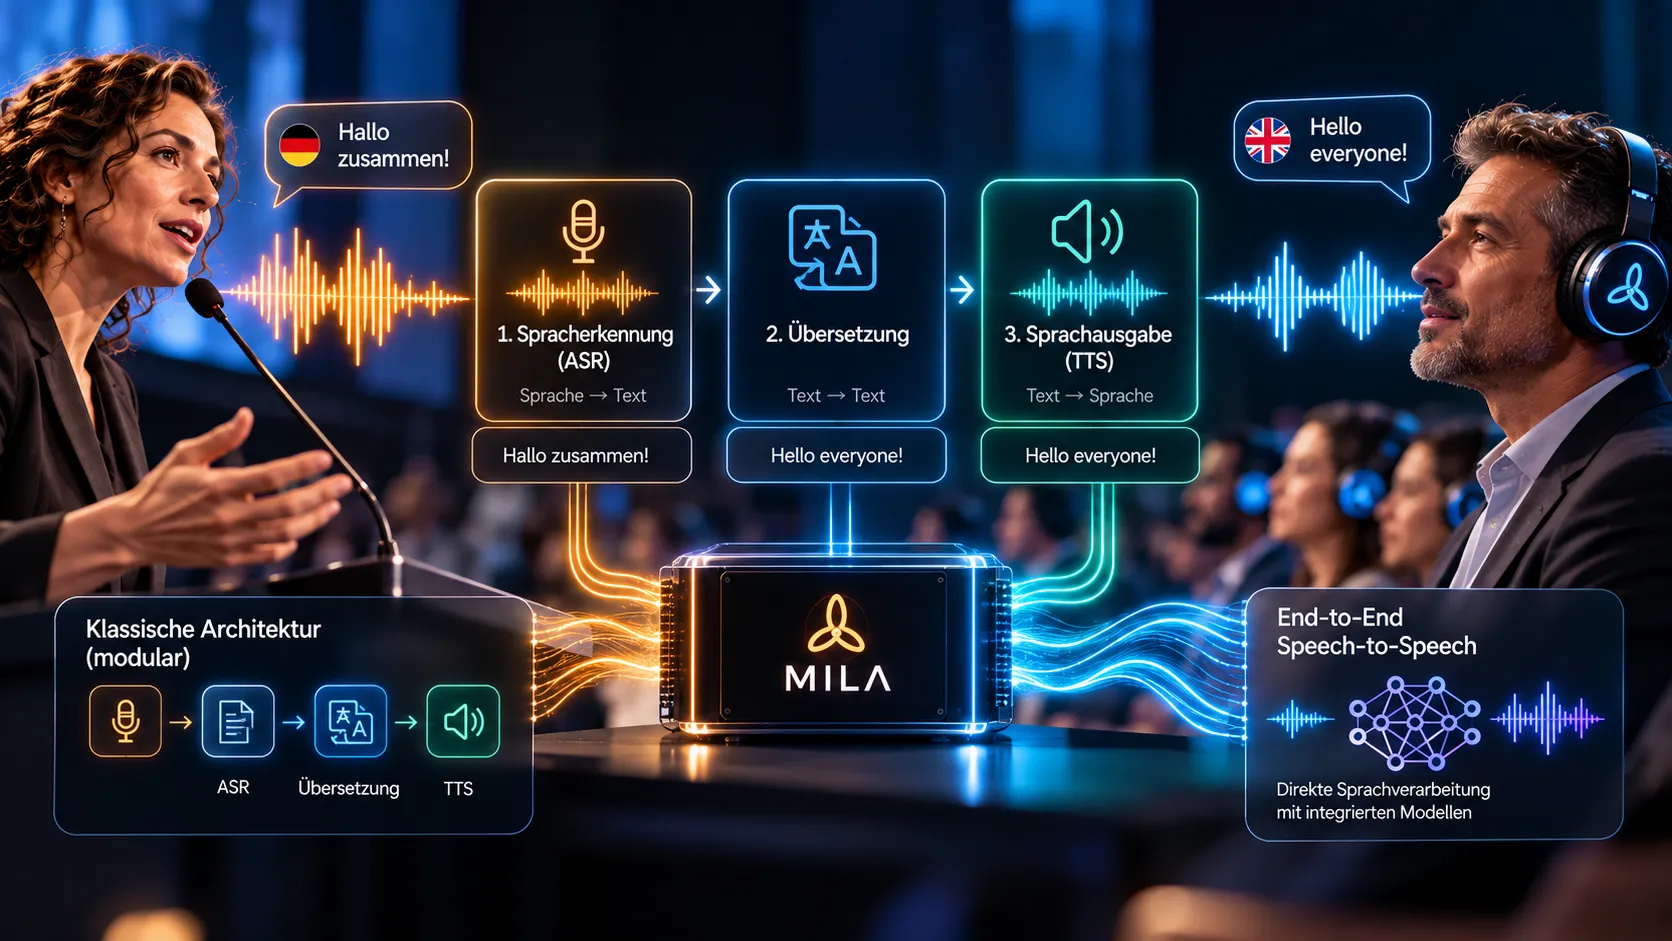
Una ponente habla en alemán y, en la sala, los asistentes siguen la ponencia a través de auriculares, en inglés, francés o polaco. Lo que para el público parece un único proceso consiste, desde el punto de vista técnico, en varias tareas que deben encajar estrechamente entre sí. De eso trata precisamente la Speech-to-Speech Translation, la traducción del lenguaje hablado a lenguaje hablado. En este artículo explicamos cómo está estructurada la cadena de procesamiento clásica, dónde están sus límites, qué nuevas arquitecturas de IA está probando la investigación y por qué estas cuestiones también son relevantes para usted como organizador.
Tres tareas, un objetivo
Un sistema profesional de interpretación con IA debe combinar varias tareas complejas. Debe:
- reconocer el lenguaje hablado,
- traducir el contenido a la lengua de destino,
- y generar a partir de ello una salida de voz comprensible.
Un intérprete simultáneo humano realiza todo esto en una sola mente: escuchar, comprender, trasladar, hablar. En la interpretación simultánea automática, estas tareas se reparten tradicionalmente entre distintos modelos, cada uno especializado en su parte. En qué se diferencian en lo esencial la interpretación con IA y los intérpretes de conferencias humanos lo analizamos en el artículo ¿Intérprete con IA o humano? ¿Sobra el intérprete simultáneo?
El reparto entre varios modelos tiene ventajas, pero también límites técnicos, y ambos aspectos merecen un análisis más detallado.
La cadena de procesamiento clásica de la Speech-to-Speech Translation
En su forma clásica, la Speech-to-Speech Translation se desarrolla en tres pasos consecutivos. El resultado de cada paso es la entrada del siguiente.
Paso 1: Reconocimiento automático del habla (ASR)
El punto de partida es el reconocimiento automático del habla, ASR por sus siglas en inglés (Automatic Speech Recognition). Convierte la señal de audio, por ejemplo la del micrófono del atril, en texto. Lo hablado se convierte en palabras y frases.
Paso 2: Traducción automática
A continuación, un modelo de traducción automática traduce el contenido reconocido a la lengua de destino. Trabaja con el texto que ha proporcionado el reconocimiento del habla, no con el audio original.
Paso 3: Síntesis de voz (Text-to-Speech)
En el tercer paso, un sistema Text-to-Speech, TTS por sus siglas, genera la salida hablada a partir del texto traducido. Esta es la voz que finalmente escuchan los asistentes en los auriculares o a través del equipo de conferencias.
La ventaja: cada componente puede mejorarse por separado
Esta arquitectura modular tiene una ventaja clara: los distintos componentes pueden optimizarse de forma independiente. Si se dispone de un modelo mejor para uno de los pasos, puede incorporarse sin necesidad de volver a desarrollar los demás módulos. Cada parte de la cadena puede comprobarse, ajustarse y sustituirse de forma específica.
Dónde están los retos
Por clara que sea la cadena, conlleva retos fundamentales.
Cada paso de procesamiento requiere tiempo
El reconocimiento del habla, la traducción y la síntesis de voz se suceden uno tras otro, y cada uno de estos pasos requiere tiempo. En una interpretación simultánea, en la que los asistentes deben seguir el programa con el menor desfase posible, este es un factor clave.
Los errores se propagan por la cadena
Otro reto es menos evidente: los errores pueden transmitirse de un componente al siguiente. Si el reconocimiento del habla interpreta mal un término, el modelo de traducción recibe ya información errónea. Es posible que lo traduzca correctamente, pero traducirá algo equivocado. Al final, la síntesis de voz reproduce ese error de forma audible.
Esto es especialmente delicado con los términos técnicos y los nombres propios, tan frecuentes en congresos y conferencias especializadas. Un solo término mal reconocido puede cambiar el significado de una frase. Por eso el primer paso es tan importante, y con él la calidad de la señal de entrada. Por qué el sonido es decisivo en tantos aspectos lo explicamos en el artículo Interpretación con IA y técnica de audio: por qué todo empieza en el micrófono.
End-to-End Speech-to-Speech Translation: el camino más directo
Un campo de investigación alternativo se ocupa de modelos que procesan la información del habla de forma más directa. Se habla de End-to-End Speech-to-Speech Translation. Estos sistemas pueden reducir determinados pasos intermedios o conectarlos internamente de forma más estrecha: en lugar de etapas estrictamente separadas, surge una vía de procesamiento más integrada.
Qué pueden conservar los modelos integrados
El atractivo de este enfoque reside en lo que puede perderse en la cadena clásica. En cuanto el lenguaje hablado se convierte en texto, quedan sobre todo las palabras. Las características de la voz, la prosodia (es decir, la acentuación, el ritmo y la entonación) y parte del contexto lingüístico no figuran en el texto.
Los enfoques integrados abren nuevas posibilidades para transmitir también esa información. Hasta dónde ha llegado la investigación, por ejemplo, en la transmisión de emociones y dónde están sus límites lo hemos resumido en el artículo ¿Puede la IA traducir emociones?
No es un atajo automático
Sin embargo, los sistemas integrados no son automáticamente más rápidos ni más fiables solo porque tengan menos pasos intermedios separados. También hay que tener en cuenta su controlabilidad y su capacidad de adaptación.
Para su uso en eventos, esto no es un detalle menor: quien quiera configurar de antemano términos técnicos y nombres propios y supervisar la interpretación durante el evento necesita un sistema sobre el que se pueda intervenir de forma específica.
¿Arquitectura modular o integrada?
Ambos enfoques tienen ventajas: los sistemas modulares pueden sustituirse y optimizarse módulo a módulo. Los modelos integrados pueden conservar información como la prosodia y las características de la voz, que se pierde en un procesamiento intermedio basado en texto. Qué arquitectura es más adecuada depende de los requisitos: no hay una respuesta universal.
Qué significa esto para su evento
Como organizador, agencia, empresa o asociación, usted no tiene que evaluar arquitecturas de modelos. Lo que cuenta para usted es que sus asistentes puedan seguir el programa en su idioma, ya sea en un congreso, en una junta general de accionistas o en una sesión pública. Aun así, conocer la cadena de procesamiento resulta útil cuando planifica una interpretación simultánea para su evento, porque algunos factores pueden influirse de antemano:
- El sonido: como todo empieza con el reconocimiento del habla, una señal de micrófono limpia contribuye a determinar lo que llega a los pasos siguientes.
- El programa: los términos técnicos y nombres propios conocidos de antemano pueden prepararse. En MILA los configuramos antes del evento.
- La supervisión: una interpretación simultánea asistida por IA no debería funcionar sin supervisión. En nuestro caso, un técnico de sistemas supervisa la interpretación in situ durante el evento.
La perspectiva de MILA
Para MILA, la arquitectura de un sistema de voz es una decisión técnica fundamental. Nos ocupamos de cómo combinar calidad de interpretación, capacidad en tiempo real y procesamiento local.
El procesamiento local es una parte fija de nuestra oferta: nuestra interpretación simultánea con IA funciona localmente en nuestro propio equipo en el lugar del evento, sin nube. Lo que se dice no sale del evento.
Para ello analizamos tanto modelos individuales especializados como nuevos enfoques integrados. Porque la calidad de un sistema de interpretación con IA no surge de un único modelo, sino de la interacción de toda la cadena de procesamiento: desde la señal de entrada y la preparación de los idiomas hasta la supervisión in situ.
Al final de la cadena, cada idioma llega por un canal propio al sistema de interpretación o equipo de conferencias existente; si lo desea, ponemos a disposición de los asistentes receptores y auriculares. Encontrará los detalles sobre la técnica, el desarrollo y los servicios adicionales en nuestra página de servicios. Si está planificando un evento multilingüe, estaremos encantados de hablar con usted sobre lo que necesita su programa.
