Blog · 14/08/2026
Petits modèles de langage : pourquoi plus petit peut être mieux en interprétation
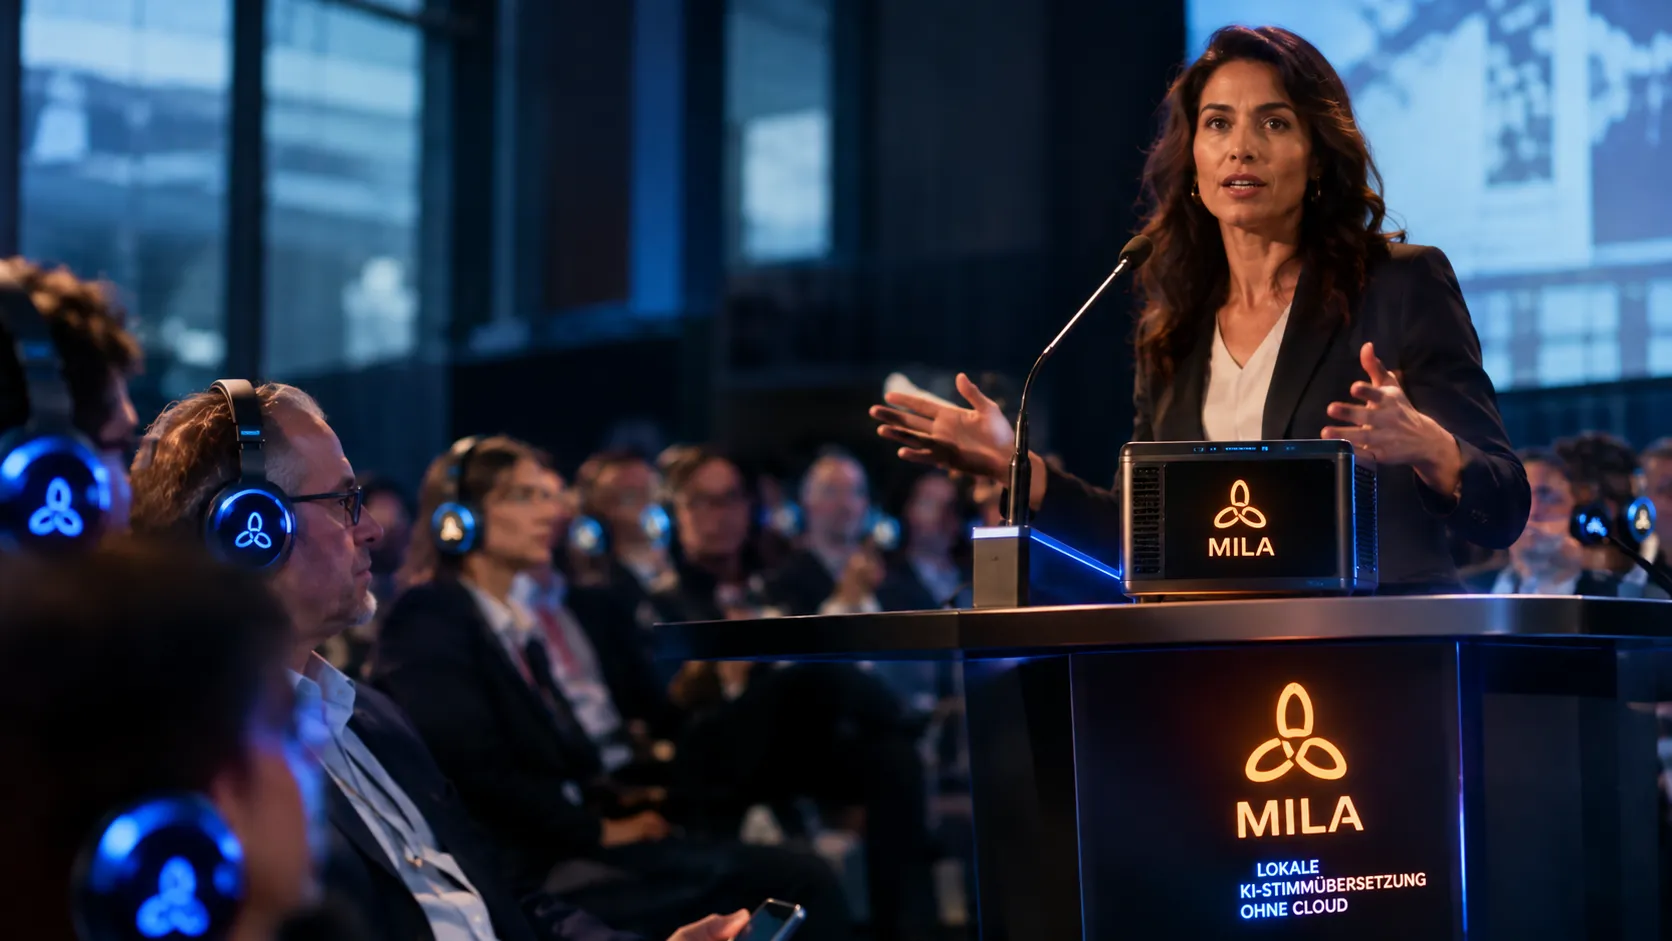
Lorsqu'il est question d'intelligence artificielle, on parle souvent en superlatifs : toujours plus de paramètres, toujours plus de données d'entraînement, toujours plus de puissance de calcul. Cette voie a permis des progrès impressionnants. Pour l'interprétation simultanée lors d'événements, une autre question, très pratique, se pose toutefois : de quelle puissance d'IA a-t-on réellement besoin ? C'est précisément là qu'interviennent les petits modèles de langage. Dans cet article, nous expliquons pourquoi des modèles spécialisés et optimisés de manière ciblée sont intéressants pour les systèmes d'interprétation, quelles techniques se cachent derrière – et où se situent leurs limites.
Plus grand ne veut pas automatiquement dire meilleur
Le développement de l'intelligence artificielle a longtemps été marqué par une idée simple : plus de paramètres, plus de données d'entraînement et plus de puissance de calcul donnent des modèles plus performants. Ce lien n'est pas faux – il a fait naître bon nombre des capacités qui semblent aujourd'hui presque aller de soi.
Pour de nombreuses applications pratiques, il est toutefois insuffisant. Lorsque l'on utilise une technologie au quotidien, on ne se demande pas seulement ce qu'un modèle sait faire en principe. L'essentiel est de savoir s'il accomplit une tâche donnée de manière fiable – dans les conditions réelles. Lors d'un événement, cela signifie : avec la technique disponible sur place, et pendant que le programme se déroule.
La spécialisation plutôt que la taille maximale
Un modèle de langage universel est un généraliste. Il doit programmer, rédiger des textes, résoudre des problèmes mathématiques et répondre à des questions sur n'importe quel sujet. Cette polyvalence a un prix : un modèle censé tout savoir faire doit réunir un très grand nombre de capacités.
Un modèle de reconnaissance vocale ou de traduction a, en revanche, une mission clairement définie. Il doit reconnaître la langue parlée ou transposer une phrase d'une langue dans une autre. Le code informatique ou les exercices de mathématiques n'en font pas partie. Un tel modèle spécialisé n'a donc pas nécessairement besoin du même éventail de capacités qu'un modèle polyvalent.
Grâce à une optimisation ciblée, des modèles plus petits peuvent être très performants pour certaines tâches. Une comparaison tirée de l'atelier : pour une vis donnée, il ne faut pas toute la caisse à outils, mais la bonne clé.
Comment les petits modèles de langage gagnent en efficacité
Il existe différentes méthodes pour alléger les modèles. Deux d'entre elles jouent un rôle particulièrement important dans les développements actuels : la quantification et la Knowledge Distillation.
Quantification : moins de précision, moins de mémoire
Un modèle de langage se compose essentiellement d'un très grand nombre de valeurs numériques, appelées poids du modèle. La quantification consiste à stocker et à traiter ces poids avec une précision numérique moindre – pour simplifier : avec des nombres plus grossièrement échelonnés plutôt qu'avec une résolution très fine.
Cela peut réduire nettement la mémoire nécessaire à un modèle et donc les exigences matérielles.
La méthode a cependant un revers. Selon le procédé et le modèle, une partie de la précision peut être perdue. L'ampleur de cette perte ne peut pas être définie de manière générale. C'est pourquoi la règle est la suivante : après chaque optimisation, la qualité doit être vérifiée à nouveau. Un modèle qui consomme moins de mémoire mais ne reconnaît plus de manière fiable les termes techniques ne serait pas une amélioration pour une conférence spécialisée.
Knowledge Distillation : du grand modèle au petit
Une deuxième approche est la Knowledge Distillation, autrement dit une distillation des connaissances. Un modèle plus petit est entraîné à l'aide d'un modèle plus grand. Le grand modèle joue en quelque sorte le rôle de l'enseignant, le plus petit celui de l'élève.
L'objectif est de rendre certaines capacités du grand modèle exploitables dans une architecture plus efficace. Le petit modèle n'a donc pas besoin de maîtriser tout ce que sait faire son modèle de référence – mais surtout ce pour quoi il sera utilisé par la suite.
Pourquoi c'est pertinent pour l'interprétation simultanée
Trois tâches qui se partagent les ressources
Dans les systèmes d'interprétation professionnels, ce n'est pas un modèle unique qui travaille : plusieurs tâches doivent être exécutées simultanément. Nous avons décrit plus en détail la manière dont ces étapes s'articulent classiquement dans l'article L'IA peut-elle traduire les émotions ? :
- Reconnaissance vocale : les propos tenus sont reconnus.
- Traduction : le contenu reconnu est transposé dans la langue cible.
- Synthèse vocale : une voix artificielle restitue la traduction.
Ces trois étapes se disputent les mêmes ressources : la puissance de calcul et la mémoire. Et ce, non pas une seule fois, mais en continu – tant que l'on parle sur scène.
Ce que des modèles plus efficaces peuvent permettre
Des modèles plus efficaces peuvent donc offrir un avantage pratique considérable. Si chaque tâche sollicite moins de ressources, une marge de manœuvre se crée. Cette marge permet éventuellement :
- davantage de canaux linguistiques en parallèle, par exemple lorsque les participants suivent un événement dans plusieurs langues cibles,
- des exigences matérielles réduites sur le lieu de l'événement,
- des temps de traitement plus courts, c'est-à-dire moins de décalage entre l'original parlé et la traduction.
Le mot « éventuellement » est choisi délibérément. L'avantage qui se concrétise réellement dans la pratique dépend du modèle, du procédé d'optimisation et du système dans son ensemble – et doit, comme pour la quantification, être vérifié à chaque fois.
L'IA en local : pourquoi l'efficacité n'est pas pour nous une question théorique
Chez MILA, l'interprétation simultanée par IA fonctionne en local, sur notre propre équipement installé sur le lieu de l'événement – sans cloud. Les propos tenus ne quittent pas l'événement. Pour les entreprises, les associations et les institutions publiques dont les événements abordent aussi des sujets confidentiels, cela peut être un point important.
Mais le fonctionnement en local signifie aussi que les calculs sont effectués sur le matériel que nous apportons. C'est pourquoi la question de savoir de quelle puissance un modèle a besoin pour sa tâche n'a pas, pour nous, un intérêt purement académique.
Pour vous, en tant qu'organisateur, le déroulement reste simple : chaque langue est transmise sur un canal dédié au système d'interprétation ou à l'équipement de conférence existant ; sur demande, nous fournissons des récepteurs et des casques pour les participants. Si vous cherchez un interprète pour vos événements, vous n'avez donc pas à vous préoccuper des architectures de modèles – nous nous en chargeons.
Le point de vue de MILA : la taille n'est pas un critère de qualité
Pour MILA, ce n'est pas la taille d'un modèle de langage qui est déterminante. Quatre critères comptent :
- Qualité de la traduction : le contenu arrive-t-il de manière compréhensible et correcte dans la langue cible ?
- Latence : combien de temps s'écoule entre l'original et la traduction ?
- Stabilité : le système fonctionne-t-il de manière fiable pendant toute la durée de l'événement ?
- Consommation de ressources : quelle puissance de calcul et quelle mémoire sont nécessaires ?
Nous suivons donc de près le développement de modèles efficaces et des technologies d'inférence locale – c'est-à-dire des procédés permettant d'exécuter des modèles directement sur son propre matériel.
Ce qui peut être planifié indépendamment du modèle est tout aussi important : nous paramétrons à l'avance les termes techniques et les noms propres du programme, et un technicien système est toujours présent sur place. Il planifie avec vous, installe le matériel, supervise la traduction pendant l'événement et procède au démontage. Et comme même le meilleur modèle ne peut traduire que ce qu'il entend, le son joue un rôle tout aussi important – pour en savoir plus, consultez notre article Interprétation par IA et technique audio : pourquoi tout commence au micro.
Conclusion : l'IA adaptée plutôt que la plus grande
Les petits modèles de langage ne sont pas une fin en soi. La quantification et la Knowledge Distillation peuvent alléger les modèles, mais chaque optimisation doit se mesurer à l'aune de la qualité. Pour l'interprétation simultanée lors de congrès, de conférences spécialisées ou d'événements d'entreprise, ce qui compte au final, c'est ce qui parvient dans la salle.
Pour les applications professionnelles, l'IA la plus intéressante n'est pas toujours la plus grande – mais celle qui accomplit sa tâche de manière fiable.
Si vous prévoyez une interprétation pour votre prochain événement, vous trouverez tous les détails sur la technique, les langues et le déroulement sur notre page consacrée à nos prestations. Nous avons rassemblé les réponses aux questions fréquentes dans notre FAQ.
