Blogg · 2026-08-14
Små språkmodeller: Varför mindre kan vara bättre vid tolkning
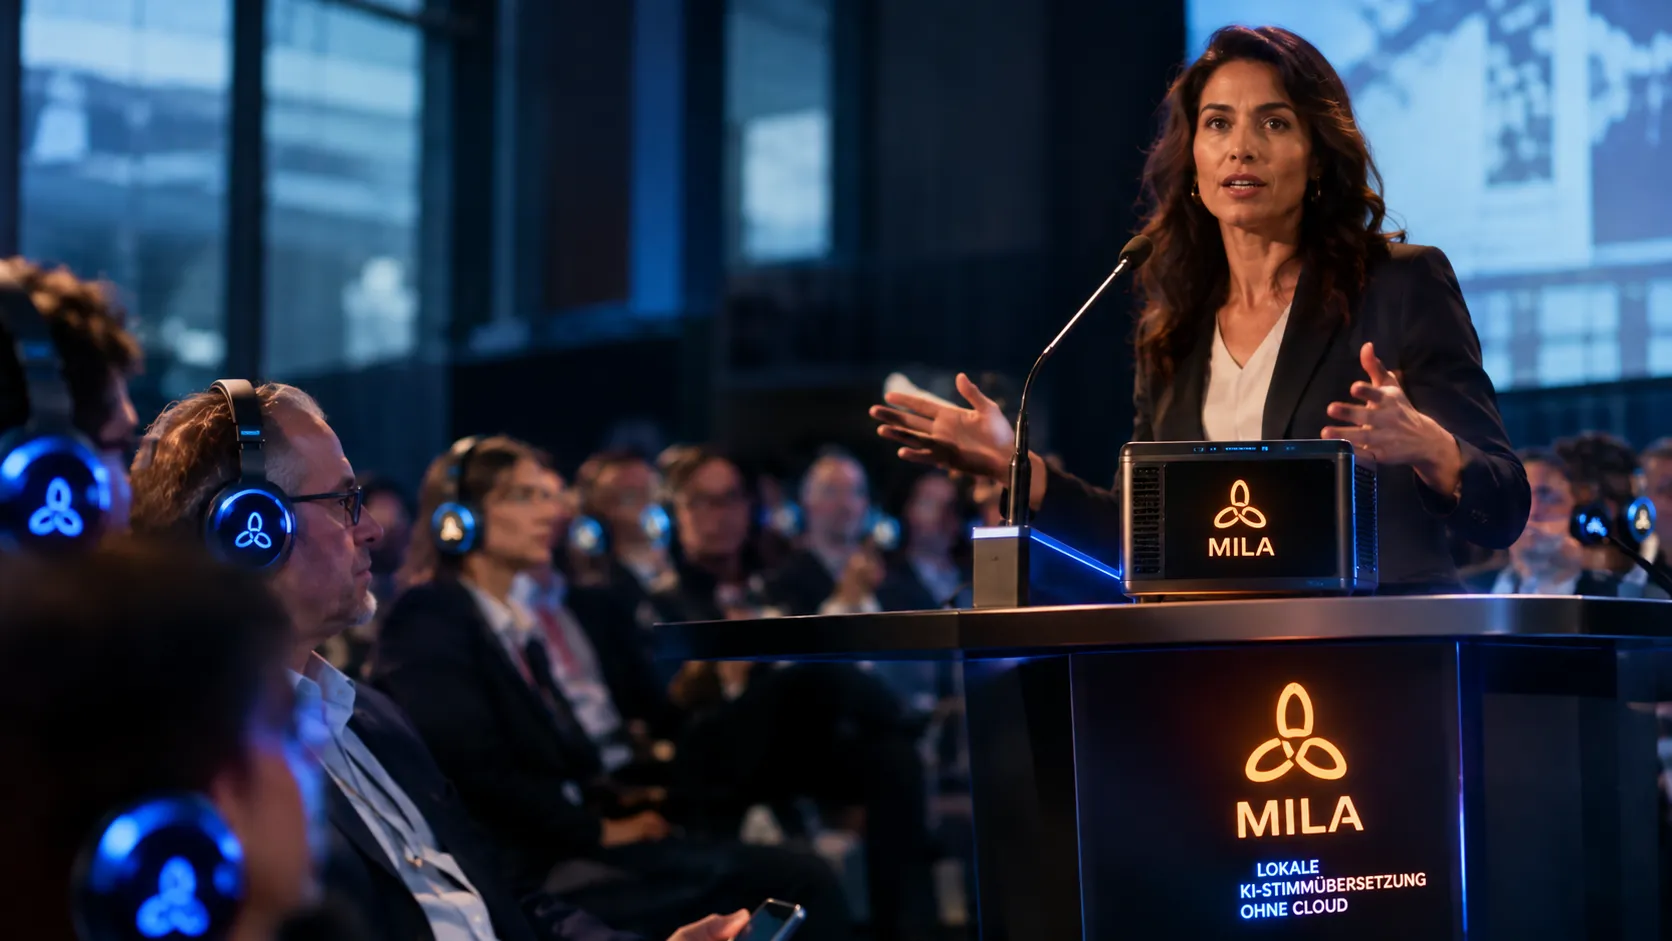
När det rapporteras om artificiell intelligens handlar det ofta om superlativ: allt fler parametrar, allt mer träningsdata, allt mer beräkningskraft. Den vägen har möjliggjort imponerande framsteg. För simultantolkning vid evenemang uppstår dock en annan, mycket praktisk fråga: Hur mycket AI-kapacitet behövs egentligen? Det är just här som små språkmodeller kommer in i bilden. I det här inlägget förklarar vi varför specialiserade och målinriktat optimerade modeller är intressanta för tolksystem, vilka tekniker som ligger bakom – och var gränserna går.
Större är inte automatiskt bättre
Utvecklingen av artificiell intelligens har länge präglats av en enkel föreställning: fler parametrar, mer träningsdata och mer beräkningskraft leder till kraftfullare modeller. Det sambandet är inte fel – det har gett upphov till många av de förmågor som i dag känns nästan självklara.
För många praktiska tillämpningar räcker det dock inte. Den som använder en teknik i vardagen frågar inte bara vad en modell i princip kan. Det avgörande är om den utför en viss uppgift tillförlitligt – under de förhållanden som faktiskt råder. Vid ett evenemang innebär det: med den teknik som finns på plats, och medan programmet pågår.
Specialisering i stället för maximal storlek
En universell språkmodell är en generalist. Den ska programmera, skriva texter, lösa matematiska problem och besvara frågor om vilket ämne som helst. Den bredden har sitt pris: en modell som ska kunna allt måste rymma väldigt många förmågor.
En modell för taligenkänning eller översättning har däremot ett tydligt avgränsat uppdrag. Den ska känna igen talat språk eller överföra en mening från ett språk till ett annat. Programkod eller matematiska uppgifter ingår inte. En sådan specialiserad modell behöver därför inte nödvändigtvis samma bredd av förmågor som en allroundmodell.
Genom målinriktad optimering kan mindre modeller vara mycket kraftfulla för vissa uppgifter. En jämförelse från verkstaden: för en viss skruv behövs inte hela sortimentet, utan rätt nyckel.
Hur små språkmodeller blir effektivare
Det finns olika metoder för att göra modeller slankare. Två av dem spelar en särskilt viktig roll i den aktuella utvecklingen: kvantisering och knowledge distillation.
Kvantisering: mindre precision, mindre minne
En språkmodell består i grunden av väldigt många talvärden, så kallade modellvikter. Vid kvantisering lagras och bearbetas dessa vikter med lägre numerisk precision – förenklat uttryckt: med grövre graderade tal i stället för mycket finupplösta.
Det kan avsevärt minska en modells minnesbehov och därmed sänka kraven på hårdvaran.
Metoden har dock en baksida. Beroende på metod och modell kan en del av noggrannheten gå förlorad. Hur stor den förlusten blir går inte att säga generellt. Därför gäller: efter varje optimering måste kvaliteten kontrolleras på nytt. En modell som behöver mindre minne men inte längre känner igen fackterminologi tillförlitligt vore ingen förbättring för en fackkonferens.
Knowledge distillation: från stor till liten modell
Ett andra tillvägagångssätt är så kallad knowledge distillation, ungefär kunskapsdestillering. Här tränas en mindre modell med hjälp av en större modell. Den stora modellen tar så att säga rollen som lärare, den mindre rollen som elev.
Målet är att göra vissa förmågor hos den stora modellen användbara i en effektivare arkitektur. Den lilla modellen behöver alltså inte behärska allt som förebilden kan – utan framför allt det som den senare ska användas till.
Varför detta är relevant för simultantolkning
Tre uppgifter som delar på resurserna
I professionella tolksystem arbetar inte en enda modell, utan flera uppgifter måste utföras samtidigt. Hur dessa steg klassiskt samverkar har vi beskrivit mer ingående i inlägget Kan AI översätta känslor?:
- Taligenkänning: Det som sägs känns igen.
- Översättning: Det igenkända innehållet överförs till målspråket.
- Talsyntes: En syntetisk röst återger översättningen.
Alla tre stegen konkurrerar om samma resurser: beräkningskraft och minne. Och det inte en gång, utan fortlöpande – så länge det talas på scenen.
Vad effektivare modeller kan möjliggöra
Effektivare modeller kan därför ge en betydande praktisk fördel. När varje enskild uppgift tar mindre resurser i anspråk uppstår utrymme. Det utrymmet möjliggör eventuellt:
- fler parallella språkkanaler, till exempel när gäster följer ett evenemang på flera målspråk,
- lägre hårdvarukrav på evenemangsplatsen,
- kortare bearbetningstider, alltså mindre fördröjning mellan det talade originalet och översättningen.
Ordet ”eventuellt” är medvetet valt. Vilken fördel som faktiskt uppstår i praktiken beror på den aktuella modellen, optimeringsmetoden och helhetssystemet – och måste, precis som vid kvantisering, kontrolleras varje gång.
Lokal AI: Varför effektivitet inte är en teorifråga för oss
Hos MILA körs AI-simultantolkningen lokalt på vår egen teknik på evenemangsplatsen – utan moln. Det som sägs lämnar inte evenemanget. För företag, organisationer och offentliga verksamheter, där även konfidentiella ämnen tas upp under evenemangen, kan det vara en viktig punkt.
Lokal drift innebär dock också: beräkningarna görs på den teknik vi tar med oss. Därför är frågan om hur mycket kapacitet en modell behöver för sin uppgift inte bara av akademiskt intresse för oss.
För er som arrangör förblir upplägget överskådligt: varje språk läggs på en egen kanal i den befintliga tolkanläggningen eller konferenstekniken, och på önskemål tillhandahåller vi mottagare och hörlurar till gästerna. Den som söker en tolk till evenemang behöver alltså inte sätta sig in i modellarkitekturer – det sköter vi.
MILA:s perspektiv: Storlek är inget kvalitetskriterium
För MILA är det inte storleken på en språkmodell som är avgörande. Fyra kriterier är relevanta:
- Översättningskvalitet: Når innehållet fram begripligt och korrekt på målspråket?
- Latens: Hur lång tid går det mellan original och översättning?
- Stabilitet: Fungerar systemet tillförlitligt under hela evenemanget?
- Resursförbrukning: Hur mycket beräkningskraft och minne krävs?
Vi följer därför särskilt utvecklingen av effektiva modeller och lokala inferenstekniker – alltså de metoder med vilka modeller körs direkt på egen hårdvara.
Lika viktigt är det som kan planeras oberoende av modellen: fackterminologi och egennamn från programmet lägger vi in i förväg, och en systemtekniker finns alltid på plats. Hen planerar tillsammans med er, riggar, övervakar tolkningen under evenemanget och riggar ner igen. Och eftersom även den bästa modellen bara kan översätta det den hör spelar ljudet en lika stor roll – läs mer i vårt inlägg AI-tolkning och ljudteknik: Varför allt börjar vid mikrofonen.
Slutsats: Rätt AI i stället för den största
Små språkmodeller är inget självändamål. Kvantisering och knowledge distillation kan göra modeller slankare, men varje optimering måste mätas mot kvaliteten. För simultantolkning vid kongresser, fackkonferenser eller företagsevenemang är det i slutändan det som når fram i salen som räknas.
Den mest spännande AI:n för professionella tillämpningar är inte alltid den största – utan den som utför sin uppgift tillförlitligt.
Om ni planerar tolkning till ert nästa evenemang hittar ni all information om teknik, språk och upplägg på vår sida om våra tjänster. Svar på vanliga frågor har vi samlat i våra FAQ.
