Blog · 14/8/2026
Modelos de lenguaje pequeños: por qué más pequeño puede ser mejor en la interpretación
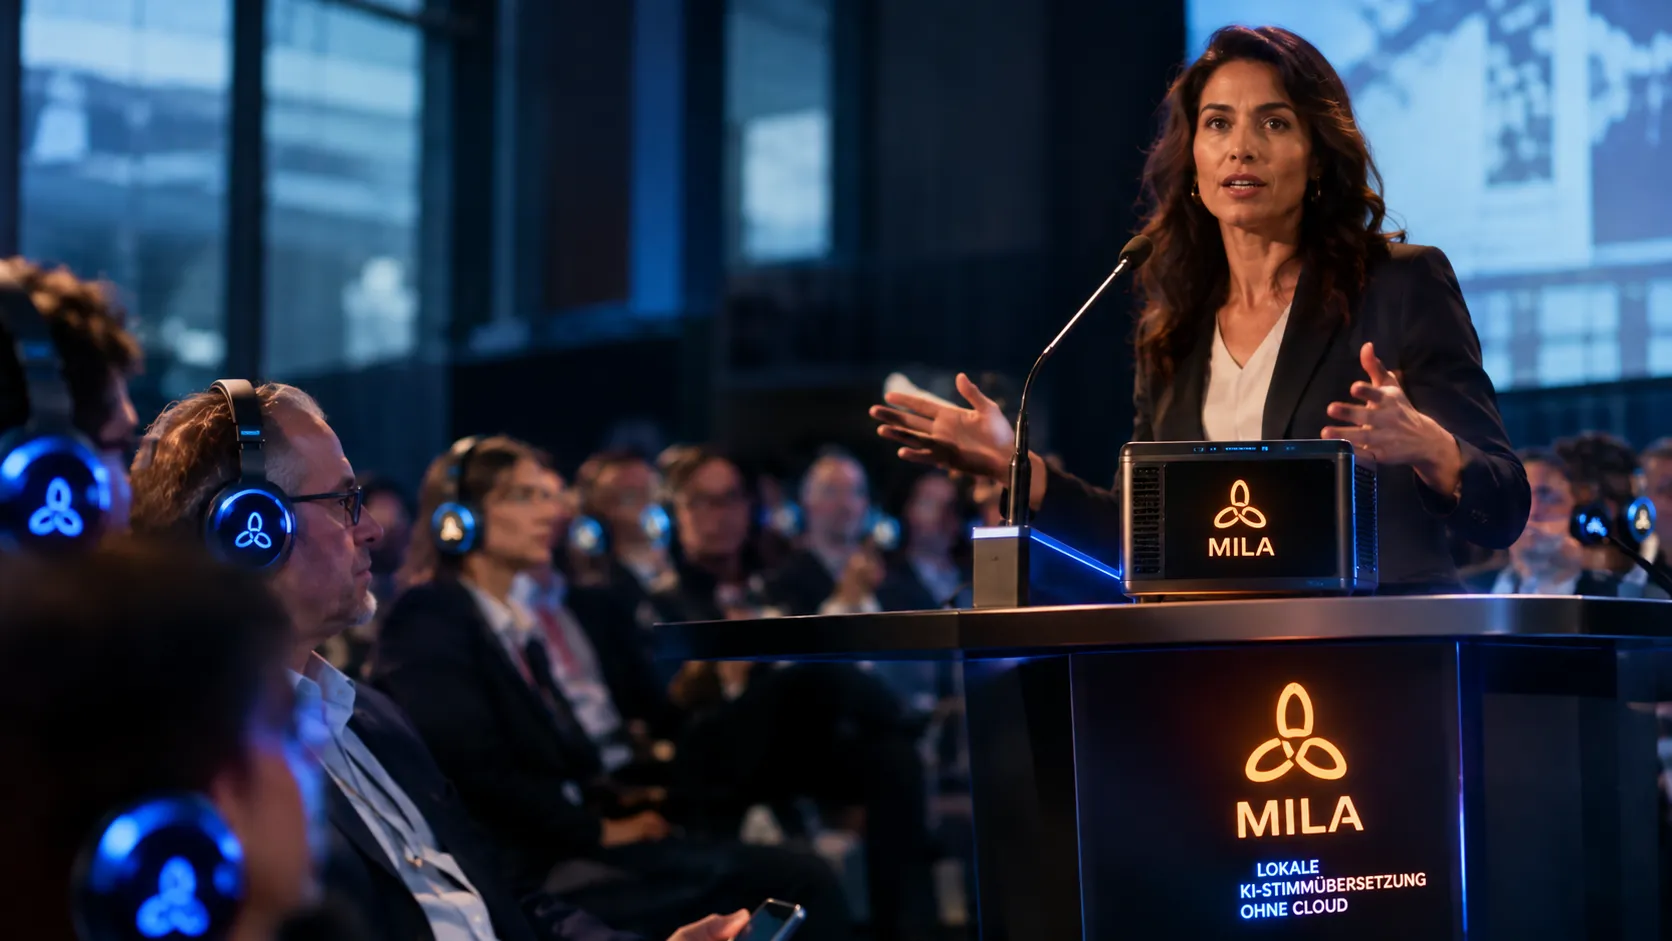
Cuando se habla de inteligencia artificial, a menudo se habla en superlativos: cada vez más parámetros, cada vez más datos de entrenamiento, cada vez más capacidad de cálculo. Este camino ha hecho posibles avances impresionantes. Sin embargo, en la interpretación simultánea para eventos se plantea otra pregunta, muy práctica: ¿cuánta potencia de IA se necesita realmente? Justo aquí entran en juego los modelos de lenguaje pequeños. En este artículo explicamos por qué los modelos especializados y optimizados de forma específica resultan interesantes para los sistemas de interpretación, qué técnicas hay detrás y dónde están sus límites.
Más grande no significa automáticamente mejor
Durante mucho tiempo, el desarrollo de la inteligencia artificial estuvo marcado por una idea sencilla: más parámetros, más datos de entrenamiento y más capacidad de cálculo dan lugar a modelos más potentes. Esta relación no es falsa: ha hecho posibles muchas de las capacidades que hoy parecen casi evidentes.
Pero para muchas aplicaciones prácticas se queda corta. Quien utiliza una tecnología en el día a día no solo se pregunta qué es capaz de hacer un modelo en principio. Lo decisivo es si realiza una tarea concreta de forma fiable, en las condiciones que realmente se dan. En un evento, eso significa: con la técnica disponible in situ y mientras el programa está en marcha.
Especialización en lugar de tamaño máximo
Un modelo de lenguaje universal es un generalista. Debe programar, redactar textos, resolver problemas matemáticos y responder preguntas sobre cualquier tema. Esta amplitud tiene su precio: un modelo que debe saber hacerlo todo tiene que reunir una gran cantidad de capacidades.
En cambio, un modelo de reconocimiento de voz o de traducción tiene un cometido claramente delimitado. Debe reconocer el lenguaje hablado o trasladar una frase de un idioma a otro. El código de programación o los problemas matemáticos no forman parte de ello. Por eso, un modelo especializado de este tipo no necesita forzosamente la misma amplitud de capacidades que un modelo todoterreno.
Gracias a una optimización específica, los modelos más pequeños pueden ser muy potentes para determinadas tareas. Una comparación del taller: para un tornillo concreto no hace falta todo el surtido, sino la llave adecuada.
Cómo se vuelven más eficientes los modelos de lenguaje pequeños
Existen diversos procedimientos para hacer los modelos más ligeros. Dos de ellos desempeñan un papel especialmente importante en el desarrollo actual: la cuantización y la Knowledge Distillation.
Cuantización: menos precisión, menos memoria
En esencia, un modelo de lenguaje está formado por una enorme cantidad de valores numéricos, los llamados pesos del modelo. En la cuantización, estos pesos se almacenan y procesan con menor precisión numérica; dicho de forma simplificada: con números de escala más gruesa en lugar de con una resolución muy fina.
Esto puede reducir considerablemente la memoria que necesita un modelo y, con ello, los requisitos de hardware.
No obstante, el método tiene una contrapartida. Según el procedimiento y el modelo, puede perderse parte de la precisión. No es posible decir de forma general cuán grande es esa pérdida. Por eso, la regla es: después de cada optimización hay que volver a comprobar la calidad. Un modelo que necesite menos memoria, pero que ya no reconozca de forma fiable los términos técnicos, no supondría ninguna mejora para una conferencia especializada.
Knowledge Distillation: del modelo grande al pequeño
Un segundo enfoque es la llamada Knowledge Distillation, es decir, una destilación del conocimiento. En ella, un modelo más pequeño se entrena con ayuda de un modelo más grande. El modelo grande asume, por así decirlo, el papel de profesor, y el más pequeño, el de alumno.
El objetivo es aprovechar determinadas capacidades del modelo grande en una arquitectura más eficiente. Así, el modelo pequeño no tiene que dominar todo lo que sabe hacer su referente, sino sobre todo aquello para lo que se utilizará después.
Por qué esto es relevante para la interpretación simultánea
Tres tareas que se reparten los recursos
En los sistemas de interpretación profesionales no trabaja un único modelo, sino que deben ejecutarse varias tareas a la vez. En el artículo ¿Puede la IA traducir emociones? describimos con más detalle cómo interactúan tradicionalmente estos pasos:
- Reconocimiento de voz: se reconoce lo que se dice.
- Traducción: el contenido reconocido se traslada al idioma de destino.
- Síntesis de voz: una voz artificial reproduce la traducción.
Los tres pasos compiten por los mismos recursos: capacidad de cálculo y memoria. Y no de forma puntual, sino continuamente, mientras se hable en el escenario.
Lo que pueden hacer posible los modelos más eficientes
Por ello, los modelos más eficientes pueden ofrecer una ventaja práctica considerable. Si cada tarea consume menos recursos, se gana margen. Este margen posiblemente permita:
- más canales de idioma en paralelo, por ejemplo cuando los asistentes siguen un evento en varios idiomas de destino,
- menores requisitos de hardware en el lugar del evento,
- tiempos de procesamiento más cortos, es decir, menos desfase entre el original hablado y la traducción.
La palabra «posiblemente» está elegida a conciencia. Qué ventaja se obtiene realmente en la práctica depende del modelo concreto, del procedimiento de optimización y del sistema en su conjunto, y, como en la cuantización, debe comprobarse en cada caso.
IA local: por qué para nosotros la eficiencia no es una cuestión teórica
En MILA, la interpretación simultánea con IA funciona en local, en nuestra propia técnica en el lugar del evento, sin nube. Lo que se dice no sale del evento. Para empresas, asociaciones e instituciones públicas en cuyos eventos también se tratan temas confidenciales, esto puede ser un aspecto importante.
Pero el funcionamiento local también significa que los cálculos se realizan en la técnica que llevamos con nosotros. Por eso, la cuestión de cuánta potencia necesita un modelo para su tarea no es para nosotros un asunto meramente académico.
Para usted, como organizador, el proceso sigue siendo sencillo: cada idioma llega por un canal propio al sistema de interpretación o a la técnica de conferencias existentes y, si lo desea, ponemos receptores y auriculares a disposición de los asistentes. Por tanto, quien busca un intérprete para eventos no tiene que ocuparse de arquitecturas de modelos: de eso nos encargamos nosotros.
La perspectiva de MILA: el tamaño no es un criterio de calidad
Para MILA, lo decisivo no es el tamaño de un modelo de lenguaje. Son relevantes cuatro criterios:
- Calidad de la traducción: ¿llega el contenido de forma comprensible y correcta al idioma de destino?
- Latencia: ¿cuánto tiempo transcurre entre el original y la traducción?
- Estabilidad: ¿funciona el sistema de forma fiable durante todo el evento?
- Consumo de recursos: ¿cuánta capacidad de cálculo y memoria se necesitan para ello?
Por eso seguimos con especial atención el desarrollo de modelos eficientes y de tecnologías de inferencia local, es decir, de los procedimientos con los que los modelos se ejecutan directamente en hardware propio.
Igual de importante es lo que puede planificarse con independencia del modelo: configuramos de antemano los términos técnicos y los nombres propios del programa, y siempre hay un técnico de sistemas in situ. Él planifica con usted, realiza el montaje, supervisa la traducción durante el evento y se encarga del desmontaje. Y como incluso el mejor modelo solo puede traducir lo que oye, el sonido desempeña un papel igual de importante; encontrará más información en nuestro artículo Interpretación con IA y técnica de audio: por qué todo empieza en el micrófono.
Conclusión: la IA adecuada en lugar de la más grande
Los modelos de lenguaje pequeños no son un fin en sí mismos. La cuantización y la Knowledge Distillation pueden hacer los modelos más ligeros, pero cada optimización debe medirse por la calidad. En la interpretación simultánea para congresos, conferencias especializadas o eventos corporativos, lo que cuenta al final es lo que llega a la sala.
Para las aplicaciones profesionales, la IA más interesante no siempre es la más grande, sino la que cumple su tarea de forma fiable.
Si está planificando la interpretación para su próximo evento, encontrará todos los detalles sobre técnica, idiomas y desarrollo en nuestra página de servicios. Hemos reunido las respuestas a las preguntas más habituales en las preguntas frecuentes.
