Blog · 10/08/2026
L'IA sa distinguere le voci? Riconoscimento del parlante e voice cloning spiegati
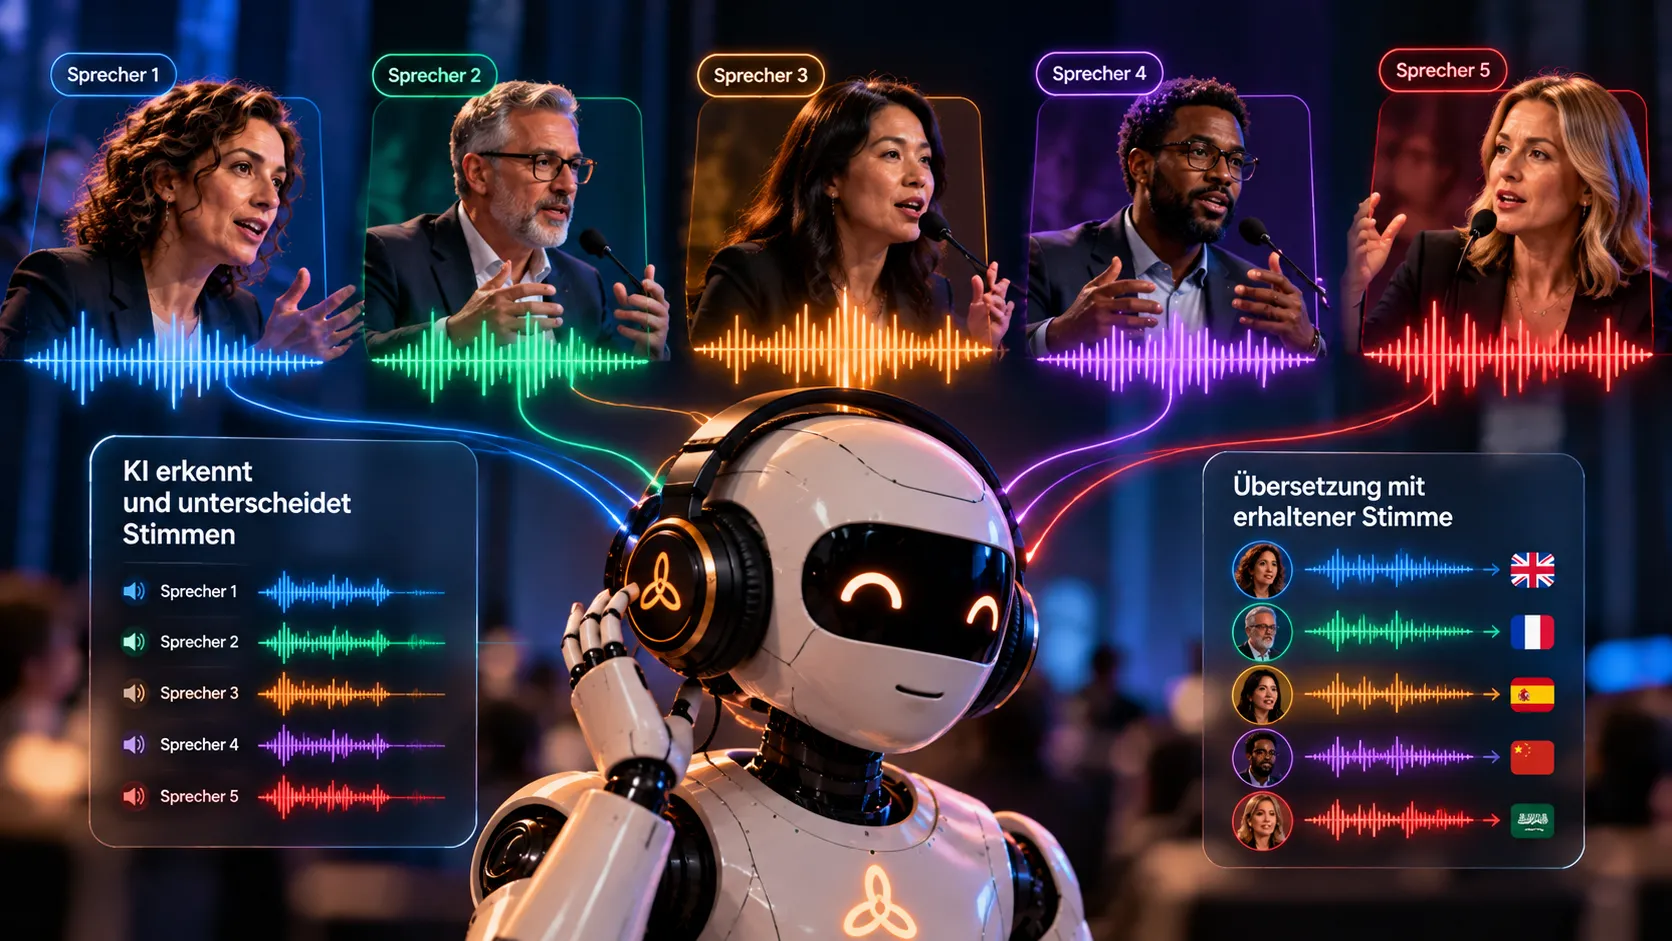
Chi sta parlando in questo momento? In una classica relazione questa domanda non si pone quasi mai: una persona parla, il pubblico ascolta. Sul palco di un panel, invece, le cose sono diverse. Più persone si alternano, si interrompono a vicenda o parlano contemporaneamente. Per un'interpretazione simultanea basata sull'IA questo comporta un compito aggiuntivo: il sistema non deve solo capire che cosa viene detto, ma possibilmente anche riconoscere chi sta parlando. È proprio di questo che si occupa il riconoscimento del parlante. In questo articolo spieghiamo come funziona la Speaker Diarization, perché il parlato sovrapposto è così impegnativo, che cosa potrebbe significare il Voice Cloning per l'interpretazione – e quale responsabilità comporta la riproduzione delle voci umane.
Dalla relazione al panel: perché la domanda „Chi parla?“ diventa importante
Che si tratti di un essere umano o dell'IA: per qualsiasi interpretazione il formato fa una grande differenza. In un keynote durante un congresso o in una presentazione a un evento aziendale c'è una fonte chiara: il microfono sul leggio o l'headset della persona sul palco. Chi sta parlando è evidente.
In una tavola rotonda la situazione cambia. Il moderatore pone una domanda, un ospite risponde, un secondo ribatte, un terzo aggiunge qualcosa a metà frase. Questi passaggi sono voluti, rendono vivace una discussione. Per un sistema di IA, però, significano che occorre risolvere due compiti contemporaneamente:
- Che cosa viene detto? È la base di ogni interpretazione.
- Chi lo dice? Questa informazione aiuta a distinguere i singoli interventi e a rendere comprensibili i nessi.
Chi segue una discussione attraverso l'interpretazione ha bisogno che i cambi tra le persone che parlano restino riconoscibili. Altrimenti interventi e repliche si confondono rapidamente in un unico flusso.
Riconoscimento del parlante tramite IA: che cosa fa la Speaker Diarization
Il termine tecnico per l'attribuzione temporale dei segmenti di parlato a diversi parlanti è Speaker Diarization. Un sistema di questo tipo analizza le caratteristiche acustiche del segnale e cerca di distinguere le diverse voci tra loro.
Il risultato è una struttura temporale. In forma semplificata può apparire così:
- il parlante A parla nel primo segmento,
- subentra il parlante B,
- prende la parola il parlante C,
- poi parla di nuovo il parlante A.
C'è un aspetto importante che spesso viene trascurato: la Speaker Diarization non equivale all'identificazione delle persone. Il sistema non deve necessariamente sapere quali persone reali si celino dietro le voci. È sufficiente che riconosca la voce A e la voce B come voci diverse. Se A sia la moderatrice e B il membro del consiglio di amministrazione resta, per questo compito, inizialmente aperto.
Per un'interpretazione simultanea è proprio questa capacità a essere rilevante. Già l'informazione che sta parlando una persona diversa da prima può aiutare a restituire una discussione in modo più comprensibile.
Quando tutti parlano insieme: separazione dei parlanti nel parlato sovrapposto
La situazione diventa particolarmente difficile quando più persone parlano contemporaneamente. In una tavola rotonda vivace succede regolarmente – un breve intervento, una parola di assenso, due risposte che si sovrappongono.
Qui entrano in gioco i metodi di Audio Source Separation. Il loro scopo è separare tra loro segnali vocali diversi che si sovrappongono. Nel migliore dei casi, da un mix si ottengono di nuovo singole voci comprensibili.
La qualità di questi metodi dipende però fortemente dal materiale di partenza e dalle condizioni acustiche. Quanto più chiaramente le singole voci sono contenute nel segnale, tanto meglio si possono distinguere. Ciò che nell'audio è già andato perso non può essere recuperato in modo affidabile nemmeno da una separazione sofisticata.
Che cosa significa per la Sua pianificazione
Per gli organizzatori ciò significa: la domanda su quanto bene un'IA sappia distinguere i parlanti è sempre anche una questione di tecnica audio. Come la microfonazione nei panel getti le basi di ogni interpretazione lo abbiamo descritto in dettaglio nell'articolo Interpretariato con IA e tecnica audio: perché tutto inizia dal microfono. Se sta pianificando un'interpretazione simultanea per una tavola rotonda, conviene concordare l'audio insieme fin dall'inizio.
Voice Cloning: un'interpretazione può preservare la voce?
Un secondo campo di ricerca si spinge ancora oltre. Si occupa della riproduzione sintetica delle voci umane, spesso indicata come Voice Cloning.
La moderna sintesi vocale è in grado di riprendere determinate caratteristiche di una voce e di utilizzarle per nuovi contenuti linguistici. Per l'interpretazione si aprono così nuove possibilità: un oratore potrebbe essere restituito in un'altra lingua, mantenendo in parte le caratteristiche distintive della sua voce.
La parola „in parte“ è scelta consapevolmente. Non si tratta di copiare completamente una persona, ma di fare in modo che l'interpretazione non suoni più come una voce estranea, bensì porti con sé tratti dell'originale.
In combinazione con il riconoscimento del parlante il potenziale diventa evidente: se un sistema riconosce che sta parlando il parlante B e ne mantiene le caratteristiche vocali nella lingua di arrivo, una tavola rotonda interpretata potrebbe essere molto più facile da seguire. Questioni simili si pongono per la resa di intonazione ed espressività – per saperne di più legga il nostro articolo L'IA può tradurre le emozioni?
Possibilità tecniche e questioni etiche
Per quanto la tecnologia sia affascinante: la riproduzione delle voci umane comporta una notevole responsabilità. Una voce è qualcosa di molto personale. Chi la genera sinteticamente si muove in un ambito delicato.
Tre presupposti sono a nostro avviso fondamentali:
- Consenso: la persona la cui voce viene riprodotta deve acconsentire.
- Trasparenza: soprattutto in ambito professionale deve essere chiaro quando viene utilizzata una voce sintetica. Il pubblico dovrebbe sapere che sta ascoltando un'interpretazione e non la persona stessa.
- Protezione dagli abusi: le voci riprodotte non devono essere utilizzate al di fuori dello scopo concordato.
Per aziende, associazioni ed enti pubblici queste questioni non sono astratte. In un'assemblea degli azionisti, in una conferenza specialistica o in una seduta pubblica deve essere sempre chiaro chi ha detto che cosa – e in quale forma ciò viene restituito.
La prospettiva di MILA sul riconoscimento del parlante e sulla preservazione della voce
Per i futuri sistemi di interpretariato con IA, il riconoscimento del parlante e la preservazione della voce sono ambiti di sviluppo importanti. Soprattutto nelle tavole rotonde, un'attribuzione affidabile degli interventi ai singoli parlanti potrebbe migliorare la comprensibilità. Per questo seguiamo queste tecnologie con attenzione.
Il nostro criterio resta lo stesso: l'innovazione tecnica deve creare un reale valore aggiunto per la comunicazione. Per noi una nuova funzione ha senso solo quando aiuta i Suoi ospiti a seguire meglio un evento.
Per il Suo evento oggi puntiamo su ciò che si può pianificare in modo affidabile. L'interpretazione simultanea con IA funziona in locale sulla nostra tecnologia presso la sede dell'evento, senza cloud – ciò che viene detto non lascia l'evento. Termini tecnici e nomi propri del programma li configuriamo in anticipo. Ogni lingua arriva su un proprio canale nell'impianto di interpretazione o nella tecnica congressuale già presente, su richiesta con ricevitori e cuffie per gli ospiti. E un tecnico di sistema è sempre presente sul posto: pianifica con Lei, allestisce, segue l'interpretazione durante l'evento e smonta.
Sta pianificando un congresso, una conferenza o un evento aziendale con tavola rotonda e desidera sapere come realizzare l'interpretazione? Tutti i dettagli su tecnica e svolgimento si trovano nella nostra pagina dedicata ai servizi. Quali formati seguiamo lo mostrano i nostri ambiti di impiego – non esiti a contattarci.
