Blog · 19/08/2026
Speech-to-Speech Translation: come funziona la moderna traduzione vocale con l'IA
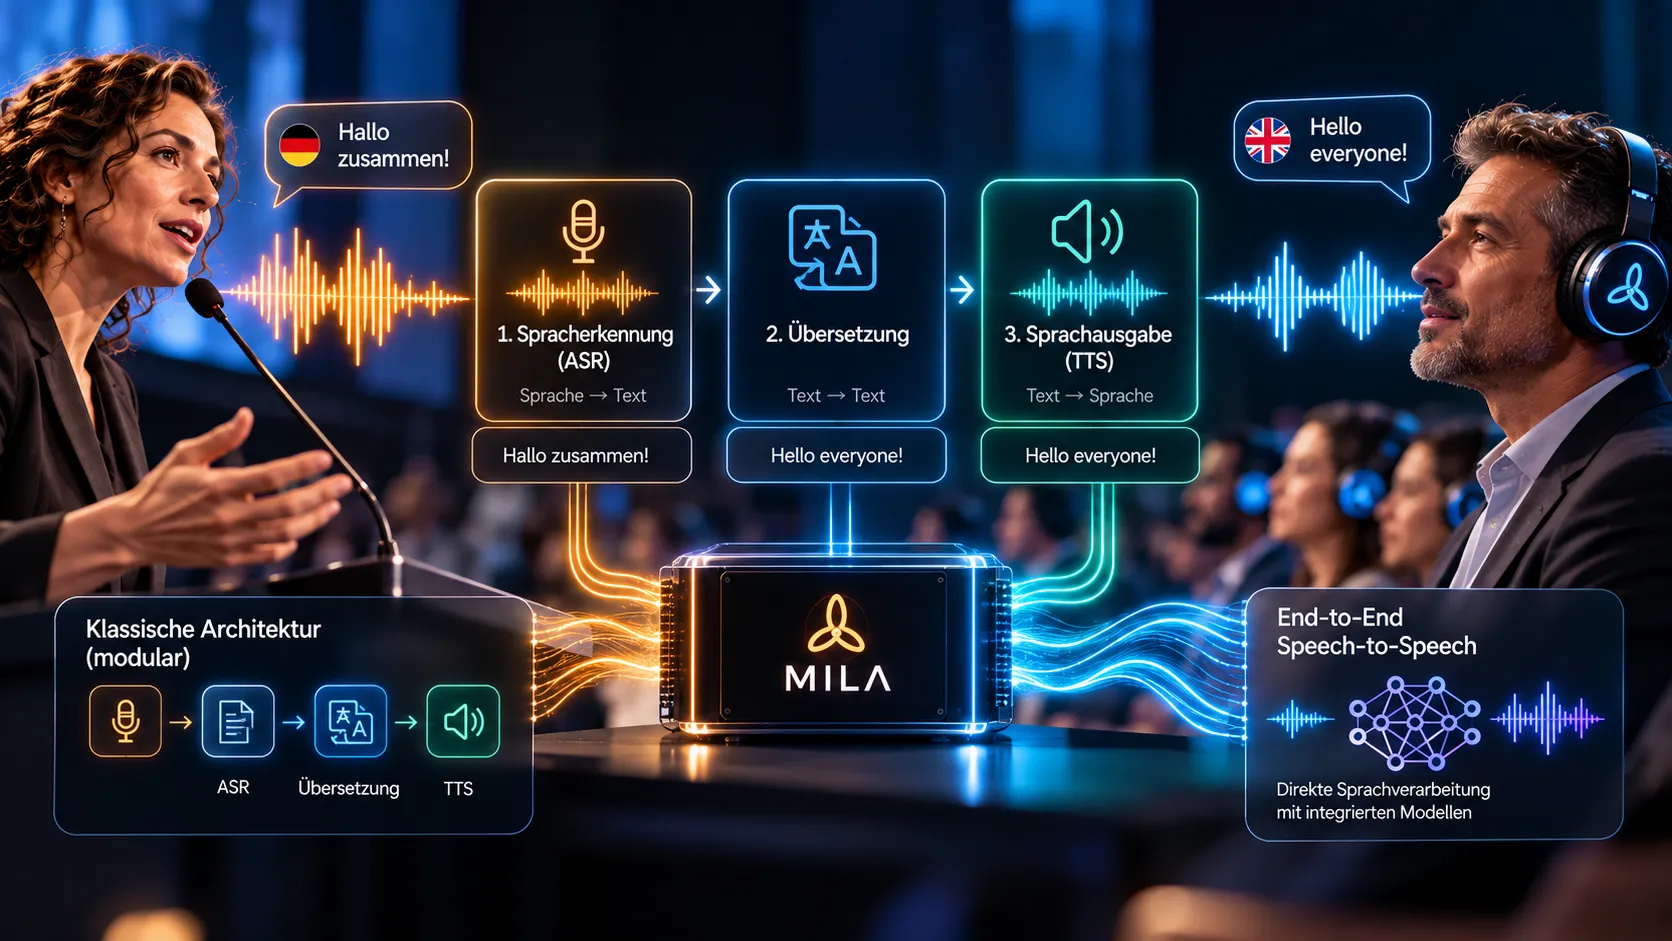
Una relatrice parla in tedesco, in sala gli ospiti seguono l'intervento in cuffia – in inglese, francese o polacco. Ciò che al pubblico appare come un unico processo è, dal punto di vista tecnico, composto da più compiti che devono integrarsi strettamente tra loro. È proprio di questo che si occupa la Speech-to-Speech Translation, la traduzione dal parlato al parlato. In questo articolo spieghiamo come è strutturata la classica catena di elaborazione, dove si trovano i suoi limiti, quali nuove architetture di intelligenza artificiale sta sperimentando la ricerca – e perché queste domande sono rilevanti anche per Lei come organizzatore di eventi.
Tre compiti, un obiettivo
Un sistema professionale di interpretariato con IA deve combinare diversi compiti complessi. Deve:
- riconoscere il parlato,
- tradurre il contenuto nella lingua di destinazione,
- e generare a partire da questo un output vocale comprensibile.
Un interprete simultaneo umano svolge tutto questo in un'unica mente: ascoltare, comprendere, trasporre, parlare. Nell'interpretazione simultanea automatica, invece, questi compiti vengono tradizionalmente suddivisi tra modelli diversi, ciascuno specializzato nella propria parte. In che cosa l'interpretariato con IA e gli interpreti di conferenza umani si differenziano in linea di principio lo approfondiamo nell'articolo Interprete IA o umano: l'interprete simultaneo diventerà superfluo?
La suddivisione su più modelli presenta vantaggi, ma anche limiti tecnici – entrambi meritano uno sguardo più attento.
La classica catena di elaborazione della Speech-to-Speech Translation
Nella sua forma classica, la Speech-to-Speech Translation si svolge in tre fasi consecutive. Il risultato di ciascuna fase costituisce l'input della successiva.
Fase 1: Riconoscimento automatico del parlato (ASR)
All'inizio c'è il riconoscimento automatico del parlato, in breve ASR (Automatic Speech Recognition). Converte il segnale audio – ad esempio quello del microfono sul leggio – in testo. Il parlato diventa parole e frasi.
Fase 2: Traduzione automatica
Successivamente, un modello di traduzione automatica traduce il contenuto riconosciuto nella lingua di destinazione. Lavora con il testo fornito dal riconoscimento del parlato – non con l'audio originale.
Fase 3: Sintesi vocale (Text-to-Speech)
Nella terza fase, un sistema Text-to-Speech, in breve TTS, genera dal testo tradotto l'output vocale. È questa la voce che gli ospiti ascoltano infine in cuffia o tramite l'impianto congressuale.
Il vantaggio: ogni componente può essere migliorato singolarmente
Questa architettura modulare ha un chiaro vantaggio: i singoli componenti possono essere ottimizzati indipendentemente l'uno dall'altro. Se per una delle fasi è disponibile un modello migliore, è possibile impiegarlo senza dover sviluppare di nuovo gli altri elementi. Ogni parte della catena può essere verificata, adattata e sostituita in modo mirato.
Dove si trovano le sfide
Per quanto la catena sia chiara, comporta alcune sfide di fondo.
Ogni fase di elaborazione richiede tempo
Riconoscimento del parlato, traduzione e sintesi vocale si susseguono, e ciascuna di queste fasi richiede tempo. In un'interpretazione simultanea, in cui gli ospiti devono poter seguire il programma il più possibile in tempo reale, si tratta di un fattore centrale.
Gli errori si propagano lungo la catena
Un'altra sfida è meno evidente: gli errori possono essere trasmessi da un componente al successivo. Se il riconoscimento del parlato interpreta male un termine, il modello di traduzione riceve già informazioni errate. Potrebbe quindi tradurre in modo corretto – ma proprio la cosa sbagliata. Alla fine, la sintesi vocale rende questo errore udibile.
Ciò è particolarmente delicato nel caso di termini tecnici e nomi propri, che ricorrono continuamente nei congressi e nelle conferenze specialistiche. Un solo termine riconosciuto in modo errato può dare a una frase un significato diverso. Per questo la prima fase è così importante – e con essa la qualità del segnale in ingresso. Perché l'audio sia determinante lo descriviamo nell'articolo Interpretariato con IA e tecnica audio: perché tutto comincia dal microfono.
End-to-End Speech-to-Speech Translation: la via più diretta
Un campo di ricerca alternativo si occupa di modelli che elaborano le informazioni vocali in modo più diretto. Si parla di End-to-End Speech-to-Speech Translation. Questi sistemi possono ridurre determinate fasi intermedie o collegarle internamente in modo più stretto – invece di stazioni rigorosamente separate, nasce un percorso di elaborazione più integrato.
Che cosa possono preservare i modelli integrati
Il fascino di questo approccio risiede in ciò che può andare perso nella catena classica. Non appena il parlato viene convertito in testo, restano soprattutto le parole. Le caratteristiche della voce, la prosodia – cioè accento, ritmo e intonazione – e parti del contesto linguistico non compaiono nel testo.
Gli approcci integrati aprono nuove possibilità per trasmettere anche queste informazioni. A che punto sia la ricerca, ad esempio nella trasmissione delle emozioni, e dove si trovino i limiti, lo abbiamo riassunto nell'articolo L'IA può tradurre le emozioni?
Nessuna scorciatoia automatica
Tuttavia, i sistemi integrati non sono automaticamente più veloci o più affidabili solo perché hanno meno fasi intermedie separate. Occorre considerare anche la loro controllabilità e adattabilità.
Per l'impiego negli eventi non è un aspetto secondario: chi desidera configurare in anticipo termini tecnici e nomi propri e supervisionare la traduzione durante l'evento ha bisogno di un sistema su cui poter intervenire in modo mirato.
Architettura modulare o integrata?
Entrambi gli approcci presentano vantaggi: i sistemi modulari possono essere sostituiti e ottimizzati componente per componente. I modelli integrati possono preservare informazioni come la prosodia e le caratteristiche della voce, che vanno perse in un'elaborazione intermedia basata sul testo. Quale architettura sia più adatta dipende dai requisiti – non esiste una risposta valida per tutti i casi.
Che cosa significa per il Suo evento
In qualità di organizzatore, agenzia, azienda o associazione, Lei non deve valutare architetture di modelli. Ciò che conta per Lei è che i Suoi ospiti possano seguire il programma nella propria lingua – che si tratti di un congresso, di un'assemblea generale o di una seduta pubblica. Conoscere la catena di elaborazione è comunque utile quando pianifica un servizio di interpretazione simultanea per il Suo evento. Alcuni fattori, infatti, possono essere influenzati in anticipo:
- L'audio: poiché tutto comincia con il riconoscimento del parlato, un segnale microfonico pulito contribuisce a determinare ciò che arriva alle fasi successive.
- Il programma: termini tecnici e nomi propri noti in anticipo possono essere preparati. Da MILA li configuriamo prima dell'evento.
- L'assistenza: un'interpretazione simultanea basata sull'IA non dovrebbe funzionare senza supervisione. Da noi un tecnico di sistema segue la traduzione in loco durante l'evento.
La prospettiva di MILA
Per MILA l'architettura di un sistema linguistico è una decisione tecnica centrale. Ci occupiamo della questione di come coniugare qualità della traduzione, capacità di funzionamento in tempo reale ed elaborazione locale.
L'elaborazione locale è parte integrante della nostra offerta: la nostra interpretazione simultanea con IA funziona in locale sulla nostra tecnologia presso la sede dell'evento, senza cloud. Ciò che viene detto non lascia l'evento.
Consideriamo sia modelli singoli specializzati sia nuovi approcci integrati. La qualità di un sistema di interpretariato con IA, infatti, non nasce da un singolo modello. Nasce dall'interazione dell'intera catena di elaborazione – dal segnale in ingresso alla preparazione delle lingue fino all'assistenza in loco.
Alla fine della catena, ogni lingua arriva su un proprio canale nell'impianto di interpretazione o nell'impianto congressuale esistente; su richiesta mettiamo a disposizione degli ospiti ricevitori e cuffie. Come si presentano nel dettaglio tecnologia, svolgimento e servizi aggiuntivi lo trova nella nostra pagina dedicata ai servizi. Se sta pianificando un evento multilingue, saremo lieti di parlare con Lei di ciò di cui il Suo programma ha bisogno.
