Blog · 11/08/2026
Traduzione simultanea con l'IA: quando la macchina ascolta, traduce e parla
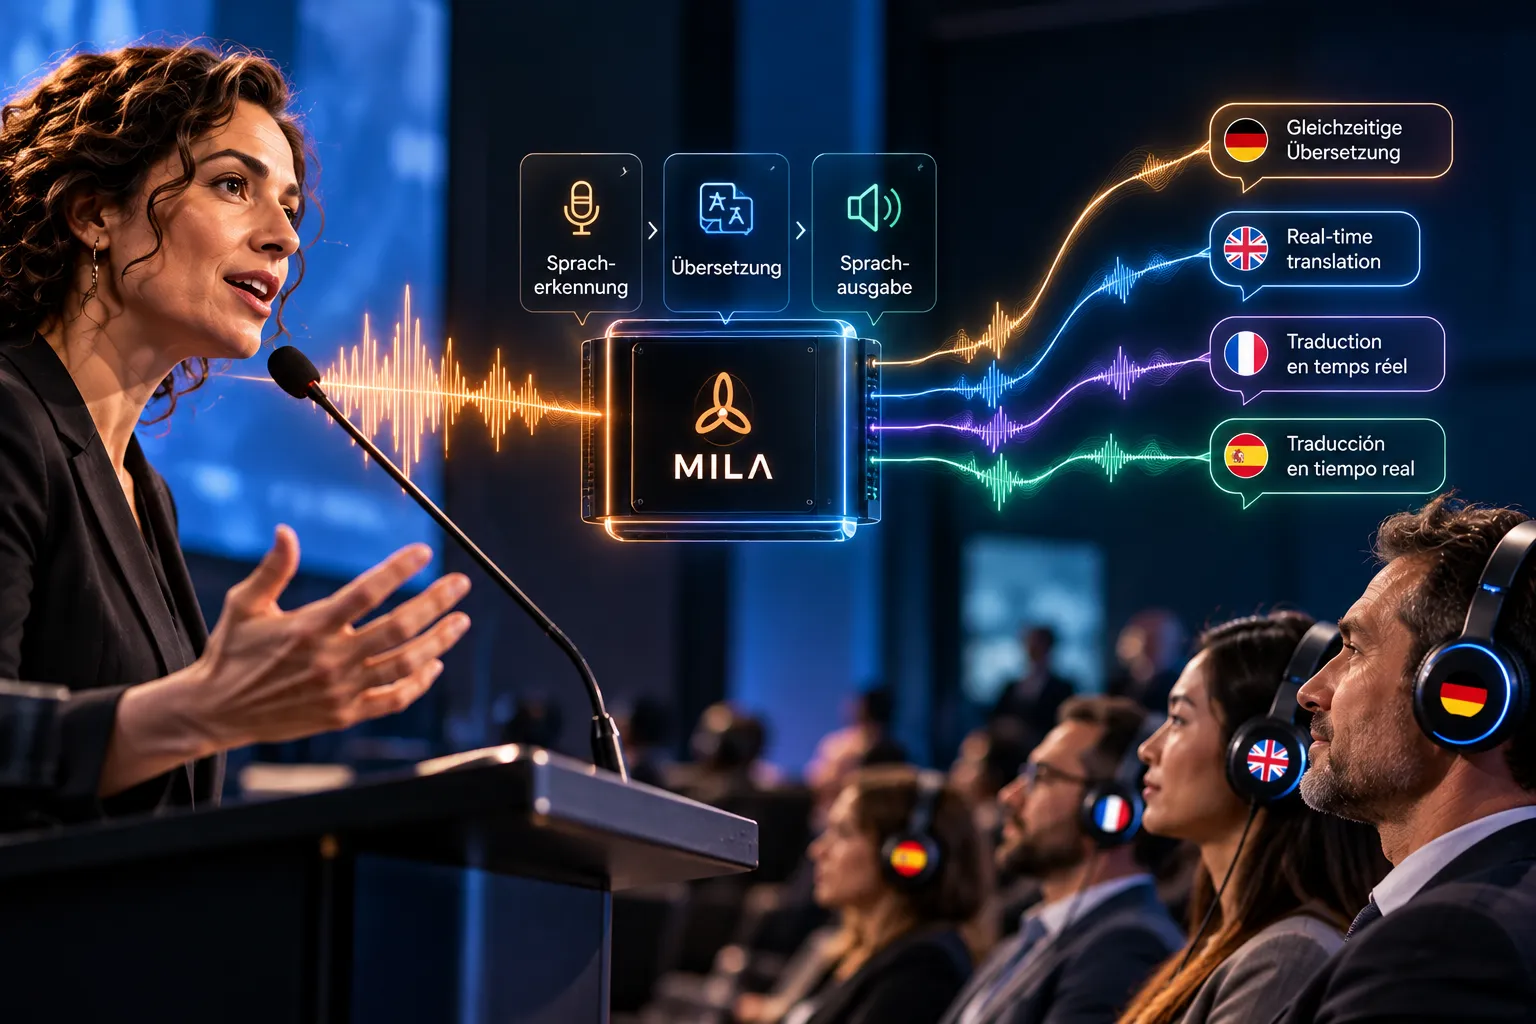
Una relatrice inizia sul palco una lunga frase in tedesco, e il verbo decisivo si trova alla fine. Un interprete simultaneo umano ascolta, inquadra il contenuto e comincia a parlare prima che la frase sia completa. Un interprete basato sull'IA si trova di fronte esattamente allo stesso compito: deve ascoltare, tradurre e parlare contemporaneamente. Il modo in cui lo affronta dipende in larga misura dalla sua architettura. Finora molti sistemi di interpretazione simultanea lavorano in più fasi successive. Nuovi approcci di ricerca cercano di integrare più strettamente questa elaborazione. In questo articolo illustriamo gli approcci principali, i loro vantaggi e svantaggi e perché la questione dell'architettura è rilevante anche per Lei in quanto organizzatore di eventi.
La pipeline classica: ASR, traduzione, sintesi vocale
La struttura consolidata di un sistema di interpretariato con IA è una catena di tre componenti:
- Riconoscimento vocale (ASR, Automatic Speech Recognition): un modello converte la parola parlata in testo.
- Traduzione (Translation): un secondo modello trasferisce questo testo nella lingua di arrivo.
- Sintesi vocale (TTS, Text-to-Speech): una voce artificiale pronuncia la traduzione.
Ogni componente svolge un compito ben definito e trasmette il proprio risultato a quello successivo. Si parla quindi di architettura modulare o di pipeline.
I punti a favore della struttura modulare
Il vantaggio maggiore risiede nella trasparenza. Tra una fase e l'altra si generano risultati che possono essere visualizzati e verificati, primo fra tutti la trascrizione dopo il riconoscimento vocale. Se una parola viene tradotta in modo errato, è possibile ricostruire se era già stata riconosciuta male o se è stata alterata solo durante la traduzione.
Inoltre i componenti possono essere ottimizzati o sostituiti singolarmente. Termini tecnici e nomi propri possono essere inseriti in modo mirato proprio dove servono, ad esempio nel riconoscimento del nome di un prodotto o nella traduzione di un termine specialistico. E quando diventa disponibile un modello migliore per una singola fase, non è necessario ricostruire l'intero sistema.
Dove la pipeline mostra i suoi limiti
La catena presenta anche dei punti deboli. Gli errori si propagano: ciò che il riconoscimento vocale comprende male viene tradotto dalla fase successiva così come è stato riconosciuto, non come era inteso. Inoltre i tempi di elaborazione delle singole fasi si sommano.
Un terzo aspetto riguarda il modo di parlare. Nella conversione in testo, informazioni come l'intonazione, la velocità dell'eloquio o l'ironia vanno facilmente perse. Ciò che non è più presente nel testo non può essere restituito nemmeno dalla sintesi vocale finale. A questo tema abbiamo dedicato un articolo specifico: L'IA può tradurre le emozioni?
End-to-End Speech-to-Speech Translation
È qui che interviene un campo di ricerca che negli ultimi anni ha attirato molta attenzione: la End-to-End Speech-to-Speech Translation. L'idea: un unico modello acquisisce il parlato e genera direttamente il parlato nella lingua di arrivo, senza passare necessariamente attraverso un testo scritto.
Ne derivano possibili vantaggi. Un minor numero di passaggi tra i singoli modelli può accelerare l'elaborazione. E poiché il modello lavora con il suono stesso, c'è la possibilità di trasferire anche caratteristiche del modo di parlare originale.
A questi si contrappongono alcune sfide. Un modello integrato è più difficile da comprendere: se non c'è una fase intermedia visibile, è più difficile ricondurre un errore alla sua causa. Anche il controllo mirato, ad esempio l'impostazione di determinati termini tecnici, non è possibile con la stessa facilità in un modello chiuso come in una pipeline.
Modelli di IA audio-nativi: il suono come fonte di informazione autonoma
Strettamente legati a questo approccio sono i cosiddetti modelli di IA audio-nativi. Elaborano direttamente i segnali audio, invece di lavorare esclusivamente con il testo. In questo modo possono in linea di principio sfruttare informazioni contenute solo nel suono, come pause o accenti.
I confini tra gli approcci diventano sempre più sfumati. Nella ricerca esistono anche forme ibride che combinano elementi di una catena modulare con modelli integrati. La domanda quindi è sempre meno "pipeline o end-to-end?", ma piuttosto: quali parti dell'elaborazione dovrebbero essere strettamente collegate, e dove è utile una fase intermedia visibile e controllabile? Nessuno degli approcci è superiore in assoluto. L'architettura più adatta dipende da ciò che conta di più nel singolo impiego.
Indipendentemente dall'architettura, vale una regola: ogni modello può lavorare solo con il segnale che gli arriva. Perché l'audio è all'origine di ogni traduzione lo può leggere nel nostro articolo Interpretariato con IA e tecnica audio: perché tutto inizia dal microfono.
Streaming: interpretazione simultanea prima che la frase sia finita
Per un'interpretazione simultanea in una conferenza o in un congresso non basta tradurre bene. Il sistema deve farlo anche in modo continuo. Non può aspettare che una relatrice abbia concluso il suo intervento, ma deve elaborare il flusso del discorso in piccole sezioni. Questo principio si chiama elaborazione in streaming.
Ne deriva un compromesso fondamentale:
- Tradurre presto significa un ritardo breve, ma meno contesto. Il sistema potrebbe dover tradurre prima che sia chiaro dove va a parare la frase.
- Ascoltare più a lungo significa più contesto e quindi una base migliore, ma anche una maggiore distanza dall'originale.
L'esempio iniziale mostra perché questo è così impegnativo: in tedesco il verbo si trova spesso alla fine della frase, in molte lingue di arrivo arriva presto. Un sistema in streaming deve quindi decidere quanto a lungo attendere. A ciò si aggiunge che un testo può ancora essere corretto in background, una parola già pronunciata nella lingua di arrivo invece no.
Quali sviluppi sono particolarmente rilevanti per i sistemi in tempo reale
Per l'impiego dal vivo negli eventi, a nostro avviso sono importanti soprattutto quattro sviluppi:
- Modelli compatibili con lo streaming, che gestiscono frasi incomplete e trovano un buon equilibrio tra ritardo e contesto.
- Controllabilità, affinché termini tecnici, nomi di prodotti e nomi propri del programma arrivino in modo affidabile così come sono intesi.
- Monitorabilità, affinché durante l'evento sia sempre riconoscibile cosa il sistema sta riconoscendo e restituendo.
- Efficienza, affinché modelli performanti possano funzionare anche sulla tecnica in loco, invece di dipendere da data center remoti.
Cosa significa l'architettura per il Suo evento
Non ha bisogno di conoscenze specialistiche sui modelli linguistici. L'architettura di un sistema di interpretariato determina però con quanta flessibilità può essere ottimizzato, monitorato e sviluppato. Ed è proprio questo che si nota sul campo: quando il nome del Suo sponsor principale viene reso correttamente, quando un termine tecnico del Suo settore è preciso o quando, in caso di problemi, qualcuno può intervenire rapidamente.
Per questo in MILA non intendiamo l'interpretazione simultanea come un'interfaccia da collegare e basta, ma come l'intera catena di elaborazione, dal microfono alla cuffia. In concreto ciò significa:
- Configuriamo in anticipo i termini tecnici e i nomi propri del Suo programma.
- L'interpretazione simultanea con IA funziona localmente sulla nostra tecnica presso la sede dell'evento, senza cloud. Il parlato non esce dal Suo evento.
- Un tecnico di sistema è sempre presente in loco. Pianifica con Lei, allestisce, segue l'interpretazione durante l'evento e smonta.
- Ogni lingua arriva su un proprio canale nel Suo impianto di interpretazione o nella Sua tecnica congressuale esistente; su richiesta mettiamo a disposizione degli ospiti ricevitori e cuffie.
La ricerca sui sistemi Speech-to-Speech si sviluppa rapidamente e la seguiamo da vicino. Se desidera sapere come può essere organizzata un'interpretazione simultanea per il Suo congresso, la Sua conferenza o il Suo evento aziendale, trova i dettagli su tecnica e svolgimento nella nostra pagina dedicata ai servizi. Le risposte alle domande più frequenti sono raccolte nelle nostre FAQ.
