Blog · 16/10/2026
A cloud não é a única alternativa: porque é que a IA local está de volta
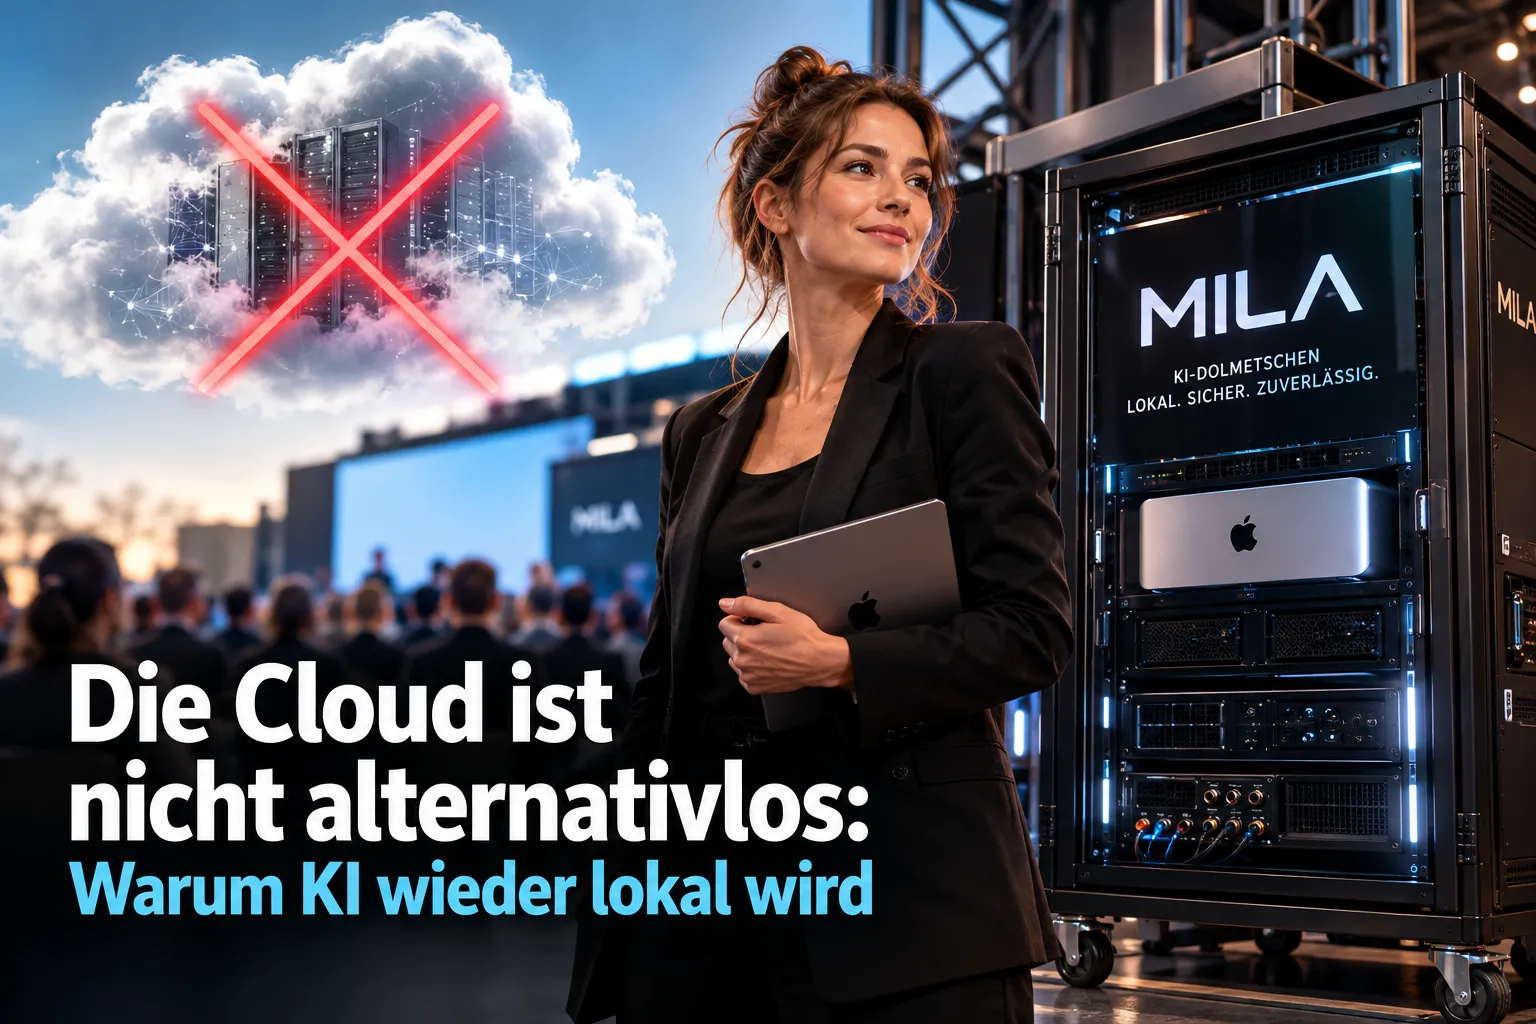
A IA de alto desempenho tem sempre de vir da cloud? Para muitas aplicações, a resposta parece estar decidida há muito: os dados seguem para um grande centro de dados, onde são processados, e o resultado regressa. Mas, em paralelo, ganha importância uma alternativa que, à primeira vista, parece antiquada e que é tecnicamente muito atual: a IA local. Quem planeia uma interpretação simultânea para uma conferência, um congresso ou um evento empresarial deve saber o que está por trás desta abordagem – e onde estão os seus limites. Neste artigo, explicamos o que significa IA local, que vantagens oferece em eventos ao vivo e por que razão apostamos neste caminho na MILA.
Como funciona a IA na cloud
Muitas aplicações de IA baseiam-se em centros de dados centralizados. O princípio é simples: os utilizadores enviam dados para servidores externos, onde ocorre o processamento, e os resultados são depois devolvidos.
Este modelo tem a sua razão de ser. Permite o acesso a grandes capacidades de computação sem que seja necessário operar o hardware adequado. Ao mesmo tempo, cria dependências:
- Ligação: Uma ligação à internet estável é frequentemente um pré-requisito. Se falhar ou oscilar, a aplicação também é afetada.
- Tratamento de dados: É necessário esclarecer onde e como os dados transmitidos são tratados.
- Disponibilidade: Saber se o serviço está acessível no momento decisivo não depende totalmente de nós.
- Controlo: O ambiente técnico em que decorre o processamento é definido por um fornecedor externo.
Para muitas aplicações do dia a dia, estes pontos são aceitáveis. Em aplicações críticas em termos de tempo, que têm de funcionar ao vivo, as contas são outras.
O que significa IA local?
Na IA local, os modelos são executados diretamente em hardware próprio – e não num centro de dados remoto. O processamento ocorre, por exemplo, em workstations, em computadores especializados ou em sistemas compactos.
Para esta abordagem, usam-se habitualmente dois termos:
- IA on-premise sublinha que a IA é operada «no local», ou seja, no próprio ambiente técnico.
- Edge AI descreve o processamento na «periferia» da rede – onde os dados são gerados, em vez de numa cloud central.
Em ambos os casos, o princípio de base é o mesmo: os dados são processados onde surgem. Sobretudo quando os resultados são necessários no mesmo instante, isso pode fazer uma diferença decisiva.
IA local em eventos ao vivo: o que ganham os organizadores
Um evento ao vivo mostra bem por que razão isto é importante. Um discurso não é repetido porque a tradução parou por um momento. O que não é transmitido nesse instante perde-se para os convidados.
Menor dependência da ligação à internet
Numa conferência internacional, a tradução da fala não deve, tanto quanto possível, depender de uma ligação à internet instável. Quem já acompanhou um evento num espaço muito concorrido conhece a situação: muitos dispositivos partilham a mesma rede e a ligação nem sempre é tão estável como deveria.
Os sistemas locais podem reduzir esta dependência. Se o processamento da fala decorre em hardware no local do evento, a palavra falada não tem de fazer primeiro o percurso até um centro de dados e de volta antes de a tradução chegar aos convidados.
Conteúdos confidenciais num ambiente controlado
A segunda vantagem diz respeito ao tratamento do que é dito. Com IA local, também conversas confidenciais podem ser processadas num ambiente técnico controlado. Para empresas, associações e entidades públicas, este pode ser um argumento importante – por exemplo, em eventos empresariais ou reuniões em que se abordam conteúdos que não devem sair para o exterior.
Local não significa automaticamente conforme ao RGPD
Precisamente no tema dos intérpretes de IA e da proteção de dados, é importante fazer um enquadramento: um sistema local não é automaticamente totalmente seguro nem conforme ao RGPD. A proteção de dados depende ainda de medidas técnicas de segurança, de processos organizacionais e do tratamento concreto dos dados.
O processamento local cria, portanto, um bom ponto de partida, mas não substitui um esclarecimento cuidadoso caso a caso. Quem planeia um evento com conteúdos sensíveis deve discutir estas questões atempadamente com o prestador de serviços.
O preço técnico da independência
O processamento local coloca, no entanto, exigências elevadas à tecnologia. O que na cloud é feito por um grande centro de dados tem, no processamento local, de ser assegurado pelo hardware no local.
Os modelos de linguagem precisam de memória, capacidade de computação e processamento eficiente. Torna-se especialmente exigente quando várias línguas têm de ser processadas em simultâneo e em tempo real – exatamente o que se pede numa conferência multilingue.
Por isso, três áreas de desenvolvimento são particularmente relevantes para a IA local:
- Compressão de modelos: Os modelos são reduzidos de forma a precisarem de menos recursos, perdendo o mínimo possível de desempenho.
- Quantização: Os valores numéricos internos de um modelo são armazenados com menor precisão. Isto reduz as necessidades de memória e acelera o cálculo.
- Hardware especializado: Computadores concebidos para cálculos de IA facilitam o processamento no local.
A perspetiva da MILA: interpretação simultânea sem cloud
A MILA segue uma abordagem de arquitetura local. A nossa interpretação simultânea por IA funciona com o nosso próprio equipamento, diretamente no local do evento – sem cloud. O que é dito não sai do evento.
Assim, podemos controlar o ambiente técnico e evitar a dependência do processamento de fala baseado na cloud. Para si, enquanto organizador, isto significa: a interpretação não depende de um serviço externo estar acessível no momento decisivo.
Quem procura um intérprete para eventos normalmente não precisa de um software que tenha de operar por conta própria, mas sim de um serviço. Por isso, a IA local é, para nós, parte de um pacote completo:
- Técnico de sistemas no local: Um técnico de sistemas planeia consigo, faz a montagem, acompanha a interpretação durante o evento e faz a desmontagem.
- Canais próprios: Cada língua entra num canal próprio no sistema de interpretação ou no equipamento de conferência existente. Se desejar, disponibilizamos recetores e auscultadores para os convidados.
- Preparação das línguas: Configuramos previamente os termos técnicos e os nomes próprios do programa.
Tão importante como a capacidade de computação é, aliás, o sinal de entrada. Pode ler por que razão uma boa microfonia é a base de qualquer interpretação no nosso artigo Interpretação por IA e tecnologia áudio: porque tudo começa no microfone.
Não é um retrocesso, mas uma questão de arquitetura
Para nós, a IA local não é um regresso nostálgico ao servidor próprio. É uma decisão de arquitetura deliberada para aplicações profissionais em tempo real – e um evento ao vivo com convidados internacionais é exatamente uma aplicação desse tipo.
A cloud continua a fazer sentido para muitos fins. Mas onde contam a disponibilidade, o controlo sobre o ambiente técnico e o tratamento da palavra falada, vale a pena considerar a alternativa local.
Se quiser saber como pode ser uma interpretação simultânea com funcionamento local para a sua conferência, o seu congresso ou o seu evento empresarial, encontra todos os detalhes sobre tecnologia e processo na nossa página de Serviços. Reunimos respostas a perguntas frequentes nas nossas Perguntas frequentes sobre interpretação – e, para um projeto concreto, teremos todo o gosto em falar diretamente consigo.
