Blog · 11/08/2026
Interpretação simultânea com IA: quando a máquina ouve, traduz e fala
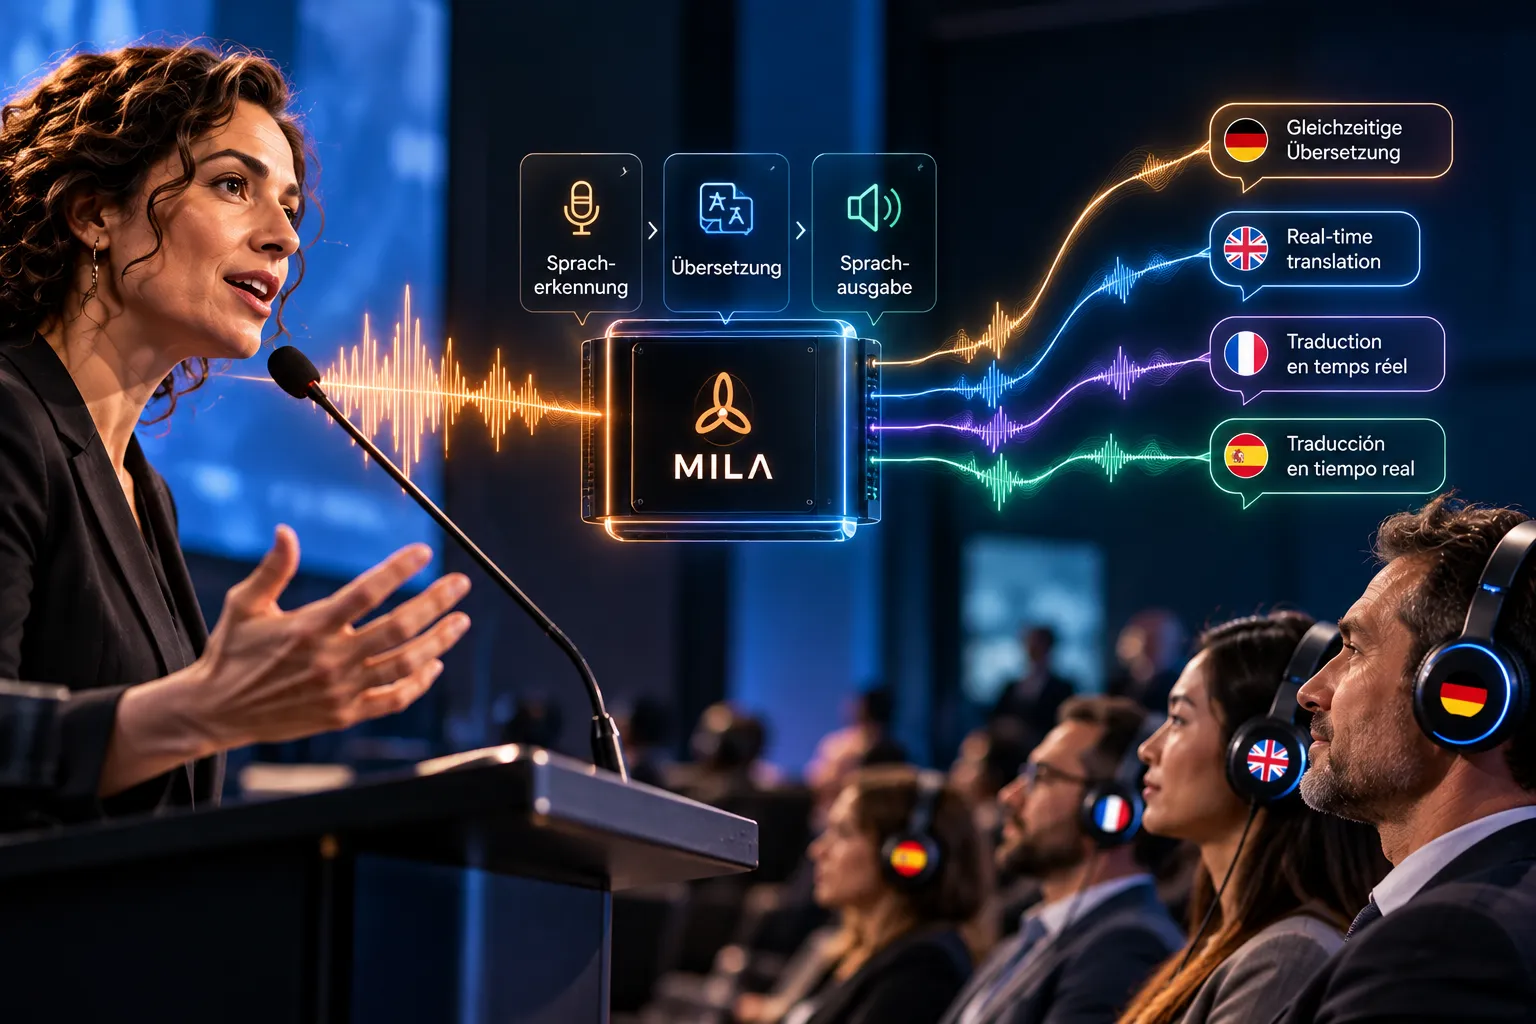
Uma oradora começa, no palco, uma longa frase em alemão, e o verbo decisivo surge apenas no fim. Um intérprete simultâneo humano ouve, contextualiza e começa a falar antes de a frase estar completa. Um intérprete de IA enfrenta exatamente a mesma tarefa: tem de ouvir, traduzir e falar ao mesmo tempo. A forma como o consegue depende muito da sua arquitetura. Até agora, muitos sistemas de interpretação simultânea funcionam em várias etapas sucessivas. Novas abordagens de investigação procuram ligar este processamento de forma mais estreita. Neste artigo, explicamos as principais abordagens, as suas vantagens e desvantagens e por que razão a questão da arquitetura é também relevante para si, enquanto organizador de eventos.
O pipeline clássico: ASR, tradução, síntese de voz
A estrutura comprovada de um sistema de interpretação com IA é uma cadeia de três componentes:
- Reconhecimento de voz (ASR, Automatic Speech Recognition): Um modelo converte a palavra falada em texto.
- Tradução (Translation): Um segundo modelo transpõe esse texto para a língua de chegada.
- Síntese de voz (TTS, Text-to-Speech): Uma voz artificial lê a tradução em voz alta.
Cada componente executa uma tarefa claramente delimitada e passa o seu resultado ao seguinte. Fala-se, por isso, de uma arquitetura modular ou de um pipeline.
O que favorece a estrutura modular
A maior vantagem reside na transparência. Entre as etapas surgem resultados que podem ser consultados e verificados, sobretudo a transcrição após o reconhecimento de voz. Se uma palavra for mal traduzida, é possível perceber se já foi mal reconhecida ou se só foi alterada na tradução.
Além disso, os componentes podem ser otimizados ou substituídos individualmente. Termos técnicos e nomes próprios podem ser introduzidos de forma direcionada onde são necessários, por exemplo no reconhecimento de um nome de produto ou na tradução de um termo técnico. E quando fica disponível um modelo melhor para uma das etapas, não é necessário reconstruir todo o sistema.
Onde o pipeline encontra os seus limites
A cadeia também tem pontos fracos. Os erros propagam-se: aquilo que o reconhecimento de voz entende mal é traduzido pela etapa seguinte tal como foi reconhecido, e não como foi pretendido. Além disso, os tempos de processamento das várias etapas somam-se.
Um terceiro ponto diz respeito à forma de falar. Na conversão em texto, informações como a entoação, o ritmo da fala ou a ironia perdem-se facilmente. O que já não consta do texto também não pode ser reproduzido pela síntese de voz no final. Dedicámos a este tema um artigo próprio: A IA consegue traduzir emoções?
End-to-End Speech-to-Speech Translation
É aqui que entra uma área de investigação que tem ganhado muita atenção nos últimos anos: a End-to-End Speech-to-Speech Translation. A ideia: um único modelo recebe a fala e gera diretamente fala na língua de chegada, sem passar obrigatoriamente por um texto escrito.
Daqui resultam possíveis vantagens. Menos passagens entre modelos individuais podem acelerar o processamento. E, como o modelo trabalha com o próprio som, existe a possibilidade de transmitir também características da forma de falar original.
Em contrapartida, há desafios. Um modelo integrado é mais difícil de compreender: se não existe uma etapa intermédia visível, torna-se mais difícil atribuir um erro a uma causa. Também o controlo direcionado, por exemplo a definição de determinados termos técnicos, não é tão facilmente possível num modelo fechado como num pipeline.
Modelos de IA nativos de áudio: o som como fonte de informação própria
Estreitamente relacionados com esta abordagem estão os chamados modelos de IA nativos de áudio. Processam diretamente sinais de áudio, em vez de trabalharem exclusivamente com texto. Assim, podem, em princípio, aproveitar informações que só estão presentes no som, como pausas ou ênfases.
As fronteiras entre as abordagens tornam-se cada vez mais ténues. Na investigação existem também formas mistas, que combinam elementos de uma cadeia modular com modelos integrados. Por isso, a pergunta é cada vez menos «Pipeline ou End-to-End?» e mais: que partes do processamento devem estar estreitamente ligadas e onde faz sentido uma etapa intermédia visível e controlável? Nenhuma das abordagens é, de forma geral, superior. A arquitetura mais adequada depende do que é mais importante em cada utilização.
Independentemente da arquitetura, aplica-se o seguinte: cada modelo só pode trabalhar com o sinal que lhe chega. Pode ler por que razão o som está no início de qualquer tradução no nosso artigo Interpretação com IA e tecnologia de áudio: porque tudo começa no microfone.
Streaming: interpretação simultânea antes de a frase terminar
Para uma interpretação simultânea numa conferência ou num congresso, não basta traduzir bem. O sistema tem também de o fazer de forma contínua. Não pode esperar que uma oradora termine a sua intervenção; tem de processar o discurso em pequenos segmentos. Este princípio chama-se processamento em streaming.
Daqui resulta uma ponderação fundamental:
- Traduzir cedo significa um atraso curto, mas menos contexto. O sistema poderá ter de traduzir antes de ser claro para onde a frase se encaminha.
- Ouvir durante mais tempo significa mais contexto e, portanto, uma base melhor, mas também maior distância em relação ao original.
O exemplo do início mostra por que razão isto é tão exigente: em alemão, o verbo surge muitas vezes no fim da frase, enquanto em muitas línguas de chegada surge cedo. Um sistema de streaming tem, portanto, de decidir quanto tempo aguarda. Acresce que o texto ainda pode ser corrigido em segundo plano, mas uma palavra já pronunciada na língua de chegada não.
Que desenvolvimentos são particularmente relevantes para sistemas em tempo real
Para a utilização ao vivo em eventos, consideramos que há sobretudo quatro desenvolvimentos importantes:
- Modelos com capacidade de streaming, que lidam com frases incompletas e encontram um bom equilíbrio entre atraso e contexto.
- Controlabilidade, para que termos técnicos, nomes de produtos e nomes próprios do programa cheguem de forma fiável tal como são pretendidos.
- Monitorização, para que, durante o evento, seja sempre possível ver o que o sistema está a reconhecer e a emitir.
- Eficiência, para que modelos de alto desempenho possam funcionar também com equipamento no local, em vez de dependerem de centros de dados remotos.
O que a arquitetura significa para o seu evento
Não precisa de conhecimentos técnicos sobre modelos de linguagem. No entanto, a arquitetura de um sistema de interpretação determina a flexibilidade com que pode ser otimizado, monitorizado e desenvolvido. E é precisamente isso que nota na prática: quando o nome do seu patrocinador principal é transmitido corretamente, quando um termo técnico do seu setor está certo ou quando, perante um problema, alguém pode intervir rapidamente.
Por isso, na MILA, não entendemos a interpretação simultânea como uma interface que basta ligar, mas como toda a cadeia de processamento, do microfone aos auscultadores. Concretamente, isto significa:
- Configuramos previamente os termos técnicos e nomes próprios do seu programa.
- A interpretação simultânea com IA funciona localmente no nosso próprio equipamento no local do evento, sem cloud. O que é dito não sai do seu evento.
- Está sempre presente um técnico de sistemas no local. Planeia consigo, faz a montagem, acompanha a interpretação durante o evento e faz a desmontagem.
- Cada língua chega num canal próprio ao seu sistema de interpretação ou equipamento de conferência existente; se o desejar, disponibilizamos recetores e auscultadores para os convidados.
A investigação sobre sistemas Speech-to-Speech evolui rapidamente e acompanhamo-la de perto. Se quiser saber como pode ser uma interpretação simultânea para o seu congresso, a sua conferência ou o seu evento empresarial, encontra detalhes sobre a tecnologia e o processo na nossa página de Serviços. Reunimos respostas a perguntas frequentes nas nossas FAQ.
