Blog · 19/08/2026
Speech-to-Speech Translation: como funciona a tradução de voz moderna com IA
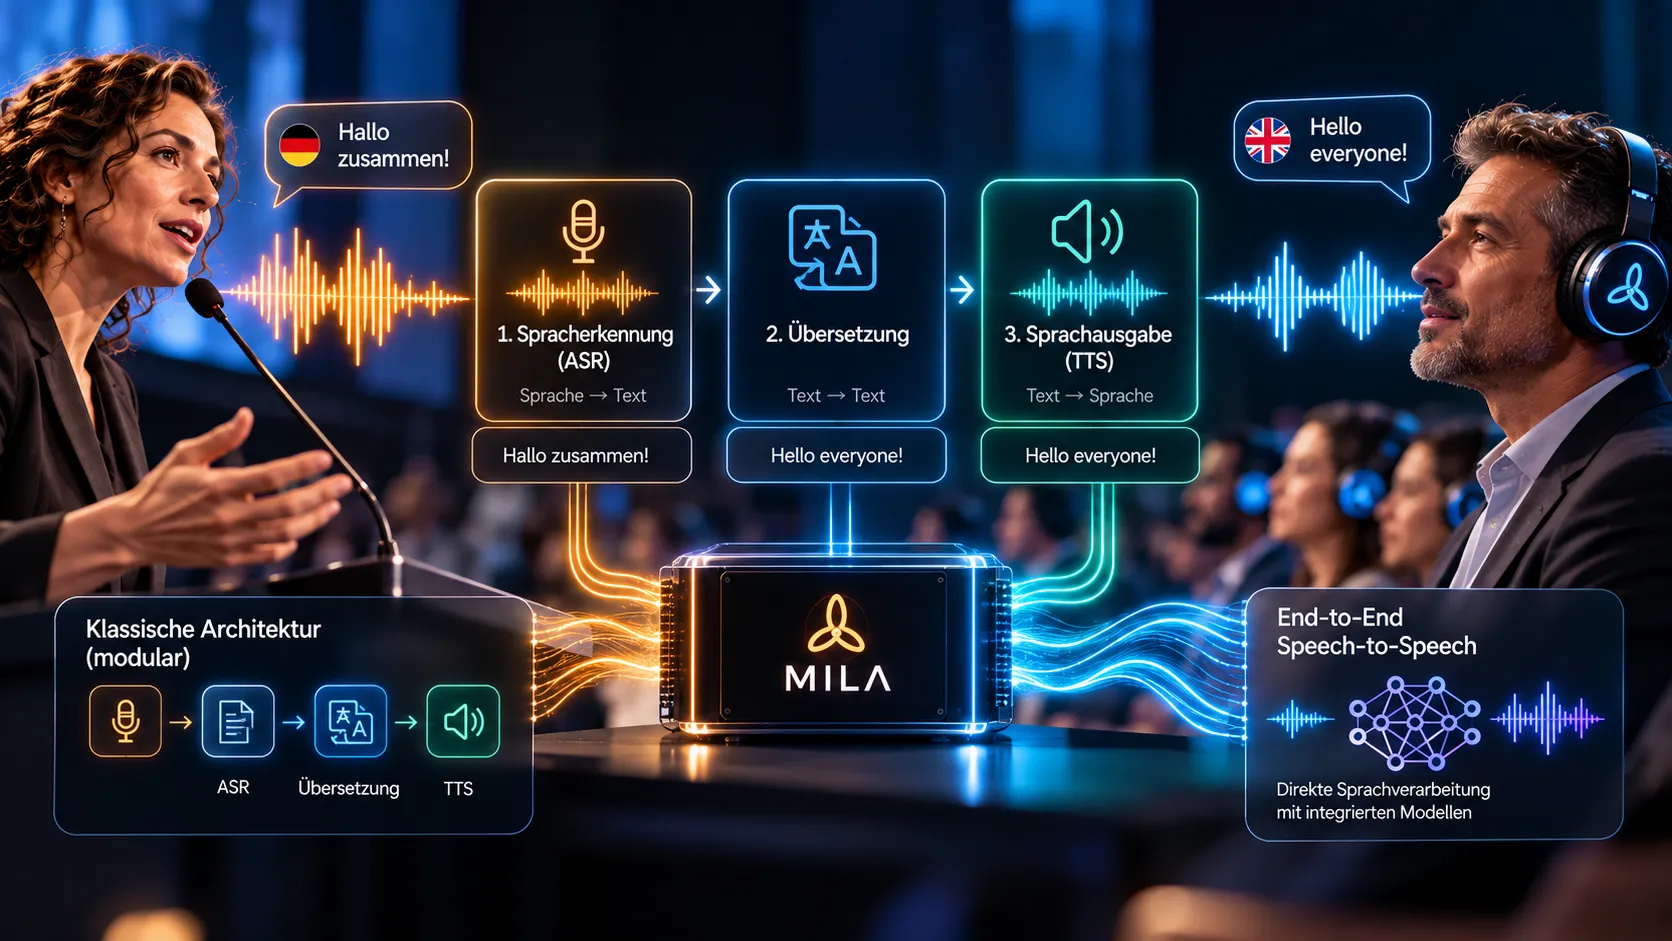
Uma oradora fala em alemão; na sala, os convidados acompanham a apresentação através de auscultadores – em inglês, francês ou polaco. O que para o público parece um único processo consiste, do ponto de vista técnico, em várias tarefas que têm de se articular estreitamente. É precisamente disso que trata a Speech-to-Speech Translation, a tradução de linguagem falada para linguagem falada. Neste artigo, explicamos como está estruturada a cadeia de processamento clássica, onde residem os seus limites, que novas arquiteturas de IA a investigação está a testar – e por que razão estas questões também são relevantes para si enquanto organizador.
Três tarefas, um objetivo
Um sistema profissional de interpretação com IA tem de combinar várias tarefas complexas. Tem de:
- reconhecer a linguagem falada,
- traduzir o conteúdo para a língua de destino,
- e gerar, a partir daí, uma saída de voz compreensível.
Um intérprete simultâneo humano faz tudo isto numa só cabeça: ouvir, compreender, transpor, falar. Numa interpretação simultânea automática, estas tarefas são tradicionalmente distribuídas por diferentes modelos, cada um especializado na sua parte. As diferenças fundamentais entre a interpretação com IA e os intérpretes de conferência humanos são analisadas no artigo Intérprete com IA ou humano: o intérprete simultâneo vai tornar-se dispensável?
A distribuição por vários modelos tem vantagens, mas também limites técnicos – ambos merecem uma análise mais atenta.
A cadeia de processamento clássica da Speech-to-Speech Translation
Na sua forma clássica, a Speech-to-Speech Translation decorre em três etapas sucessivas. O resultado de cada etapa é a entrada da seguinte.
Etapa 1: Reconhecimento automático de fala (ASR)
No início está o reconhecimento automático de fala, abreviado ASR (Automatic Speech Recognition). Converte o sinal de áudio – por exemplo, do microfone no púlpito – em texto. O que é dito transforma-se em palavras e frases.
Etapa 2: Tradução automática
Em seguida, um modelo de tradução automática traduz o conteúdo reconhecido para a língua de destino. Trabalha com o texto fornecido pelo reconhecimento de fala – e não com o som original.
Etapa 3: Síntese de voz (Text-to-Speech)
Na terceira etapa, um sistema Text-to-Speech, abreviado TTS, gera a saída falada a partir do texto traduzido. É esta voz que os convidados ouvem, por fim, nos auscultadores ou através do equipamento de conferência.
A vantagem: cada componente pode ser melhorado individualmente
Esta arquitetura modular tem uma vantagem clara: os componentes individuais podem ser otimizados de forma independente uns dos outros. Quando existe um modelo melhor para uma das etapas, este pode ser utilizado sem que os restantes módulos tenham de ser desenvolvidos de novo. Cada parte da cadeia pode ser verificada, ajustada e substituída de forma específica.
Onde residem os desafios
Por mais clara que seja a cadeia, traz consigo desafios fundamentais.
Cada etapa de processamento requer tempo
O reconhecimento de fala, a tradução e a síntese de voz decorrem uns após os outros, e cada uma destas etapas requer tempo. Numa interpretação simultânea, em que os convidados devem acompanhar o programa com o menor desfasamento possível, este é um fator central.
Os erros propagam-se ao longo da cadeia
Outro desafio é menos evidente: os erros podem passar de um componente para o seguinte. Se o reconhecimento de fala interpretar mal um termo, o modelo de tradução já recebe informação errada. Poderá então traduzir corretamente – mas precisamente aquilo que está errado. No final, a síntese de voz reproduz esse erro de forma audível.
Isto é particularmente delicado no caso de termos técnicos e nomes próprios, que surgem constantemente em congressos e conferências especializadas. Um único termo mal reconhecido pode dar a uma frase um significado diferente. É por isso que a primeira etapa é tão importante – e, com ela, a qualidade do sinal de entrada. Explicamos por que razão o som é decisivo no artigo Interpretação com IA e técnica de áudio: porque tudo começa no microfone.
End-to-End Speech-to-Speech Translation: o caminho mais direto
Uma área de investigação alternativa dedica-se a modelos que processam a informação da fala de forma mais direta. Fala-se de End-to-End Speech-to-Speech Translation. Estes sistemas podem reduzir determinadas etapas intermédias ou ligá-las internamente de forma mais estreita – em vez de estações rigorosamente separadas, surge um percurso de processamento mais integrado.
O que os modelos integrados podem preservar
O interesse desta abordagem reside naquilo que se pode perder na cadeia clássica. Assim que a linguagem falada é convertida em texto, restam sobretudo as palavras. As características da voz, a prosódia – ou seja, a acentuação, o ritmo e a entoação – bem como partes do contexto linguístico não ficam no texto.
As abordagens integradas abrem novas possibilidades para transmitir também este tipo de informação. Resumimos o estado da investigação, por exemplo, na transmissão de emoções, e quais são os seus limites, no artigo A IA consegue traduzir emoções?
Nenhum atalho automático
No entanto, os sistemas integrados não são automaticamente mais rápidos nem mais fiáveis apenas por terem menos etapas intermédias separadas. A sua controlabilidade e capacidade de adaptação também têm de ser tidas em conta.
Para a utilização em eventos, isto não é um pormenor: quem pretende configurar previamente termos técnicos e nomes próprios e acompanhar a tradução durante o evento precisa de um sistema no qual seja possível intervir de forma específica.
Arquitetura modular ou integrada?
Ambas as abordagens têm vantagens: os sistemas modulares podem ser substituídos e otimizados módulo a módulo. Os modelos integrados podem preservar informações como a prosódia e as características da voz, que se perdem num processamento intermédio baseado em texto. Qual a arquitetura mais adequada depende dos requisitos – não existe uma resposta universal.
O que isto significa para o seu evento
Enquanto organizador, agência, empresa ou associação, não tem de avaliar arquiteturas de modelos. O que conta para si é que os seus convidados possam acompanhar o programa na sua língua – seja num congresso, numa assembleia geral ou numa sessão pública. Ainda assim, conhecer a cadeia de processamento ajuda quando planeia uma interpretação simultânea para o seu evento. Isto porque alguns fatores podem ser influenciados antecipadamente:
- O som: Como tudo começa com o reconhecimento de fala, um sinal de microfone limpo contribui para determinar o que chega às etapas seguintes.
- O programa: Os termos técnicos e nomes próprios conhecidos antecipadamente podem ser preparados. Na MILA, configuramo-los antes do evento.
- O acompanhamento: Uma interpretação simultânea apoiada por IA não deve funcionar sem supervisão. Connosco, um técnico de sistemas acompanha a tradução no local durante o evento.
A perspetiva da MILA
Para a MILA, a arquitetura de um sistema de linguagem é uma decisão técnica central. Dedicamo-nos à questão de como conciliar qualidade de tradução, capacidade de funcionamento em tempo real e processamento local.
O processamento local é parte integrante da nossa oferta: a nossa interpretação simultânea com IA funciona localmente, no nosso próprio equipamento no local do evento, sem cloud. O que é dito não sai do evento.
Nesse contexto, analisamos tanto modelos individuais especializados como novas abordagens integradas. Isto porque a qualidade de um sistema de interpretação com IA não resulta de um único modelo. Resulta da interação de toda a cadeia de processamento – desde o sinal de entrada, passando pela preparação das línguas, até ao acompanhamento no local.
No final da cadeia, cada língua chega num canal próprio ao sistema de interpretação ou equipamento de conferência existente; se assim o desejar, disponibilizamos recetores e auscultadores para os convidados. Pode consultar em detalhe o equipamento, o processo e os serviços adicionais na nossa página de Serviços. Se está a planear um evento multilingue, teremos todo o gosto em falar consigo sobre aquilo de que o seu programa necessita.
