Blog · 14/08/2026
Modelli linguistici piccoli: perché nell'interpretariato più piccolo può essere meglio
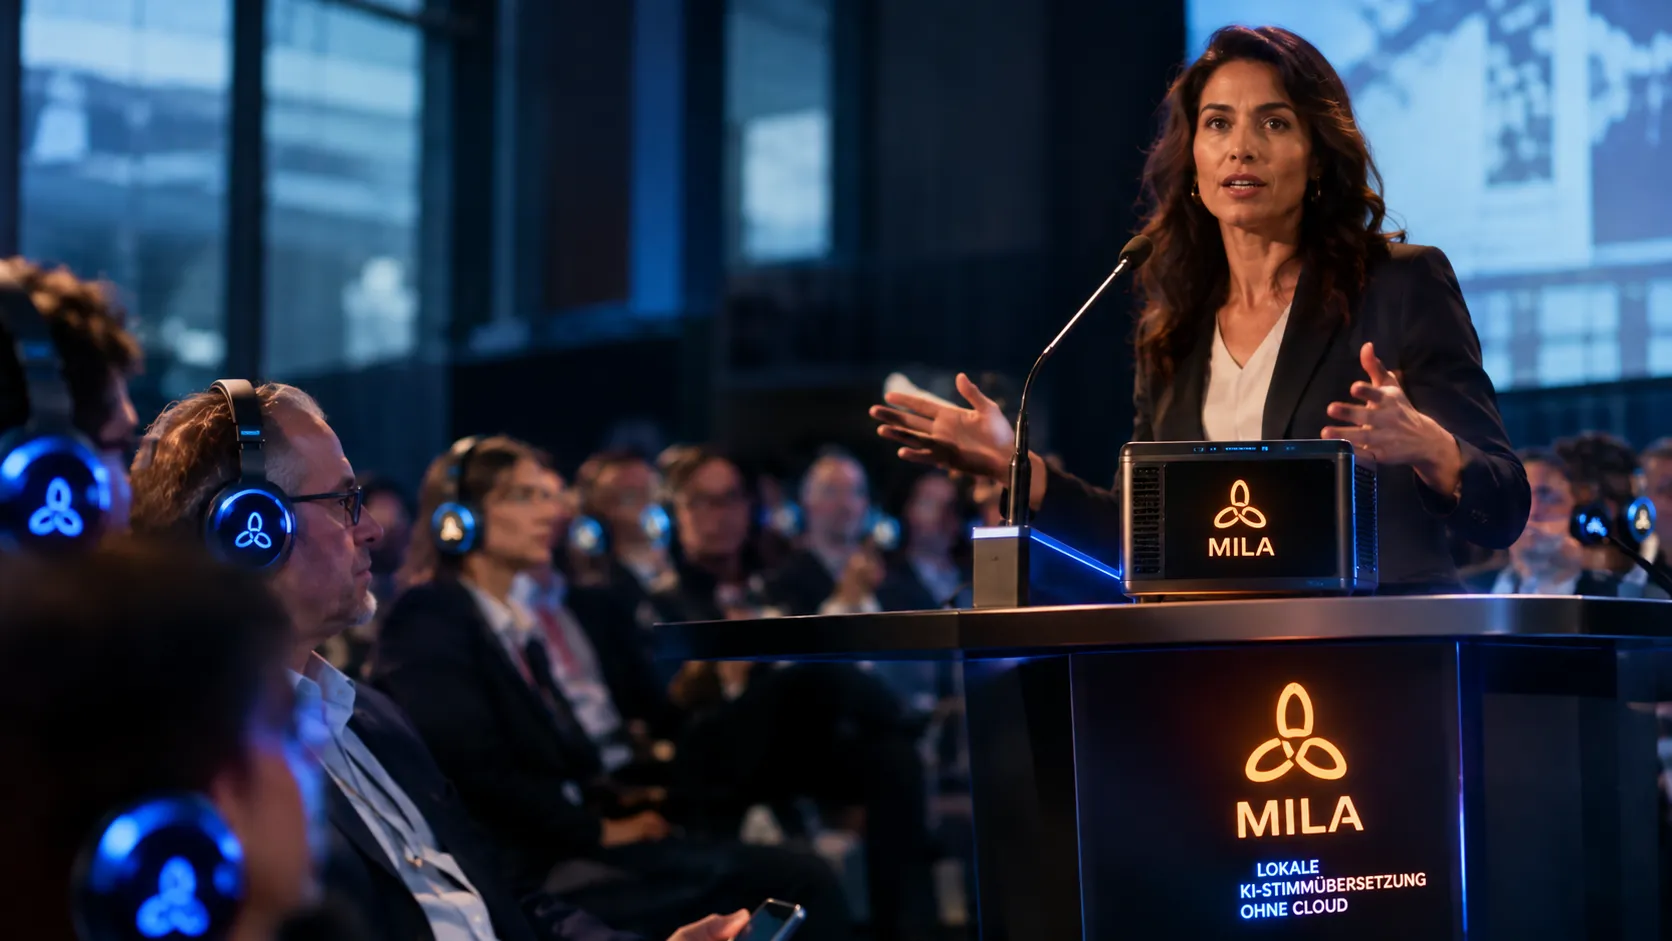
Quando si parla di intelligenza artificiale, si parla spesso di superlativi: sempre più parametri, sempre più dati di addestramento, sempre più potenza di calcolo. Questa strada ha reso possibili progressi impressionanti. Per l'interpretazione simultanea durante gli eventi, tuttavia, si pone una domanda diversa e molto pratica: quanta potenza di IA serve davvero? È proprio qui che entrano in gioco i modelli linguistici di piccole dimensioni. In questo articolo spieghiamo perché i modelli specializzati e ottimizzati in modo mirato sono interessanti per i sistemi di interpretariato, quali tecniche ci sono dietro – e dove si trovano i limiti.
Più grande non significa automaticamente migliore
Lo sviluppo dell'intelligenza artificiale è stato a lungo segnato da un'idea semplice: più parametri, più dati di addestramento e più potenza di calcolo portano a modelli più performanti. Questa relazione non è sbagliata – ha dato origine a molte delle capacità che oggi sembrano quasi scontate.
Per molte applicazioni pratiche, però, non basta. Chi utilizza una tecnologia nella quotidianità non si chiede soltanto che cosa un modello sia in grado di fare in linea di principio. Ciò che conta è se svolge un determinato compito in modo affidabile – nelle condizioni effettivamente presenti. In un evento questo significa: con la tecnica disponibile in loco e mentre il programma è in corso.
Specializzazione anziché dimensioni massime
Un modello linguistico universale è un generalista. Deve programmare, scrivere testi, risolvere problemi matematici e rispondere a domande su qualsiasi argomento. Questa ampiezza ha un prezzo: un modello che deve saper fare tutto deve riunire in sé moltissime capacità.
Un modello per il riconoscimento vocale o per la traduzione ha invece un compito ben definito. Deve riconoscere la lingua parlata oppure trasporre una frase da una lingua all'altra. Codice di programmazione o problemi matematici non rientrano nel suo ambito. Un modello specializzato di questo tipo non necessita quindi per forza della stessa ampiezza di capacità di un modello tuttofare.
Grazie a un'ottimizzazione mirata, i modelli più piccoli possono essere molto performanti per determinati compiti. Un paragone dall'officina: per una certa vite non serve l'intero assortimento, ma la chiave giusta.
Come i modelli linguistici di piccole dimensioni diventano più efficienti
Per rendere i modelli più snelli esistono diversi procedimenti. Due di questi svolgono un ruolo particolarmente importante nello sviluppo attuale: la quantizzazione e la Knowledge Distillation.
Quantizzazione: meno precisione, meno memoria
Un modello linguistico è costituito essenzialmente da moltissimi valori numerici, i cosiddetti pesi del modello. Con la quantizzazione questi pesi vengono memorizzati ed elaborati con una precisione numerica inferiore – in parole semplici: con numeri a gradazione più grossolana invece che con valori a risoluzione molto fine.
Ciò può ridurre notevolmente il fabbisogno di memoria di un modello e abbassare così i requisiti hardware.
Il metodo ha però un rovescio della medaglia. A seconda del procedimento e del modello, una parte della precisione può andare persa. Quanto sia grande questa perdita non si può dire in modo generale. Per questo vale la regola: dopo ogni ottimizzazione la qualità deve essere verificata di nuovo. Un modello che richiede meno memoria ma non riconosce più in modo affidabile i termini tecnici non rappresenterebbe un miglioramento per una conferenza specialistica.
Knowledge Distillation: dal modello grande a quello piccolo
Un secondo approccio è la cosiddetta Knowledge Distillation, ovvero una sorta di distillazione della conoscenza. In questo caso un modello più piccolo viene addestrato con l'aiuto di un modello più grande. Il modello grande assume per così dire il ruolo dell'insegnante, quello più piccolo il ruolo dell'allievo.
L'obiettivo è rendere utilizzabili determinate capacità del modello grande in un'architettura più efficiente. Il modello piccolo non deve quindi padroneggiare tutto ciò che sa fare il suo modello di riferimento – ma soprattutto ciò per cui verrà impiegato in seguito.
Perché è rilevante per l'interpretazione simultanea
Tre compiti che si dividono le risorse
Nei sistemi di interpretariato professionali non lavora un singolo modello: occorre svolgere più compiti contemporaneamente. Come interagiscono classicamente queste fasi lo abbiamo descritto in modo più approfondito nell'articolo L'IA può tradurre le emozioni?:
- Riconoscimento vocale: il parlato viene riconosciuto.
- Traduzione: il contenuto riconosciuto viene trasposto nella lingua di destinazione.
- Sintesi vocale: una voce artificiale riproduce la traduzione.
Tutte e tre le fasi competono per le stesse risorse: potenza di calcolo e memoria. E non una volta sola, ma in modo continuo – per tutto il tempo in cui si parla sul palco.
Che cosa possono rendere possibile modelli più efficienti
I modelli più efficienti possono quindi offrire un notevole vantaggio pratico. Se ogni singolo compito richiede meno risorse, si crea margine. Questo margine consente eventualmente:
- più canali linguistici in parallelo, ad esempio quando gli ospiti seguono un evento in più lingue di destinazione,
- requisiti hardware inferiori nella sede dell'evento,
- tempi di elaborazione più brevi, ossia meno distanza tra il discorso originale e la traduzione.
La parola "eventualmente" è scelta di proposito. Quale vantaggio si ottenga effettivamente nella pratica dipende dal singolo modello, dal procedimento di ottimizzazione e dal sistema nel suo complesso – e, come per la quantizzazione, deve essere verificato ogni volta.
IA locale: perché per noi l'efficienza non è una questione teorica
In MILA l'interpretazione simultanea con IA funziona localmente sulla nostra tecnica nella sede dell'evento – senza cloud. Ciò che viene detto non lascia l'evento. Per aziende, associazioni ed enti pubblici, nei cui eventi si affrontano anche temi riservati, questo può essere un aspetto importante.
Il funzionamento locale significa però anche che l'elaborazione avviene sulla tecnica che portiamo con noi. Per questo la domanda su quanta potenza serva a un modello per il suo compito non è per noi solo di interesse accademico.
Per Lei come organizzatore, lo svolgimento resta semplice: ogni lingua arriva su un proprio canale nell'impianto di interpretazione o nella tecnica congressuale già presenti; su richiesta forniamo ricevitori e cuffie per gli ospiti. Chi cerca un interprete per eventi non deve quindi occuparsi di architetture dei modelli – ce ne occupiamo noi.
La prospettiva di MILA: le dimensioni non sono un criterio di qualità
Per MILA non sono decisive le dimensioni di un modello linguistico. Contano quattro criteri:
- Qualità della traduzione: il contenuto arriva nella lingua di destinazione in modo comprensibile e corretto?
- Latenza: quanto tempo passa tra l'originale e la traduzione?
- Stabilità: il sistema funziona in modo affidabile per tutta la durata dell'evento?
- Consumo di risorse: quanta potenza di calcolo e memoria sono necessarie?
Per questo seguiamo con particolare attenzione lo sviluppo di modelli efficienti e di tecnologie di inferenza locale – ovvero dei procedimenti con cui i modelli vengono eseguiti direttamente su hardware proprio.
Altrettanto importante è ciò che si può pianificare indipendentemente dal modello: impostiamo in anticipo i termini tecnici e i nomi propri del programma, e un tecnico di sistema è sempre presente in loco. Pianifica con Lei, allestisce, segue la traduzione durante l'evento e smonta. E poiché anche il miglior modello può tradurre solo ciò che sente, l'audio svolge un ruolo altrettanto importante – maggiori dettagli nel nostro articolo Interpretariato con IA e tecnica audio: perché tutto inizia dal microfono.
Conclusione: l'IA giusta anziché la più grande
I modelli linguistici di piccole dimensioni non sono fini a se stessi. Quantizzazione e Knowledge Distillation possono rendere i modelli più snelli, ma ogni ottimizzazione deve essere misurata sulla qualità. Per l'interpretazione simultanea in congressi, conferenze specialistiche o eventi aziendali, alla fine conta ciò che arriva in sala.
Per le applicazioni professionali, l'IA più interessante non è sempre la più grande – ma quella che svolge il proprio compito in modo affidabile.
Se sta pianificando una traduzione per il Suo prossimo evento, trova tutti i dettagli su tecnica, lingue e svolgimento nella nostra pagina dedicata ai servizi. Le risposte alle domande più frequenti sono raccolte nelle FAQ.
