Blog · 14/08/2026
Modelos de linguagem pequenos: porque é que mais pequeno pode ser melhor na interpretação
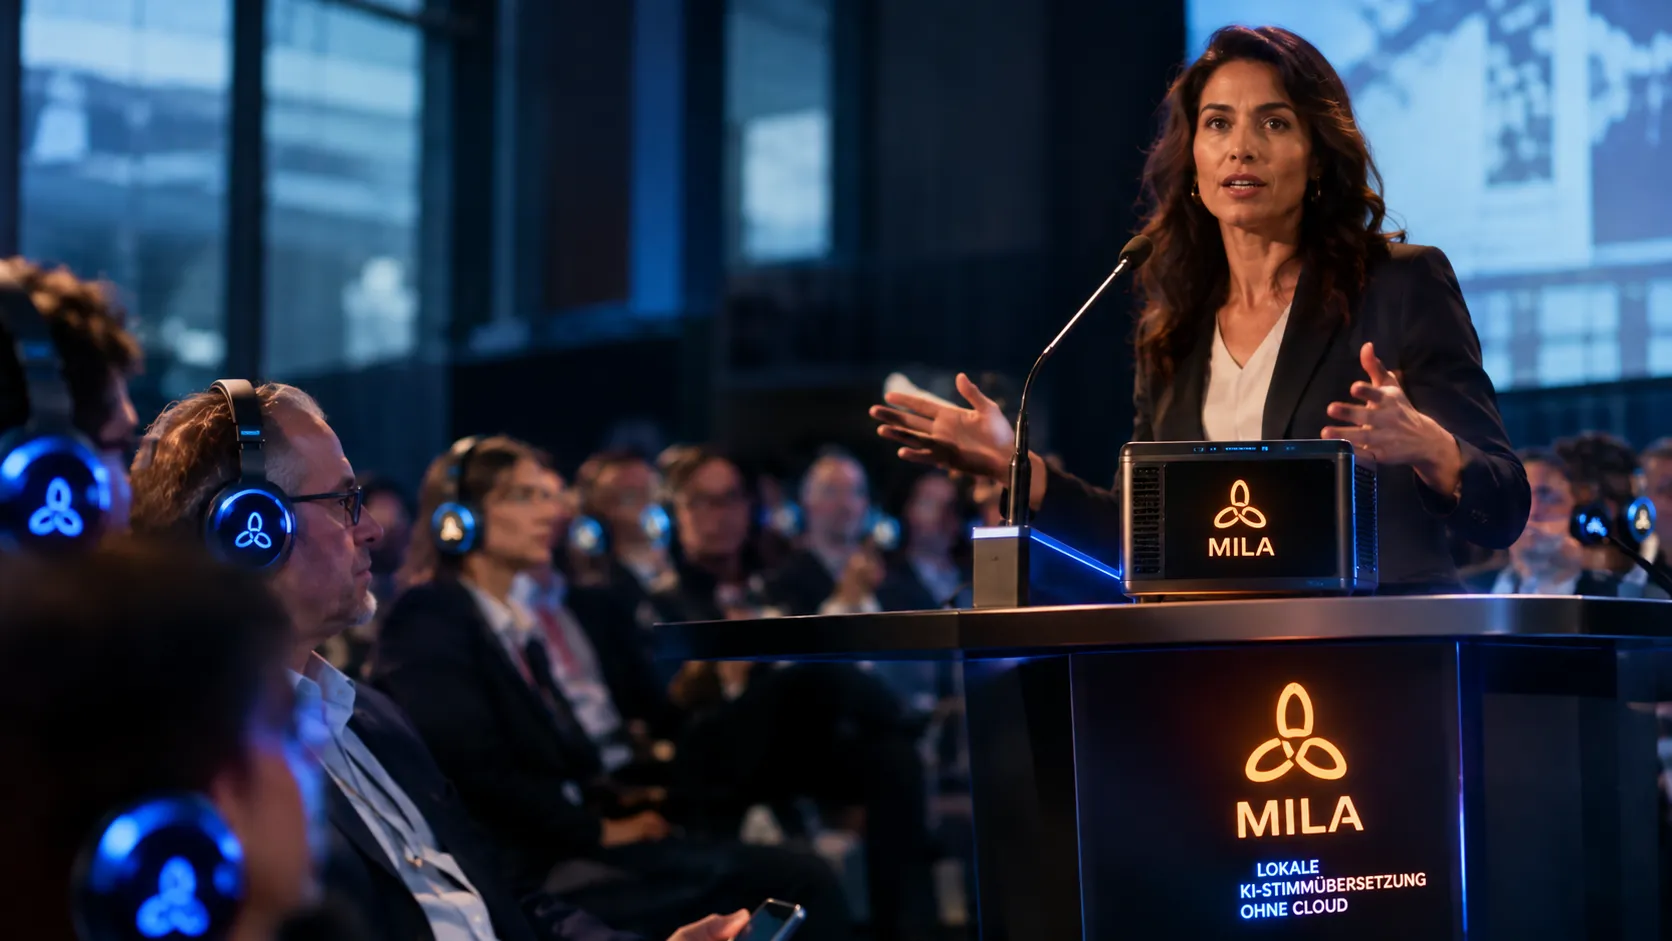
Quando se fala de inteligência artificial, fala-se muitas vezes de superlativos: cada vez mais parâmetros, cada vez mais dados de treino, cada vez mais capacidade de computação. Este caminho permitiu progressos impressionantes. No entanto, para a interpretação simultânea em eventos, coloca-se uma questão diferente e muito prática: quanta capacidade de IA é realmente necessária? É precisamente aqui que entram os modelos de linguagem pequenos. Neste artigo, explicamos por que razão os modelos especializados e otimizados de forma direcionada são interessantes para os sistemas de interpretação, que técnicas estão por detrás deles – e onde estão os limites.
Maior não é automaticamente melhor
O desenvolvimento da inteligência artificial foi durante muito tempo marcado por uma ideia simples: mais parâmetros, mais dados de treino e mais capacidade de computação resultam em modelos mais poderosos. Esta relação não é errada – deu origem a muitas das capacidades que hoje parecem quase óbvias.
Para muitas aplicações práticas, porém, fica aquém. Quem utiliza uma tecnologia no dia a dia não pergunta apenas o que um modelo consegue fazer em princípio. O decisivo é saber se executa uma determinada tarefa de forma fiável – nas condições que efetivamente se verificam. Num evento, isso significa: com a tecnologia disponível no local e enquanto o programa decorre.
Especialização em vez de dimensão máxima
Um modelo de linguagem universal é um generalista. Deve programar, escrever textos, resolver problemas matemáticos e responder a perguntas sobre qualquer tema. Esta amplitude tem o seu preço: um modelo que deve saber fazer tudo tem de reunir em si um número muito grande de capacidades.
Um modelo de reconhecimento de fala ou de tradução tem, pelo contrário, uma missão claramente delimitada. Deve reconhecer a linguagem falada ou transpor uma frase de uma língua para outra. Código de programação ou tarefas matemáticas não fazem parte disso. Por isso, um modelo especializado deste tipo não precisa necessariamente da mesma amplitude de capacidades que um modelo generalista.
Através de uma otimização direcionada, modelos mais pequenos podem ser muito eficazes em determinadas tarefas. Uma comparação da oficina: para um determinado parafuso não é preciso a caixa de ferramentas inteira, mas sim a chave certa.
Como os modelos de linguagem pequenos se tornam mais eficientes
Existem vários métodos para tornar os modelos mais leves. Dois deles desempenham um papel particularmente importante no desenvolvimento atual: a quantização e a Knowledge Distillation.
Quantização: menos precisão, menos memória
Um modelo de linguagem consiste, essencialmente, num número muito grande de valores numéricos, os chamados pesos do modelo. Na quantização, estes pesos são armazenados e processados com menor precisão numérica – de forma simplificada: com números de graduação mais grosseira em vez de números com resolução muito fina.
Isso pode reduzir significativamente as necessidades de memória de um modelo e, consequentemente, os requisitos de hardware.
O método tem, no entanto, um reverso. Consoante o procedimento e o modelo, pode perder-se parte da precisão. Não é possível dizer de forma genérica qual a dimensão dessa perda. Por isso, aplica-se o seguinte: após cada otimização, a qualidade tem de ser verificada novamente. Um modelo que precise de menos memória, mas que deixe de reconhecer de forma fiável os termos técnicos, não seria uma melhoria para uma conferência especializada.
Knowledge Distillation: do modelo grande para o modelo pequeno
Uma segunda abordagem é a chamada Knowledge Distillation, ou seja, uma destilação de conhecimento. Neste processo, um modelo mais pequeno é treinado com a ajuda de um modelo maior. O modelo grande assume, por assim dizer, o papel de professor e o mais pequeno o de aluno.
O objetivo é tornar determinadas capacidades do modelo grande utilizáveis numa arquitetura mais eficiente. O modelo pequeno não tem, portanto, de dominar tudo o que o seu modelo de referência sabe fazer – mas sobretudo aquilo para que será utilizado mais tarde.
Por que razão isto é relevante para a interpretação simultânea
Três tarefas que partilham os recursos
Nos sistemas de interpretação profissionais, não trabalha um único modelo; várias tarefas têm de ser executadas em simultâneo. Descrevemos com mais pormenor a forma como estes passos interagem classicamente no artigo A IA consegue traduzir emoções?:
- Reconhecimento de fala: o discurso falado é reconhecido.
- Tradução: o conteúdo reconhecido é transposto para a língua de destino.
- Síntese de voz: uma voz artificial reproduz a tradução.
Os três passos competem pelos mesmos recursos: capacidade de computação e memória. E não apenas uma vez, mas de forma contínua – enquanto se falar em palco.
O que os modelos mais eficientes podem possibilitar
Por isso, modelos mais eficientes podem oferecer uma vantagem prática considerável. Se cada tarefa individual consumir menos recursos, cria-se margem. Essa margem possibilita eventualmente:
- mais canais de idioma em paralelo, por exemplo quando os convidados acompanham um evento em várias línguas de destino,
- menores requisitos de hardware no local do evento,
- tempos de processamento mais curtos, ou seja, menos intervalo entre o original falado e a tradução.
A palavra «eventualmente» foi escolhida de forma deliberada. A vantagem que efetivamente se obtém na prática depende do modelo em causa, do método de otimização e do sistema como um todo – e tem de ser verificada em cada caso, tal como na quantização.
IA local: por que razão a eficiência não é, para nós, uma questão teórica
Na MILA, a interpretação simultânea por IA funciona localmente, na nossa própria tecnologia no local do evento – sem cloud. O que é dito não sai do evento. Para empresas, associações e instituições públicas em cujos eventos também são abordados temas confidenciais, este pode ser um ponto importante.
No entanto, o funcionamento local também significa: o processamento é feito na tecnologia que levamos connosco. Por isso, a questão de quanta capacidade um modelo precisa para a sua tarefa não é, para nós, apenas de interesse académico.
Para si, enquanto organizador, o processo mantém-se simples: cada língua é enviada num canal próprio para o sistema de interpretação ou a tecnologia de conferência existente e, se o desejar, disponibilizamos recetores e auscultadores para os convidados. Quem procura um intérprete para eventos não tem, portanto, de se ocupar de arquiteturas de modelos – disso tratamos nós.
A perspetiva da MILA: a dimensão não é um critério de qualidade
Para a MILA, o decisivo não é a dimensão de um modelo de linguagem. São relevantes quatro critérios:
- Qualidade da tradução: o conteúdo chega à língua de destino de forma compreensível e correta?
- Latência: quanto tempo decorre entre o original e a tradução?
- Estabilidade: o sistema funciona de forma fiável durante todo o evento?
- Consumo de recursos: quanta capacidade de computação e memória é necessária para isso?
Por isso, acompanhamos com especial atenção o desenvolvimento de modelos eficientes e de tecnologias de inferência local – ou seja, dos métodos com os quais os modelos são executados diretamente em hardware próprio.
Igualmente importante é aquilo que se pode planear independentemente do modelo: configuramos previamente os termos técnicos e os nomes próprios do programa, e está sempre presente um técnico de sistemas no local. Ele planeia consigo, faz a montagem, acompanha a interpretação durante o evento e faz a desmontagem. E como até o melhor modelo só consegue traduzir o que ouve, o som desempenha um papel igualmente importante – saiba mais no nosso artigo Interpretação por IA e tecnologia de áudio: por que razão tudo começa no microfone.
Conclusão: a IA adequada em vez da maior
Os modelos de linguagem pequenos não são um fim em si mesmos. A quantização e a Knowledge Distillation podem tornar os modelos mais leves, mas cada otimização tem de ser avaliada pela qualidade. Na interpretação simultânea em congressos, conferências especializadas ou eventos corporativos, o que conta no final é aquilo que chega à sala.
Para aplicações profissionais, a IA mais interessante nem sempre é a maior – mas sim aquela que cumpre a sua tarefa de forma fiável.
Se está a planear a interpretação para o seu próximo evento, encontra todos os detalhes sobre tecnologia, línguas e processo na nossa página de Serviços. Reunimos as respostas às perguntas frequentes nas FAQ.
